[toc]
系统分析师笔记05_数据库系统
该笔记内容来自《系统分析师教程》第2版。
数据库是长期存储在计算机内的、有组织的、可共享的数据集合。
数据库系统是指在计算机信息系统中引入数据库后的系统,一般由数据库、数据库管理系统(DBMS)、应用系统、数据库管理(DBA)和用户构成。
数据库管理系统
数据库管理系统是一种操纵和管理数据库的大型软件,用于建立、使用和维护数据库。它对数据库进行统一的管理和控制,以保证数据库的安全性和完整性。
简单地说,数据库管理系统是一个能够提供数据录入、修改、查询的数据操作软件。具有数据定义、数据操作、数据存储与管理、数据维护、通信等功能,且能够允许多用户使用。
三级模式
数据库系统的结构划分可以有多种不同的层次或不同的角度,典型的是三级划分法,就是把数据库系统划分为三级模式,在三级模式之间提供两级映射,这两级映射保证了数据库中的数据具有较高的物理独立性和逻辑独立性。
数据库系统的三级模式如图所示,从图中可以看出,数据库系统由外模式、概念模式和内模式三级构成。 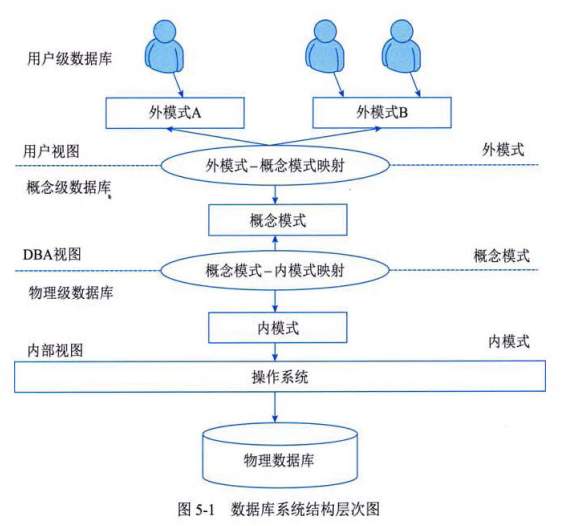
数据库的三级模式结构
- 概念模式(也称模式)。它是数据库中全体数据的逻辑结构和特征的描述,它由若干个概念记录类型组成,只涉及类型的描述,不涉及具体的值。概念模式反映的是数据库的结构和特征。
- 外模式(也称用户模式或子模式)。它是用户与数据库系统的接口,是用户用到的那部分数据的描述,由若干个外部记录类型组成。用户使用数据操作语言对数据进行操作,实际上是对外模式的外部记录进行操作。
- 内模式(也称存储模式),它是数据物理结构和存储方式的描述,是数据在数据库内部的表示方式,定义所有的内部记录类型、索引和文件的组织方式以及数据控制方面的细节。
简而言之,外模式是对接用户的,内模式是对接数据库系统的,而概念模式连接这两者的中间层,它是是用户和数据库系统之间的桥梁。
两级独立性
数据库系统的两级独立性是指物理独立性和逻辑独立性。
数据库系统在三级模式之间提供了两级映像:模式/内模式映像、外模式/模式映像。正因为这两级映像保证了数据库中的数据具有较高的逻辑独立性和物理独立性。
- 模式/内模式映像。该映像存在于概念级和内部级之间,实现了概念模式到内模式之间的相互转换。(物理独立性)
- 外模式/模式映像。该映像存在于外部级和概念级之间,实现了外模式到概念模式之间的相互转换。(逻辑独立性)
数据模型
模型就是对现实世界特征的模拟和抽象,数据模型是对现实世界数据特征的抽象。对于具体的模型人们并不陌生,如航模飞机、地图和建筑设计沙盘等都是具体的模型。
数据模型的三要素是数据结构、数据操作、数据的约束条件。
人们提出过很多种基本数据模型,其中最著名的有层次模型、网状模型、关系模型和面向对象模型。
层次模型
层次模型是最早出现的数据模型,由于它采用了树状结构作为数据的组织方式,在这种结构中,每一个结点可以有多个孩子结点,但只能有一个双亲结点。这样,整体结构也是分层状的,所以称其为层次模型。
层次模型数据库系统的典型代表是IBM公司的IMS数据库管理系统,该系统是1968年推出的,曾经作为大型商用数据库系统被广泛使用。
网状模型
网状模型用有向图表示实体类型和实体之间的联系。
网状模型的优点是记录之间的联系通过指针实现,多对多的联系容易实现,查询效率高;其缺点是编写应用程序比较复杂,程序员必须熟悉数据库的逻辑结构。由图和树的关系可知,层次模型是网状模型的一个特例。
关系模型
关系模型用表格结构表达实体集,用外键表示实体之间的联系。
关系模型建立在严格的数学概念基础上,概念单一、结构简单、清晰,用户易懂易用;存取路径对用户透明,从而数据独立性和安全性好,能简化数据库开发工作。其缺点主要是由于存取路径透明,查询效率往往不如非关系数据模型。
关系模型是目前应用最广泛的一种数据模型,例如,Oracle、DB2、SQL Server、Sybase 和 MySQL等都是关系数据库系统。
面向对象模型
面向对象模型是用面向对象的观点来描述现实世界实体的逻辑组织、对象之间的限制和联系等的模型。
目前,已有多种面向对象数据库产品,但其具体的应用并不多。目前主流的方式是在现有的关系模型数据库系统中增加对对象模型的支持,如Oracle等。
关系数据库
关系数据库是目前应用非常广泛的数据库之一,有一套完整的理论做支持。
关系模型是关系数据库的基础,由关系数据结构、关系操作集合和关系完整性规则三部分组成。
关系数据库的基本术语
关系数据库中涉及的基本术语有:
- (1)属性(Atribute)。在现实世界中,要描述一个事物常常取若干特征来表示,这些特征称为属性。例如,学生用学号、姓名、性别、系别、年龄、籍贯等属性来描述。
- (2)域(Domain)。每个属性的取值范围所对应的值的集合,称为该属性的域。例如,学号的域是6位整型数,性别的域为{男,女}等。
- (3)目或度(Degree)。二维表关系R(D,D2,...D)中的R表示关系的名字,n是关系的目或度。
- (4)候选码(CandidateKey)。若关系中的某一属性或属性组的值能唯一地标识一个元组,则称该属性或属性组为候选码。
- (5)主码(PrimaryKey)。或称主键,若一个关系有多个候选码,则选定其中一个为主码。
- (6)主属性(Prime Attribute)。包含在任何候选码中的属性称为主属性。不包含在任何候 选码中的属性称为非主属性(Nonprime Attribute)。
- (7)外码(ForeignKey)。如果关系模式R中的属性或属性组非该关系的码,但它是其他关系的码,那么该属性集对关系模式R而言是外码。
关系模型
关系模型是最常用的数据模型之一。关系数据库系统就是使用关系模型作为数据的组织方式。
在关系模型中用表格结构表达实体集以及实体集之间的联系,其最大特色是描述的一致性。
关系运算
5种基本的关系代数运算分别为 并,差,笛卡尔积,投影,选择。其他运算包括可以通过基本的关系运算导出。
如图所示 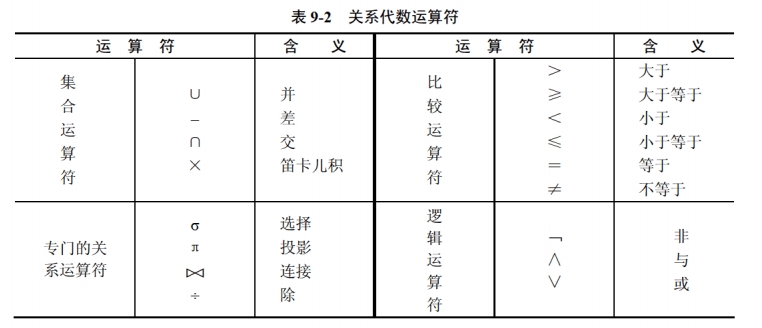
元组演算
暂无
规范化理论
函数依赖与键
范式
范式是一系列规则,用于指导数据库的结构设计,以确保数据的一致性和减少冗余。
范式有1NF、2NF、3NF等,其中1NF 的级别最低。
第一范式(1NF):原子性
第一范式要求表中的所有字段值都是不可分解的原子值,即每个字段都是最小的数据单位,不可再分。
例如,如果一个字段包含了地址信息,而系统需要频繁地单独访问其中的城市部分,则应该将地址拆分为省份、城市、详细地址等多个字段。这样,当需要对地址的某个部分进行操作时,将更加方便,同时也提高了数据库的性能。
第二范式(2NF):唯一性
在满足第一范式的基础上,第二范式进一步要求表中的每个字段都必须与主键完全相关,而不能仅与主键的一部分相关。这主要针对联合主键的情况,即一个表中只能保存一种数据类型,不可以将多种数据类型保存在同一张表中。
例如,订单信息表中可能包含多种商品,因此需要将订单编号和商品编号作为联合主键。如果表中的某些字段只与主键的一部分相关,则违反了第二范式。
第三范式(3NF):独立性
第三范式要求表中的每个字段都必须直接与主键相关,而不能间接相关。也就是说,非主键字段之间不能存在依赖关系,它们必须直接依赖于主键。
例如,如果设计一个订单表,可以将客户编号作为外键与订单表建立关系,而不应在订单表中添加关于客户其他信息的字段。这样,在查询订单信息时,可以使用客户编号引用客户信息表中的记录,避免在订单信息表中重复输入客户信息,从而减少数据冗余。
关系模式分解
暂无
数据库控制功能
要想使数据库中的数据达到应用的要求,必须对其进行各种控制,这就是DBMS的控制功能,包括并发控制、性能优化、数据库的完整性和安全性,以及数据备份与恢复等。
数据库的并发控制
并发操作是指在多用户共享的系统中许多用户可能同时对同一数据进行操作。
并发操作带来的问题是数据的不一致性,主要有三类:丢失更新、不可重复读和读脏数据。其主要原因是事务的并发操作破坏了事务的隔离性。
事务
事务是一个操作序列,这些操作“要么都做,要么都不做”,是数据库环境中不可分割的逻辑工作单位。事务和程序是两个不同的概念,一般一个程序可包含多个事务。
在 SOL语言中,事务定义的语句有以下三条。
- BEGINTRANSACTION:事务开始。
- COMMIT:事务提交。该操作表示事务成功地结束,它将通知事务管理器该事务的所有更新操作现在可以被提交或永久地保留。
- ROLLBACK:事务回滚。该操作表示事务非成功地结束,它将通知事务管理器出故障了,数据库可能处于不一致状态,该事务的所有更新操作必须回滚或撤销。
事务具有原子性、一致性、隔离性和持久性。这4个特性也称事务的 ACID 性质。
- 原子性(Atomicity):一个事务中的所有操作在数据库中要么全做,要么全都不做
- 一致性(Consistency):一个事务执行的结果必须保证数据库从一个一致性状态变到另一个一致性状态。
- 隔离性(Isolation):事务与事务之间相互隔离。当多个事务并发执行时,任一事务的更新操作直到其成功提交的整个过程,对其他事务都是不可见的。
- 持久性(Durability):一旦事务成功提交,即使数据库崩溃,其对数据库的更新操作也将永久有效。
并发操作带来的问题
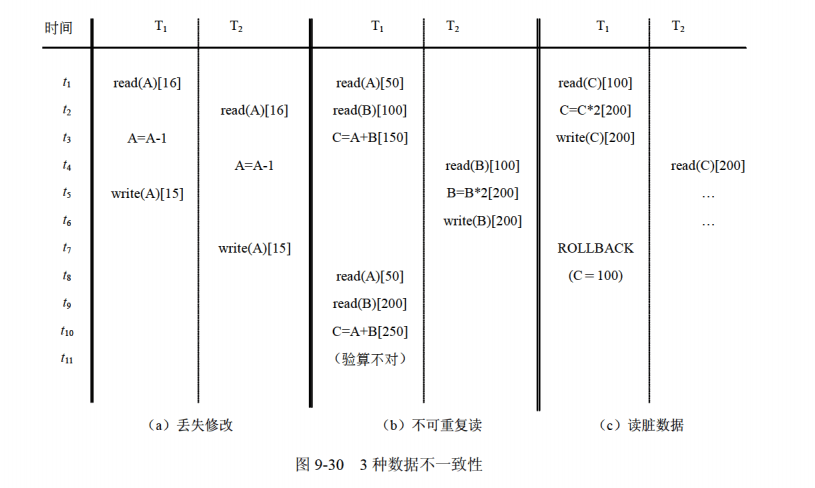
并发操作带来的数据不一致性有三类:丢失修改、不可重复读和读脏数据。如图 9-30 所示。
丢失修改
如图 9-30(a)所示,事务T1、T2都是对数据 A 做减1操作。事务 T1 在时刻t5 把 A 修改后的值 15 写入数据库,但事务T2 在时刻t7再把它对 A 减1后的值 15 写入。两个事务都是对A的值进行减1操作并且都执行成功,但 A 中的值却只减了 1。
例如火车售票系统,T1与T2各售出了一张票,但数据库里的存票却只减了一张,造成数据的不一致。原因在于T1事务对数据库的修改被T2事务覆盖而丢失了,破坏了事务的隔离性。
不可重复读
如图 9-30(b)所示,事务T1 读取 A、B 的值后进行运算,事务T2在 t6 时刻对 B的值做了修改以后,事务T1又重新读取 A、B的值再运算,同一事务内对同一组数据的相同运算结果不同,显然与事实不相符。同样是事务T2干扰了事务T1的独立性。
读脏数据。
如图 9-30(c)所示,事务T1 对数据C 修改之后,在t3时刻事务T2读取修改后的 C 值做处理,之后事务 T1 回滚,数据C恢复了原来的值,事务T2对C所做的处理是无效的,它读的是被丢掉的垃圾值。
在上面的例子中,在事务并行处理的过程中对相同数据进行访问会导致了数据的不一致性,解决该问题可以从保证事务的隔离性入手。并发控制技术
有多种技术用来解决并发操作带来的数据不一致性问题,主要有封锁等。
并发控制的主要技术是封锁。封锁的类型有排它锁(简称X锁或写锁)和共享锁(简称S锁或读锁)。
封锁的类型
- 排他锁(X/写锁)。若事务T对数据对象 A加上X锁,则只允许事务T读取和修改 A,其他事务都不能再对 A 加任何类型的锁,直到事务T释放 A上的锁。
- 共享锁(S/读锁)。若事务T对数据对象 A 加上S锁,则只允许事务T读取 A,但不能修改 A,其他事务只能再对A加S锁,直到事务T释放A 上的S锁。这就保证了其他事务可以读 A,但在事务 T 释放A上的S锁之前不能对A进行任何修改。
三级封锁协议
- 一级封锁协议。:修改数据前先加 X 锁,事务结束后释放,可解决丢失修改问题。
- 二级封锁协议。在一级基础上,读数据之前加 S 锁,读完后释放即可。二级封锁协议可以解决读脏数据的问题。但是由于二级封锁协议读完了数据后即可释放S锁,所以不能保证可重复读。
- 三级封锁协议。在一级基础上,读数据之前加 S 锁,直到事务结束后释放 S 锁,即可解决丢失修改、读脏数据、不可重复读三个数据不一致的问题。
总结
| 级别 | 操作 | 解决问题 |
|---|---|---|
| 一级封锁协议 | 事务修改数据前加X锁,事务结束释放 | 即可解决丢失修改问题。 |
| 二级封锁协议 | 一级基础上+读前加S锁,读完释放 | 即可解决丢失修改、读脏数据问题。 |
| 三级封锁协议 | 一级基础上+读前加S锁,事务结束释放 | 即可解决丢失修改、读脏数据、不可重复读三个数据不一致的问题。 |
数据库的完整性
数据库的完整性是指数据库中数据的正确性和相容性。
数据库的完整性由各种各样的完整性约束来保证,完整性约束可以通过DBMS或应用程序来实现,基于DBMS的完整性约束作为关系模式的一部分存入数据库中。
数据库的安全性
数据库系统的安全性在技术上依赖于两种方式:
- 一种是DBMS本身提供的用户身份识别、视图、使用权限控制和审计等管理措施,大型DBMS均有此功能。
- 另一种就是靠应用程序来实现对数据库访问进行控制和管理,也就是说,数据的安全控制由应用程序里面的代码来实现。
如图所示。 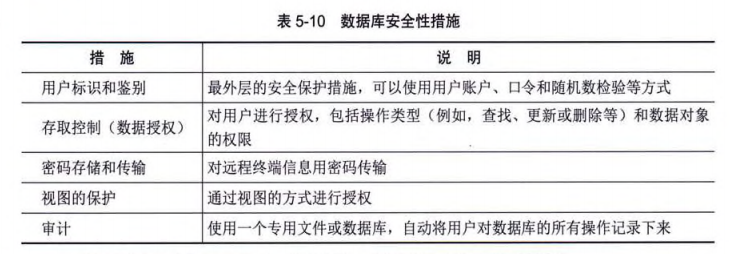
备份与恢复技术
数据库备份有多种分类方式。
- 按备份的实现方式,可分为物理备份与逻辑备份,而物理备份又可以分为冷备份与热备份。
- 按备份的数据量情况,可分为完全备份、增量备份与差异备份。
- 其中,完全备份是指将整个数据库中的数据进行备份;
- 增量备份是指备份上一次备份(包括完全备份、增量备份和差异备份)后发生变化的数据;
- 差异备份是指备份上一次完全备份后发生变化的所有数据。
数据库性能优化
通常,对一个集中式数据库的性能进行优化,可以从硬件升级、数据库设计、索引优化策略和查询优化等方面入手。
硬件升级
要提升数据库的运行速度,最直接的方式就是硬件升级,涉及的硬件包括处理器、内存、磁盘子系统和网络。
数据库设计
在进行数据库设计时可以考虑合理增加冗余属性,以提升系统性能,常用的措施如下:
- (1)将常用的计算属性(例如,总计和最大值等)存储到数据库实体中。
- (2)重新定义实体,以减少外部属性数据或行数据的开支。
- (3)将关系进行水平或垂直分割,以提升并行访问度。
索引优化策略
索引是提高数据库查询速度的利器,而数据库查询往往是数据库系统中最频繁的操作,因此,索引的建立与选择对数据库性能优化具有重大意义。
索引的建立与选择可遵循以下准则:
- (1)建立索引时,应选用经常作为查询,而不常更新的属性。避免对一个经常被更新的属性建立索引,因为这样会严重影响性能。
- (2)一个关系上的索引过多会影响UPDATE、INSERT和DELETE的性能,因为关系一旦进行更新,所有的索引都必须跟着做相应的调整。
- (3)尽量分析出每个重要查询的使用频率,这样可以找出使用最多的索引,然后可以先对这些索引进行适当的优化。
- (4)对于数据量非常小的关系不必建立索引,因为对于数据量小的关系而言,关系扫描往往更快,而且消耗的系统资源更少。
查询优化
查询优化也称为应用程序优化,它是数据库性能优化的最后一个环节,同时也是最重要的一个环节。查询语句的构造不当,会使之前的优化功亏一篑。
SQL语句优化的策略很多,例如,建立视图或尽可能减少多表查询;以不相干子查询替代相干子查询;只检索需要的属性;用带IN的条件子句等价替换OR子句;经常提交(COMMIT),以尽早释放锁等。
数据库设计与建模
数据库设计阶段
基于数据库系统生命周期的数据库设计可分为如下5个阶段:规划、需求分析、概念设计、逻辑设计和物理设计。
规划
规划阶段的主要任务是进行建立数据库的必要性及可行性分析,确定数据库系统在企业和信息系统中的地位,以及各个数据库之间的联系。
需求分析
需求分析的目标是通过调查研究,了解用户的数据和处理要求,并按一定格式整理成需求说明书。
需求说明书包括数据库所涉及的数据、数据的特征、使用频率和数据量的估计,例如,数据名、属性及其类型、主键属性、保密要求、完整性约束条件、更改要求、使用频率和数据量估计等。
概念设计
概念设计也称为概念结构设计,其任务是在需求分析阶段产生的需求说明书的基础上,按照特定的方法将它们抽象为一个不依赖于任何DBMS的数据模型,即概念模型。
逻辑设计
逻辑设计也称为逻辑结构设计,其任务是将概念模型转化为某个特定的DBMS上的逻辑模型。
物理设计
理设计也称为物理结构设计,其任务是对给定的逻辑模型选取一个最适合应用环境的物理结构,所谓数据库的物理结构,主要是指数据库在物理设备上的存储结构和存取方法。
实体联系模型(E-R模型)
E-R模型也称为E-R图,它是描述概念世界、建立概念模型的实用工具。在E-R图中,主要包括以下三个要素:
- 实体:是现实世界中可以区别于其他对象的“事件”或“物体”。每个实体由一组特性(属性)来表示,其中的某一部分属性可以唯一表示实体。实体集是具有相同属性的实体集合。例如教师是一个实体,而学校的所有教师是一个实体集。
- 联系:实体集之间的对应关系称为联系。实体的联系分为实体内部的联系和实体与实体之间的联系。
- 属性:是实体某方面的特性。例如,职工实体具有职工号、姓名、年龄、参加工作时间和通信地址等属性。每个属性都有其取值范围。在同一个实体集中,每个实体的属性是相同的,但可能取不同的值。
分布式数据库系统
分布式数据库系统是数据库技术与网络技术相结合的产物,其基本思想是将传统的集中式数据库中的数据分布于网络上的多台计算机中。
分布式数据库系统通常使用较小的计算机系统,每台计算机可单独放在一个地方,每台计算机中都有DBMS的一份完整的复制副本,并具有自己局部的数据库,位于不同地点的许多计算机通过网络互相连接,共同组成一个完整的、全局的大型数据库。
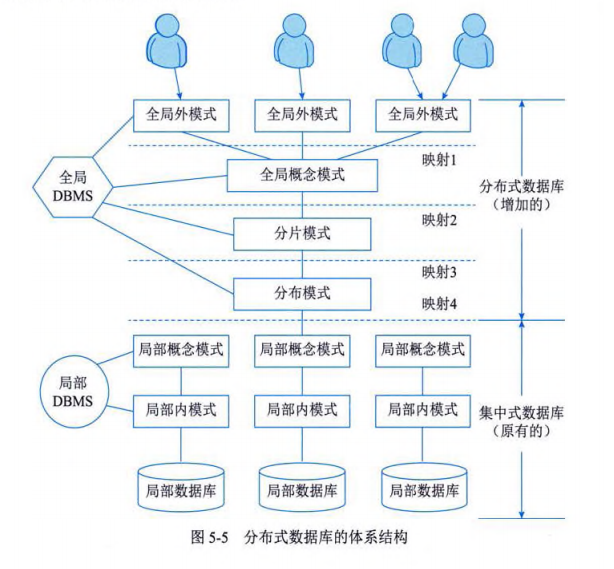
分布式数据库的体系结构
分布式数据库的体系结构如图所示。
数据仓库技术
数据仓库是一个集成的、相对稳定的、反映历史变化的数据集合,用于支持管理决策。
如图所示为数据仓库的体系结构。 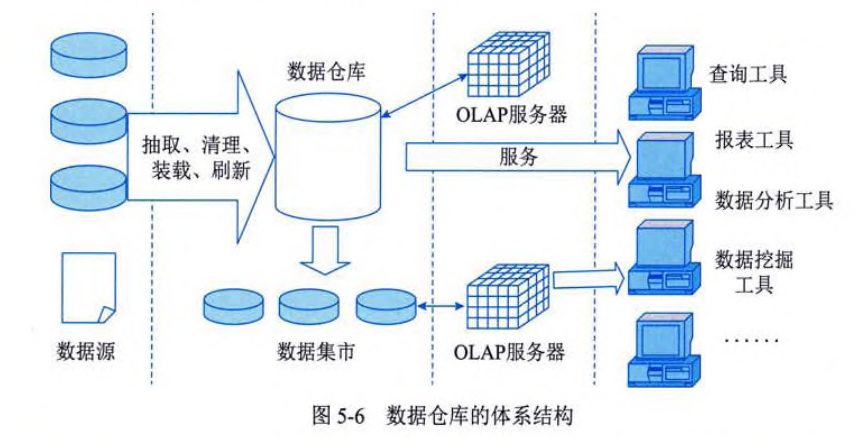
数据挖掘技术
数据挖掘是采用数学的、统计的、人工智能和神经网络等领域的科学方法,从大量数据中挖掘出隐含的、先前未知的、对决策有潜在价值的关系、模式和趋势,并用这些知识和规则建立用于决策支持的模型,为商业智能系统服务的各业务领域提供预测性决策支持的方法、工具和过程。
数据挖掘的体系结构
如图所示为数据挖掘的体系结构。它展示了数据挖掘的流程,说明了数据挖掘是怎样找到新规律的。 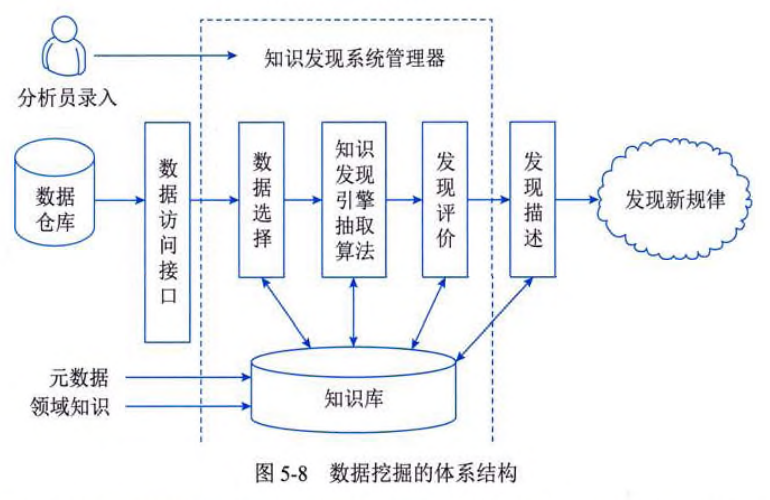
非关系数据库
NoSQL是非关系数据存储的广义定义,它打破了长久以来关系数据库与ACID理论大一统的局面。
NoSQL数据存储不需要固定的表结构,通常也不存在连接操作,在大数据存取上具备关系数据库无法比拟的性能优势。
概述
NoSQL数据库并没有统一的模型,而且是非关系型的。常见的NoSQL数据库通过存储方式划分,可分为文档存储、键值存储、列存储和图存储。
文档数据库
文档存储一般用类似JSON的格式存储,存储的内容是文档型的。
面向文档的数据库具有以下特征:即使不定义表结构,也可以像定义了表结构一样来使用。
面向文档的数据库可以通过复杂的查询条件来获取数据。虽然不具备事务处理和JOIN等关系数据库所具有的处理能力,但其他的处理基本都可以实现。
键值数据库
键值存储模型是最简单也是最方便使用的数据模型,它支持简单的键对值的键值存储和提取。根据一个简单的字符串(键)能够返回一个任意类型的数据(值)。
键值存储最大的好处是不用为值指定一个特定的数据类型,这样就能在值里存储任意类型的数据。键值存储数据库的主要特点是具有极高的并发读写性能。
键值存储中的键是很灵活的,可以是图片名称、网页URL或者文件路径名,它们指向那些图片、网页和对应的文档。
图数据库
图数据库对于那些对象之间具有复杂关系的业务问题很有用,如社交网络、规则引擎、生成组合和那些需要快速分析复杂网络结果并从中找出模式的图系统。
图存储是一个包含一连串的节点和关系的系统,当它们结合在一起时,就构成了一个图。图存储有三个字段:节点、关系和属性。图节点通常是现实世界中对象的表现,如人名、组织、电话号码、网页或计算机节点。而关系可以被认为是这些对象之间的联系,通常被表示为图中两个节点之间连接线。
如果图存储的节点众多、关系复杂、属性很多,那么传统的关系数据库将要建很多大型的表,并且表的很多列可能是空的,在查询时还极有可能进行多重SQL语句的嵌套。可是图存储就可以很优异,基于图的很多高效的算法可以大大提高执行效率。