[toc]
AI图像生成模型笔记
模型网站
模型网站是可以提供用户下载模型的网站。用户可以在网站上找到不同的模型,根据自己的需求选择下载。
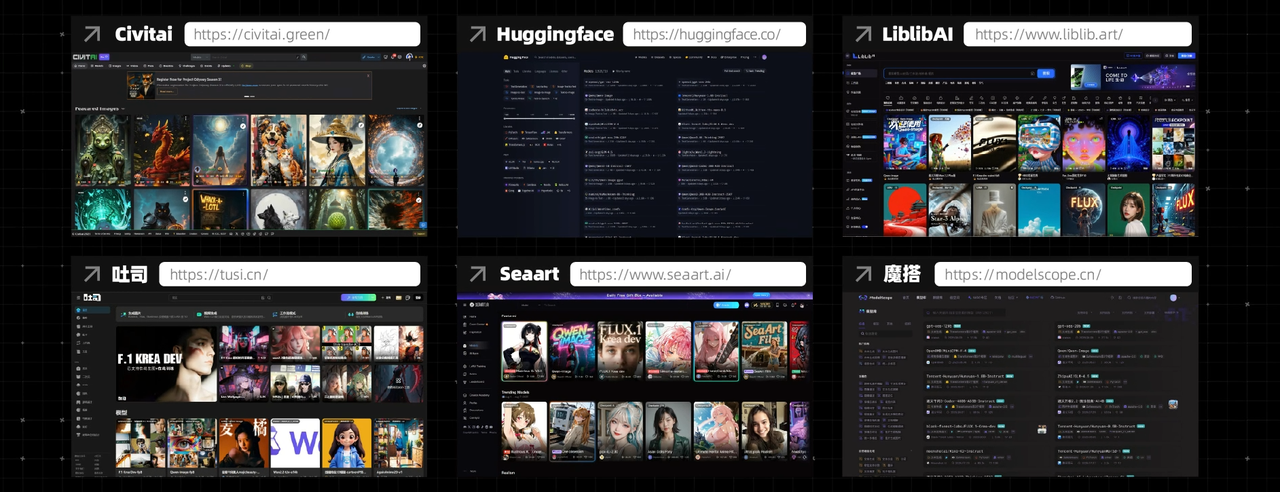
Hugging Face 模型网站(通用模型)
Hugging Face官网:https://huggingface.co/
Hugging Face是全球最大 AI 开源模型仓库、AI 界 GitHub,行业标准模型托管平台,几乎所有主流开源模型都会首发于此。
在Hugging Face 模型网站中可以 下载 checkpoint 文件、复现模型、在线验证、二次开发、托管模型。
如图是 Hugging Face 模型网站的截图,用户可以在网站上找到不同的模型,根据自己的需求选择下载。 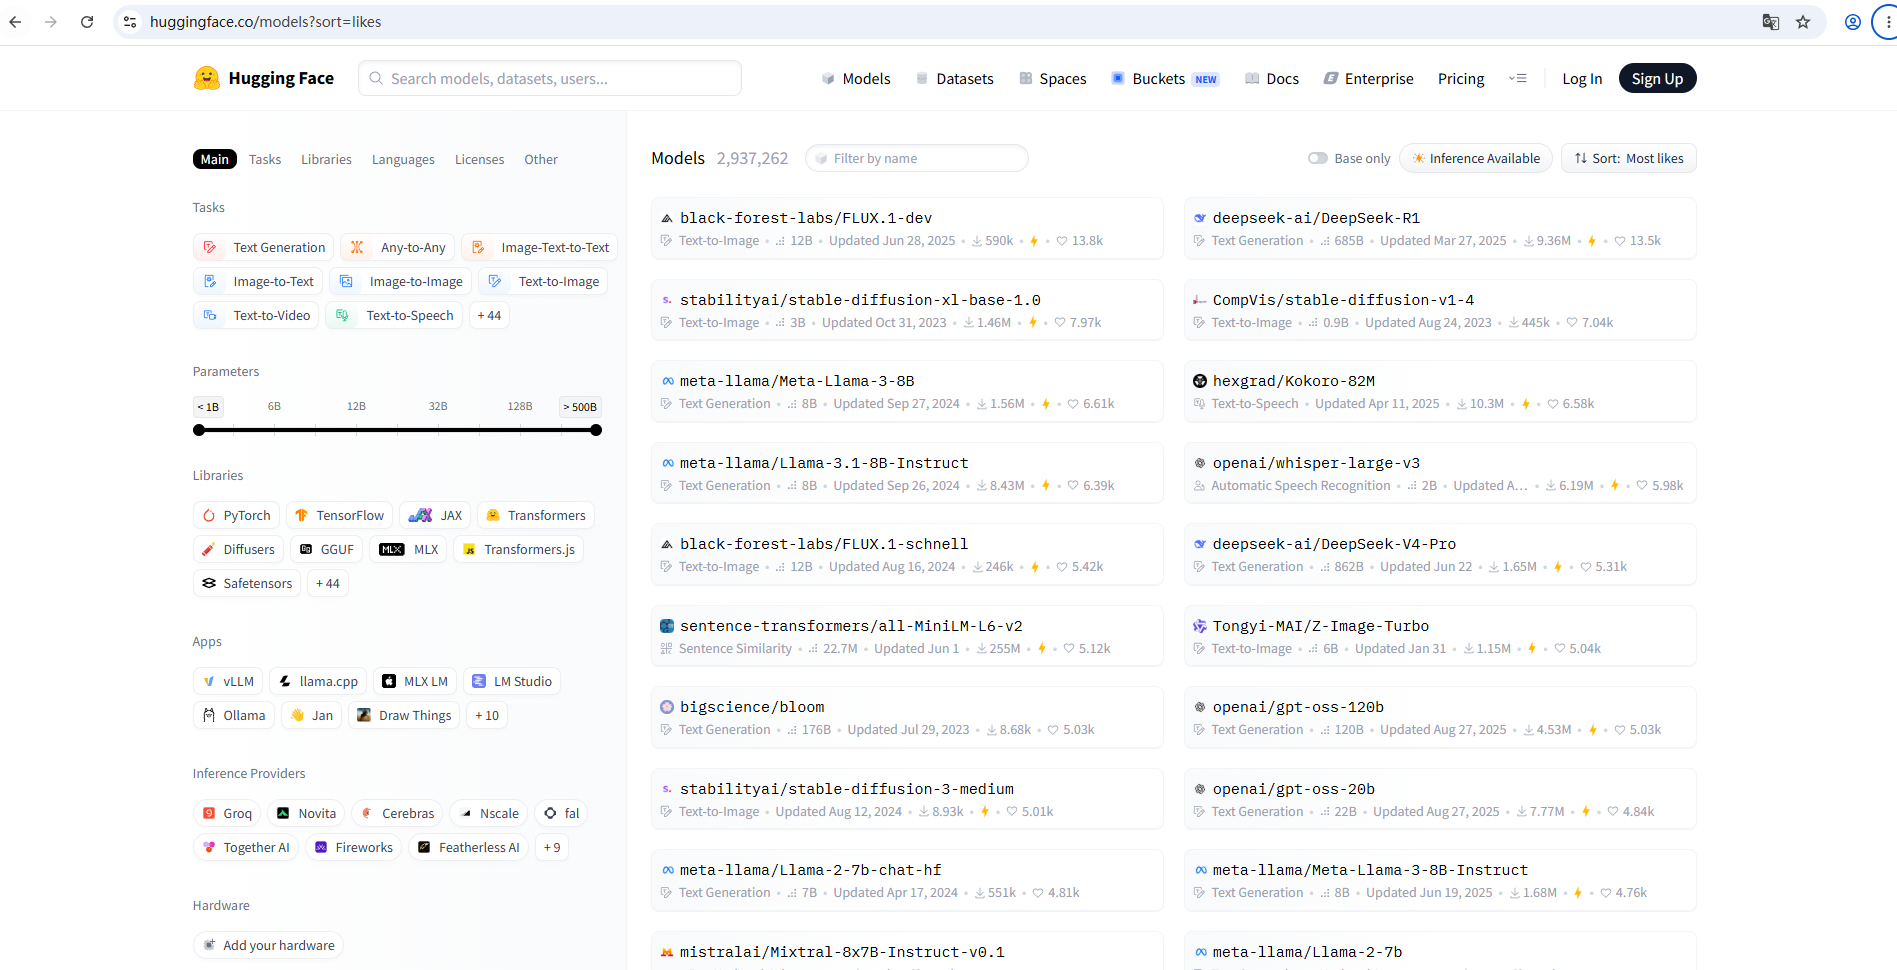
Civitai 模型网站(海外,AI 绘画模型)
Civitai官网:https://civitai.com/
Civitai 是全球最大 AI 绘画模型社区(海外)。该网站包含海量 SD/Flux 等文生图模型、Checkpoint 底模、LoRA、ControlNet、VAE、Embedding 等 AIGC 视觉模型。
适用人群:AI 绘画创作者、二次元 / 写实风格模型爱好者、Stable Diffusion 用户
如图是 Civitai 模型网站的截图,用户可以在网站上找到不同的模型,根据自己的需求选择下载。 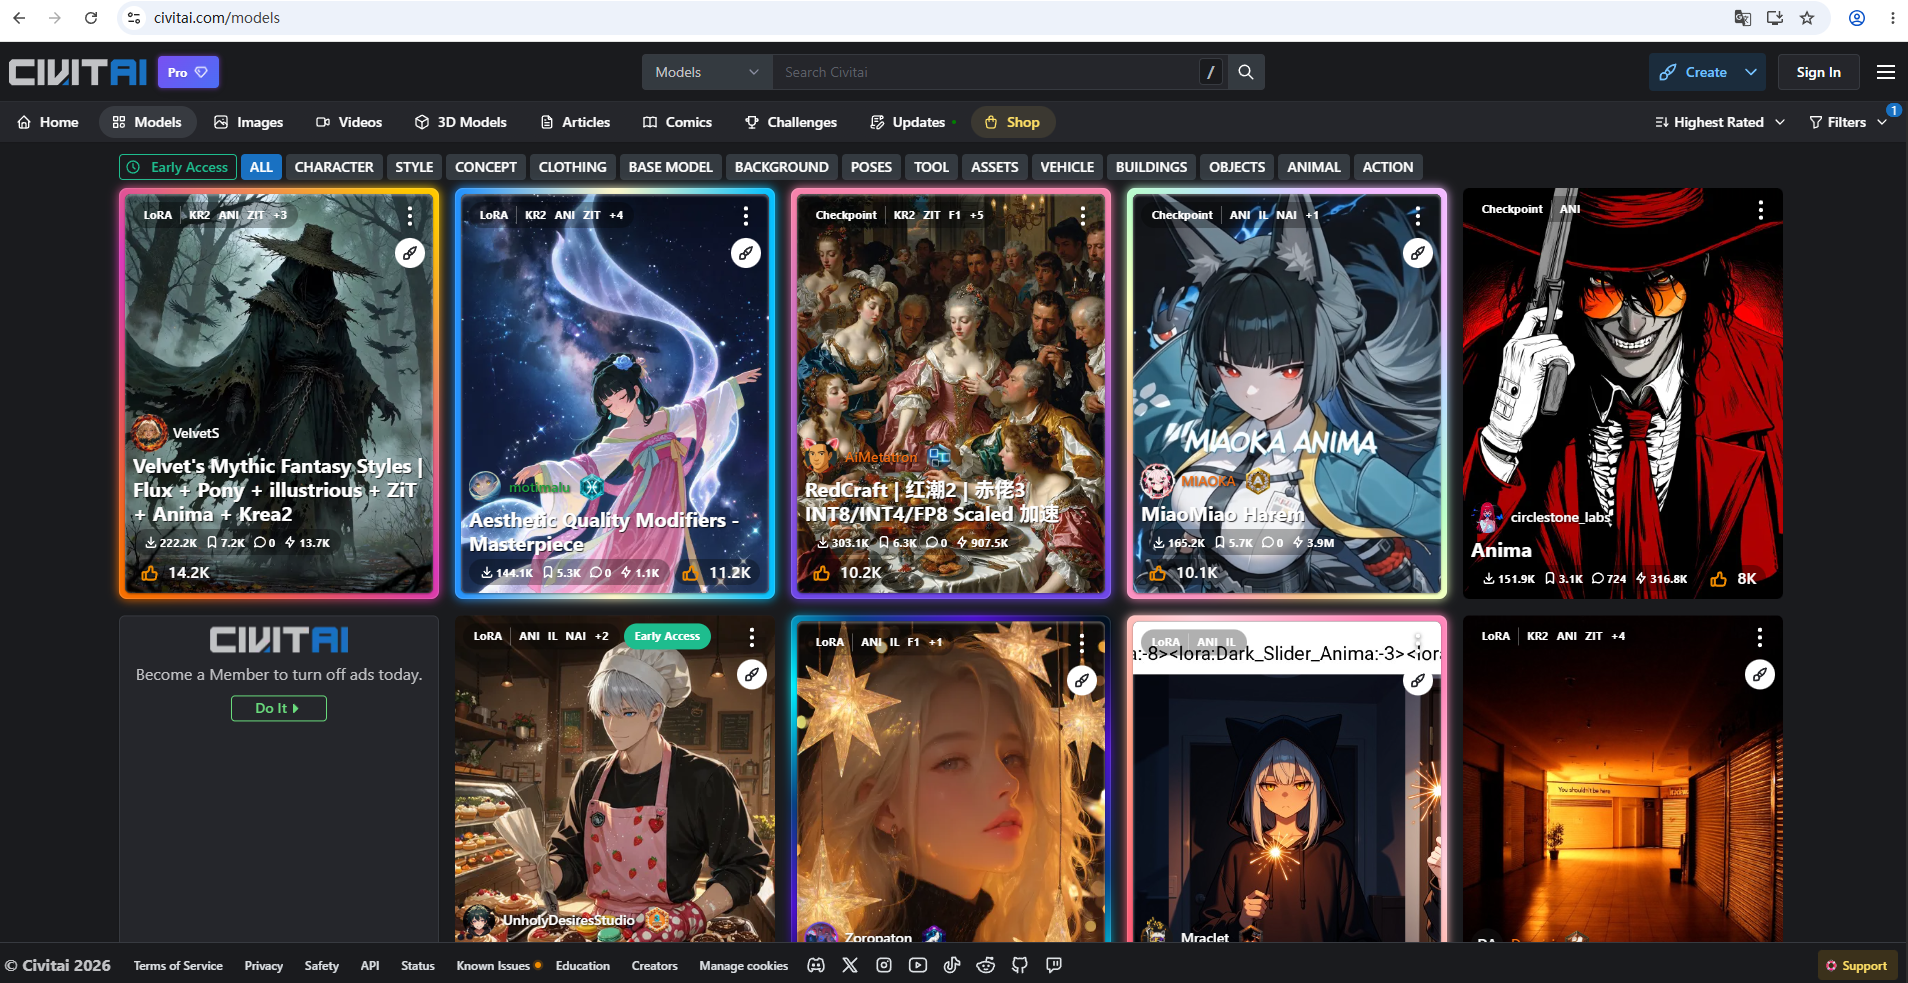
LiblibAI(哩布哩布 AI)
LiblibAI 是一个国内主流 AI 绘画 & 视频模型社区。该网站包含海量 AI 模型,主要适配中文生态、可直接在线生成,主打图像 / 视频创意模型。
ModelScope 魔搭社区
ModelScope官网:https://modelscope.cn/
ModelScope 魔搭社区是国内主流 AI 模型开源社区(阿里达摩院联合 CCF)
该网站包含海量中文模型(通义千问 Qwen、ChatGLM、百川、DeepSeek 等),兼顾海外主流模型镜像;一键推理、微调、模型部署、MaaS 服务、免费算力体验;中文文档完善、国内高速下载。
图像生成模型简史
AI图像生成技术的发展大致经历了三个阶段:
第一阶段:GAN时代(2014-2020)
- GAN(生成对抗网络)是最早实现图像生成的技术
- 原理:两个网络相互对抗——生成器生成假图像,判别器区分真假
- 代表模型:DCGAN、StyleGAN、ProGAN
- 局限:训练不稳定,容易生成模糊或畸形图像
第二阶段:VAE时代(2013-2022)
- VAE(变分自编码器)通过编码-解码方式生成图像
- 原理:先将图像压缩到潜在空间,再从潜在空间还原
- 代表模型:VAE、β-VAE
- 局限:生成质量不如GAN,图像不够清晰
第三阶段:Diffusion时代(2020-至今)
- Diffusion(扩散模型)通过逐步去噪生成图像
- 原理:从随机噪声开始,逐步去除噪声生成清晰图像
- 代表模型:Stable Diffusion、DALL-E、MidJourney、Flux
- 优势:生成质量高,训练稳定,可控性强
目前主流的AI图像生成模型几乎都基于Diffusion架构。
图像生成模型谱系
基底模型与微调模型
| 概念 | 类比 | 说明 |
|---|---|---|
| 基底模型 | 编程语言的基础语法 | 官方发布的原始模型,功能通用但不专精 |
| 微调模型 | 基于基础语法的框架/库 | 在基底模型上用特定数据集训练和微调优化,专精某一领域 |
基底模型就像Python语言本身,微调模型就像Django、Flask这样的框架,是在基础之上的专业化封装。
模型关系图
基底模型举例:
- Stable Diffusion 1.5:最基础的Diffusion模型,资源需求低,社区生态成熟。由Stability AI开发。
- Stable Diffusion XL:升级版,支持更高分辨率和更好的细节,由Stability AI开发。
- Stable Diffusion 3:最新版,支持多模态输入,由Stability AI开发。
- Flux:新一代模型,生成质量极高。开源,社区支持良好。由Black Forest Labs(黑森林实验室)开发。
- DALL-E:基于Transformer架构,生成质量高。由OpenAI开发。闭源模型
- MidJourney:基于Diffusion架构,生成质量高,训练稳定。社区生态成熟。闭源模型
微调模型举例:
- Flux.1-schnell:基于Flux 1.0微调,生成质量极高,速度较快
- Flux.1-dev:基于Flux 1.0微调,生成质量极高,速度较慢
- SD 3 Turbo:基于SD 3微调,支持多模态输入,生成质量极高。
- Anything V4.5:基于SD 1.5微调,专精动漫风格。
- MeinaMix:基于SD 1.5微调,专精动漫风格。
- Realistic Vision:基于SD 1.5/SDXL微调,专精写实风格。
- Juggernaut XL:基于SDXL微调,综合能力强。
模型类型
模型是指通过海量数据 + 学习算法训练而来,得到的一个神经网络模型。以模型文件的形式存储。
通过给模型不断地喂养数据,模型会学习到数据的规律和特征。这些规律和特征会被存储在模型文件上。
即模型文件存储的不是训练数据本身,而是从训练数据上提取出来的规则和特征。调用模型就是通过模型参数来激发出模型内部的这些规则和特征,从而让模型生成新的数据。
基底模型
基底模型: 基底模型是官方发布的原始模型。就像编程语言的基础语法,功能通用但不专精。
微调模型
微调模型: 模型微调是指在已有的基底模型的基础上,通过给基底模型训练特定数据集来改进模型的性能。从而让基底模型能够专精某一领域。
如图所示 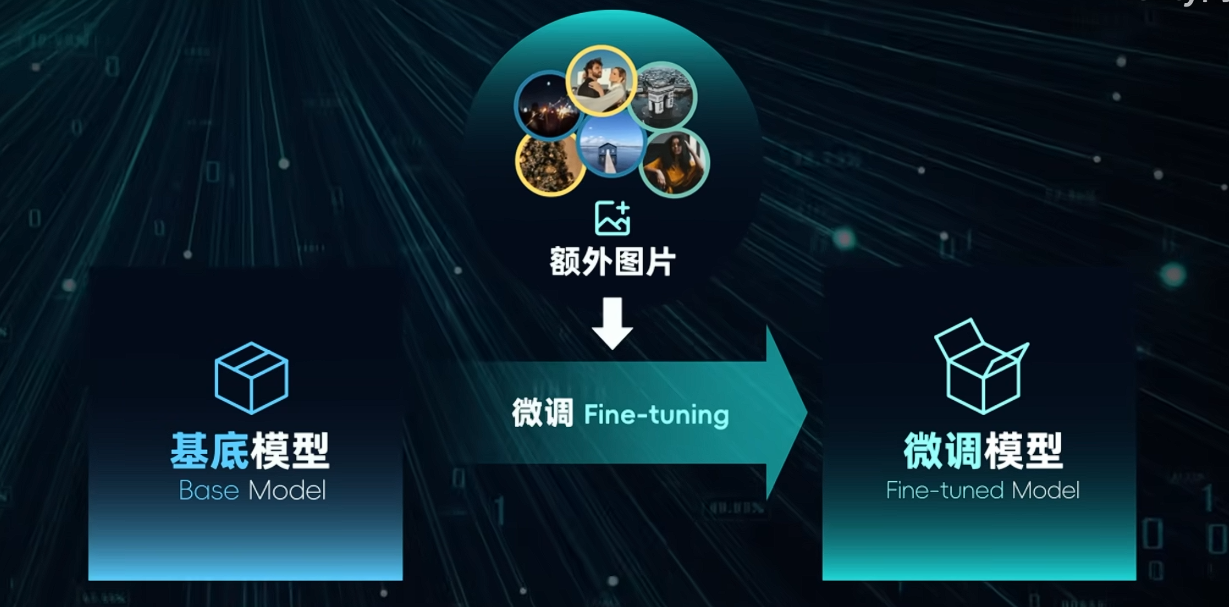
checkpoint 模型
什么是checkpoint 检查点?
checkpoint 是计算机专业术语。最早用于定期保存计算机程序的运行状态,防止断电、死机、服务器中断导致程序作废,可从检查点继续运行,不必从头跑。
checkpoint 类似游戏存档、马拉松打卡点:通过备份计算机程序的运行状态,记录程序的进度,方便程序后续恢复。
当我们再进行模型训练和模型微调时。由于模型的参数量很大,训练时间也很长。因此为了保存模型的训练进度,会定期对模型进行备份处理。这些备份保存下来的模型文件就是 checkpoint 模型文件。
注意:每一个 checkpoint 模型文件都是一个独立的完整的模型文件。因此可以将checkpoint 模型理解为大模型在不同时期下的备份。
checkpoint模型文件的作用
- 故障恢复续训:中断后可加载最近 checkpoint 检查点,从而继续训练,避免从头重来、浪费算力。
- 保存模型训练进度:防止断电、死机、服务器中断导致模型训练失败。
- 模型版本留存:保存不同轮次、最佳验证效果的 checkpoint,挑选最优版本部署。
- 模型审计与回溯:留存训练版本,方便排查模型效果问题、做版本管理
- 方便后续的微调,无需从头开始训练。
简而言之,checkpoint 就是模型在不同时期的存档备份文件;名字源自通用计算机长任务断点存档技术,被深度学习沿用解决长时大模型训练的中断风险与版本管理问题。
如何生成 checkpoint 文件
- ① 通过对模型进行微调训练,生成一个新的模型。就可以导出为 checkpoint 文件。
- ② 通过对多个模型进行融合训练,生成一个新的模型。就可以导出为 checkpoint 文件。
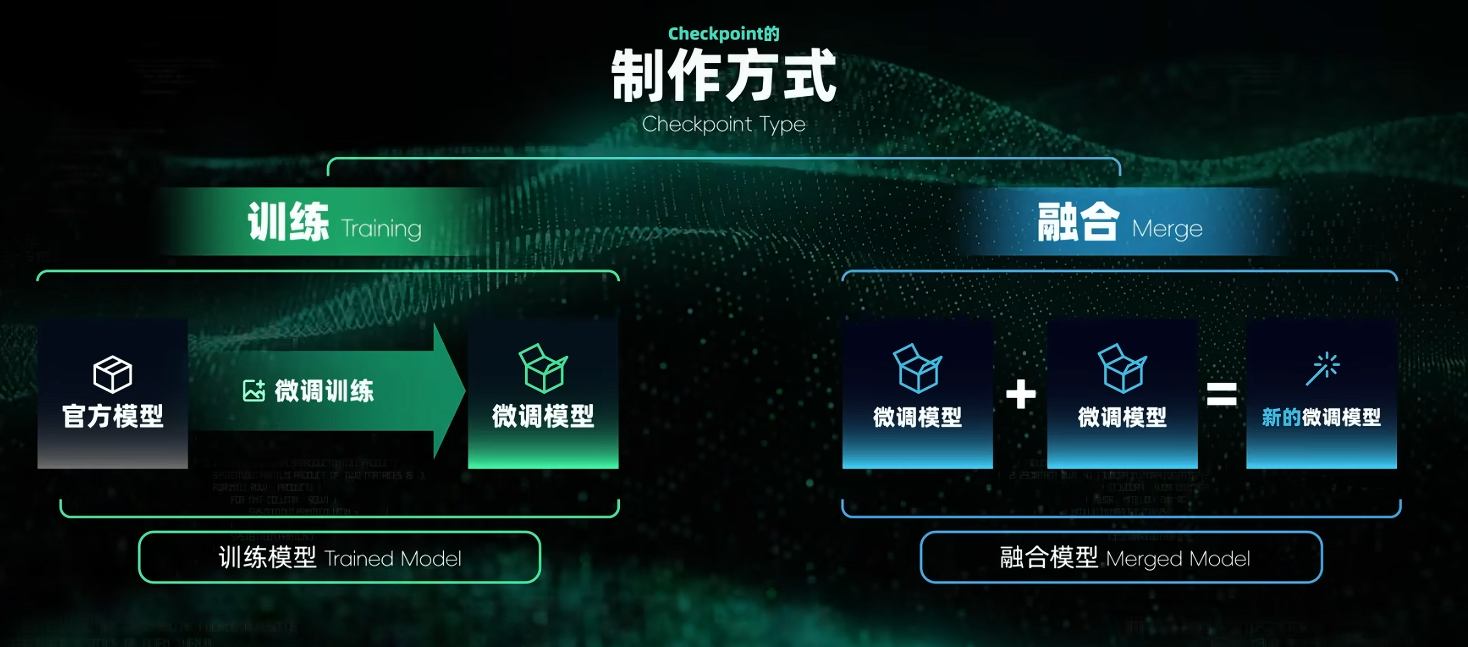
checkpoint 文件内容(.ckpt 文件后缀格式)
注意:每一个 checkpoint 模型文件都是一个独立的完整的模型文件。因此可以将checkpoint 模型理解为大模型在不同时期下的备份。
一个完整 checkpoint 文件包含以下:
- 模型权重参数(模型参数的权重和偏置)
- 训练状态(模型的训练进度、损失函数值等)
- 其他元数据(如模型名称、训练配置等)
- 其他可执行代码(如模型推理代码、训练代码等)
- ....
这些内容会被压缩存储在 checkpoint 模型文件中。当需要对继续训练时,会从 checkpoint 模型文件中提取模型参数和训练状态,从而恢复模型的运行状态。
注意:checkpoint 模型文件的后缀是 .ckpt
模型权重参数文件(.safetensors 文件后缀格式)
由于大多数使用模型的情况下,我们只需要用到模型的权重参数,其他数据用不到。因此目前的主流做法是将 checkpoint 模型文件转换为 .safetensors 文件格式。
.safetensors 文件是从完整 checkpoint 文件里提取、精简、转换出来的模型参数权重版本。整个.safetensors文件 只保留模型权重参数,没有其他相关数据等。
同时 .safetensors 文件由于去掉了优化器、训练日志、元信息等多余内容,因此是一种体积更小、加载更快的文件格式。它无法用于模型训练,只能用于模型推理。
==我们通常从模型网站上下载的模型文件都是 .safetensors 文件格式的。==
Checkpoint 模型的三个组件
一个完整的Checkpoint 模型通常会包含以下三个组件:
- UNet(扩散主干模型):负责图像生成
- CLIP(文本编码器):负责将文本和图像转化为数字向量
- VAE(变分自编码器):负责图像编码和解码
在SD1.5 时代绝大多数图像生成模型都是 Checkpoint 格式(即模型内部包含这三个组件)。但是随着新模型(SDXL、Wan、Qwen 等)的参数规模越来越大,打包成一个 Checkpoint 格式的模型文件太臃肿,也不方便单独升级某个组件。
因此目前的主流做法是将图像生成模型拆分成三个独立的组件文件。把UNet、CLIP、VAE 拆成三个独立的 .safetensors 文件,三个文件组合起来才是一个完整的Checkpoint 模型。
为什么新一代的模型都改成拆分式?
主要原因如下
- 各个组件可单独优化:某个组件优化了,只需要替换对应文件即可。
- 组件可复用:同一个文本编码器、同一个 VAE,可以给同系列的多个主干模型共用。
- 体积可控:大模型单个文件动辄几十 GB,拆分后每个文件体积更合理,下载、传输、容错性都更好。
注意:目前新一代的图像生成模型的三个组件也不是互相通用的。例如 SD1.5、SDXL、Wan 视频、Qwen 等模型的三个组件不能直接互相搭配。
UNet(扩散主干模型,核心组件)
由于目前主流的图像生成模型都是采用的Diffusion架构,因此 UNet 是图像生成模型中负责图像生成的核心组件。
UNet的工作就是在满是噪点的草稿上,如何一步一步擦掉噪点、画出符合要求的画面。
CLIP(文本编码器)
CLIP(文本编码器)核心能力是把「人类自然语言」和「图像特征」映射到同一套数字语言里。
CLIP(文本编码器)的作用实际有两个。
- 文本编码:将文本描述转换为数字向量。
- 图像编码:把图片也转成同格式的数字向量。
注意:不同的图像生成模型需要搭配各自对应的 CLIP 组件,才能有更好的图像生成效果。错配会直接偏色、模糊、崩坏。
VAE(变分自编码器,图像编码解码组件)
VAE(Variational Autoencoder,变分自编码器)用于负责图像编码和解码的组件。
工作原理:
- 图像编码:将正常 RGB 图像压缩到潜在空间。
- 图像解码:将潜在空间图像还原为 RGB 图像。
通俗解释:VAE 就像一个图像翻译器,在人类能看懂的RGB图像和AI内部使用的潜在空间图像压缩格式之间转换。
常见用途:
- 改善图像颜色和细节
- 修复画面发灰、偏色问题
- 提升图像清晰度
常见 VAE:
kl-f8-anime2:适合动漫风格SDXL VAE:SDXL 模型专用vae-ft-mse-840000-ema-pruned:通用高质量 VAE
注意:不同的图像生成模型需要搭配各自对应的 VAE 组件才能有更好的图像生成效果。错配会直接偏色、模糊、崩坏。
附属扩展
早期如果我们想要给图像生成模型实现更复杂,更定制化的功能。只能对整个模型本体进行微调的手段。
但是随着时代和技术的进步,开发者可以通过对图像模型进行微调,扩展,插件等各个方式,来实现更好的效果。
附属扩展更像是对图像模型的补充和优化。这些附属扩展有的是另一个模型,有的是插件,有的可以独立运行,有的必须依赖于图像模型才能运行。
Embedding 模型(文本嵌入模型,补充扩展模型的文本理解能力)
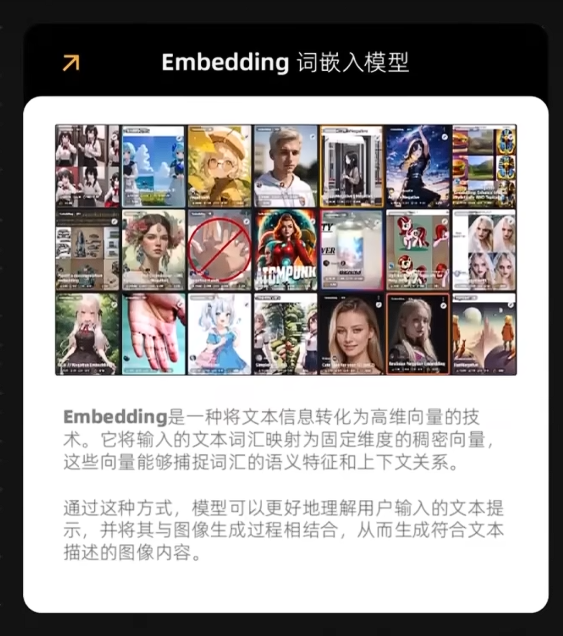
为什么会有Embedding 模型?
早期如果一个图像生成模型出现的时候比较早,那么过了一段时间后,该图像生成模型就可能无法识别新出现的词语。因为该图像生成模型的训练数据中,没有包含新出现的词语。
而如果对图像生成模型进行微调的话,虽然可以识别新出现的词语,但是由于图像生成模型的参数量是很大,微调时间也很长,这样会导致效率太慢。
之后就出现了 Embedding 模型。通过像插件一样的方式,让图像生成模型 搭配 embedding 模型,就可以补充扩展该图像生成模型的文本理解能力,让其识别新出现的词语。
这样的方式比微调更轻量化,效率更高。
通俗解释:Embedding 模型就像给图像生成模型一本新字典,里面收录了一些新词,从而让图像生成模型理解这些新词的含义。Embedding 模型补充扩展了图像生成模型对文本的理解能力。
Embedding 模型的作用
- 优化提示词效果
- 补充扩展模型对文本的理解能力,让模型能够识别新出现的词语。
- 扩展负面提示词,来消除图片的负面效果
- 扩展正面提示词,来增强图片的正面效果
Embedding 模型的工作原理
Embedding 模型的工作原理是通过学习文本与图像之间的关系,将文本转换为向量表示。这些向量表示可以用于生成图像。
然后Embedding 模型本身体积很小,通常只有几 KB ~ 几 MB。因此学习的成本很低,速度也很快。通过少量图片(通常3-10张)训练,就能让Embedding 模型学会一个新的"单词"。
Embedding 模型无法独立运行,需要依赖于对应的 图像生成模型。然后通过这种方式,从而让图像生成模型理解文本的含义。
Lora 模型(低秩适配模型,强化模型的图像生成能力)
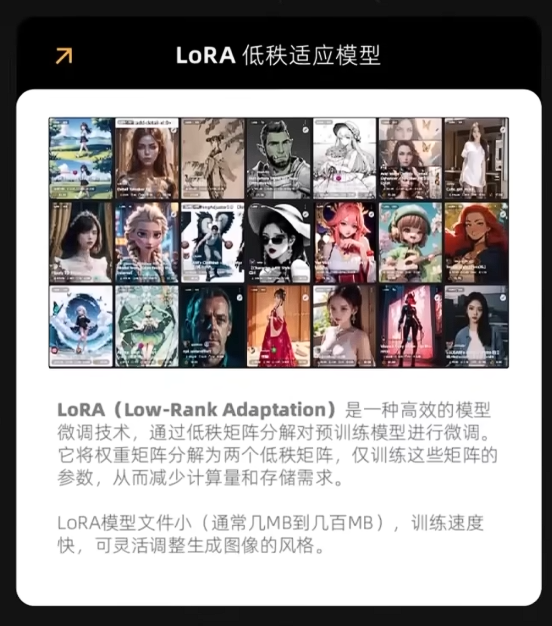
LoRA(Low-Rank Adaptation,低秩适配)是目前最主流的轻量化模型微调方案。
为什么会会有Lora 模型?
当我们想要对模型本体进行微调的时候,由于模型本身的参数量是很大的,因此微调时间也很长,这样会导致效率太慢。因此出现了 Lora 模型。
Lora模型是完全基于模型本体的一小部分模型参数进行训练的微调产物。因此Lora模型不可以独立运行,只能搭配对应的模型本体一起使用。
由于Lora模型本身微调的参数量很小。因此Lora模型的体积很小,体积通常只有几十 MB ~ 几百 MB。
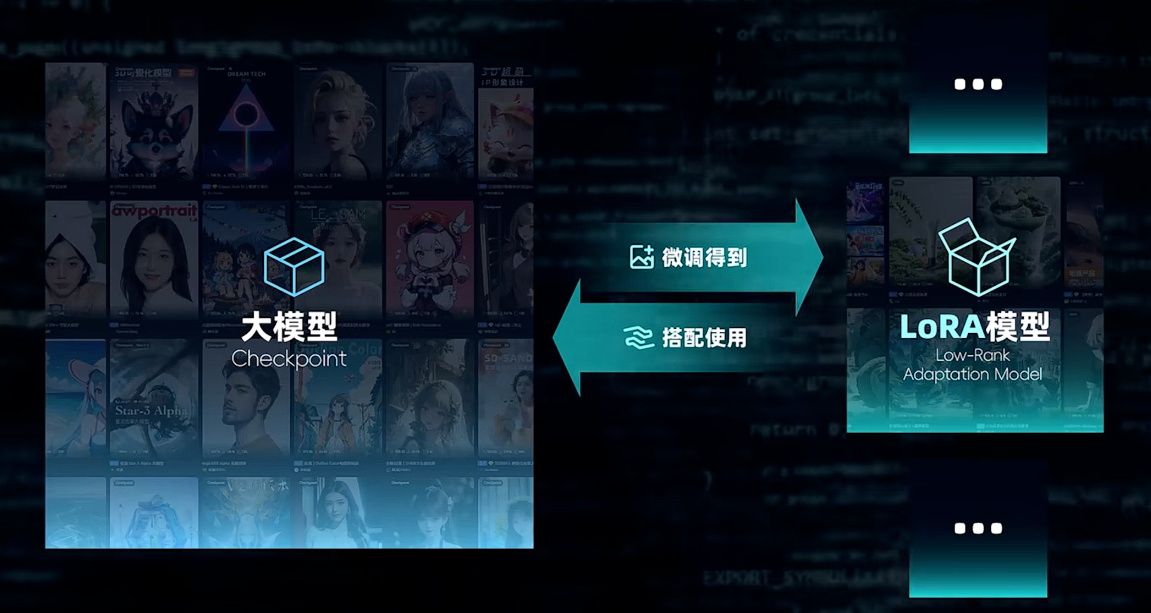
Lora 模型的作用
通过模型本体 + 对应的 Lora 模型一起使用,可以为模型添加新的模型参数或者强化原有的模型参数。从而提升模型的图像生成能力。
通俗解释:Lora 模型就像给模型本体 定制了一个扩展包,让它能够实现各种扩展功能,但不改变模型本身。
常见用途:
- 添加特定画风(动漫、写实、赛博朋克等)
- 学习特定人物特征
- 增强模型在特定领域的表现
Lora 模型的工作原理
工作原理:通过低秩矩阵分解技术,在不修改原模型参数权重的情况下,通过补丁插件的方式为模型添加新的模型参数或者强化原有的模型参数。
ControlNet组件(控制网络)
ControlNet 是一个强大的控制工具,允许用户通过辅助图像精确控制生成结果。
工作原理:在生成过程中,额外引入一个控制网络,根据辅助图像(如线稿、深度图、姿势图)来引导图像生成,确保图像生成的结果符合预期的结构和布局。
通俗解释:就像给AI一张草图或布局图或深度图或姿势图等,然后让它按照这个框架来画画。
常见 ControlNet 类型:
| 类型 | 作用 | 使用场景 |
|---|---|---|
| Canny | 边缘检测,控制轮廓 | 线稿上色、轮廓控制 |
| OpenPose | 姿态估计,控制人物姿势 | 人物动作控制 |
| Depth | 深度图,控制空间关系 | 场景布局、透视控制 |
| Segmentation | 分割图,控制区域 | 区域风格化、内容替换 |
| Tile | 平铺控制 | 高清修复、图像扩展 |
| Scribble | 涂鸦控制 | 草图生成 |
使用步骤:
- 准备一张辅助图像(如线稿、姿势图)
- 使用对应的 ControlNet 模型处理辅助图像
- 将处理结果连接到采样器节点
- AI模型 会根据辅助图像的结构进行生成
Upscaler 放大模型
Upscaler(图像放大模型)用于将低分辨率图像放大到更高分辨率,同时增强细节。
工作原理:通过深度学习技术,在放大图像的同时填充缺失的细节,避免像素化。
通俗解释:就像用放大镜看图片,但看到的不是模糊的像素,而是清晰的细节。
常见模型:
- ESRGAN:经典放大模型,效果好
- 4x-UltraSharp:高质量4倍放大
- RealESRGAN:专门优化真实照片放大
controlNet 控制网络
什么是 ControlNet ?
图像生成模型生成图像,就像抽卡一样。例如,我想生成一张做出特定的姿势和动作的人物的图像(抽烟,跳舞,运动等)。通常情况下,就算有详细精准的提示词的把控下,也不能完全确保人物的姿势和动作次次符合预期。
因此就出现了 ControlNet 控制网络,它由 Lvmin Zhang 等人于 2023 年提出,迅速成为图像生成领域的标配工具。
ControlNet 控制网络是一个神经网络模型,允许用户通过辅助图像方便快捷的控制图像人物的姿势和动作。
ControlNet 是现代 AI 图像生成不可或缺的工具,掌握它可以大幅提升生成的可控性和创意表达能力。
ControlNet 控制网络的工作原理
ControlNet 是一种端到端的空间条件控制神经网络架构,通过外挂式旁路分支,将额外的空间约束信号(姿态、深度、边缘、语义分割图等)注入预训练扩散 UNet,在完全不损失底模原生生成能力的前提下,实现对生成画面结构的精准控制。
ControlNet 控制网络无法独立生成图像,必须配合对应的主模型本体协同工作。
如图所示 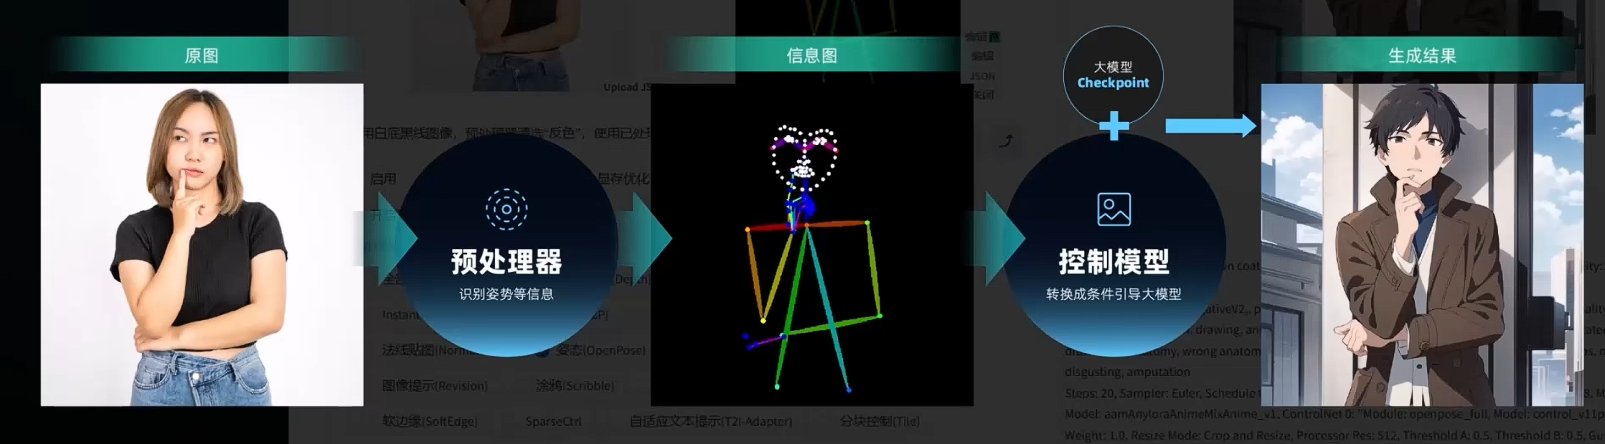
ControlNet 控制网络的核心功能
| 功能类别 | 具体能力 | 说明 |
|---|---|---|
| 结构控制 | 边缘检测、姿态估计、深度图 | 精确控制图像的结构和布局 |
| 内容控制 | 分割图、关键点检测 | 指定图像中不同区域的内容 |
| 风格控制 | 风格迁移、调色板控制 | 将参考图像的风格应用到生成结果 |
| 修复增强 | 高清修复、图像扩展 | 对现有图像进行修复和放大 |
常用 ControlNet 控制网络的模型
ControlNet 控制网络有多种类型的模型,每个类型的模型都有其特定的功能和适用场景。以下是一些常用的 ControlNet 控制网络模型:
| 序号 | 模型名称 | 作用 | 使用场景 | 特点 |
|---|---|---|---|---|
| 1 | Canny(边缘检测) | 检测图像边缘,控制轮廓形状 | 线稿上色、轮廓控制、保持特定形状 | 对线条要求不高,草图也能使用 |
| 2 | OpenPose(姿态估计) | 检测人体关键点,控制人物姿势和动作 | 人物动作控制、多人互动场景、角色动画 | 支持单人、多人姿态检测 |
| 3 | Depth(深度图) | 生成深度图,控制空间关系和透视 | 场景布局、透视控制、3D 效果增强 | 支持多种深度估计模型 |
| 4 | Segmentation(分割图) | 将图像分割为不同区域,分别控制 | 区域风格化、内容替换、多主题生成 | 需要精确的分割标注 |
| 5 | Tile(平铺控制) | 通过局部图像块控制生成 | 高清修复、图像扩展、细节增强 | 对显存要求较低 |
| 6 | Scribble(涂鸦控制) | 根据简单涂鸦生成图像 | 草图生成、创意快速表达 | 对绘画技巧要求极低 |
进阶 ControlNet 控制网络的模型
| 模型名称 | 功能 | 使用场景 |
|---|---|---|
| Lineart | 提取艺术线条 | 艺术线稿上色 |
| Normal Map | 法线贴图控制 | 3D 渲染、光照控制 |
| HED | 软边缘检测 | 柔和轮廓控制 |
| MLSD | 直线和几何检测 | 建筑、室内设计 |
| Softedge | 软边缘控制 | 水彩、手绘风格 |
文生图(Text-to-Image)
文生图的核心比喻:AI从一张满是雪花噪点的空白画布中,按照文字指令一步步擦除噪点,最终画出完整图片。
文生图的基本逻辑
输入提示词(例如:"画一个穿红色衣服的女孩")
  -> 文本模型将提示词转化为AI向量语言
  -> 把AI向量语言发送给图像生成模型
  -> 图像生成模型先随机生成一张完全杂乱、没有任何内容的噪点图,相当于一张全是雪花的图片。
  -> 图像生成模型根据你给的提示词要求,分几十步慢慢清理噪点。每一步都修正噪点图、使其贴合提示词要求。
  -> 图像生成模型当迭代步数使用完后,就会生成一张符合要求的图。(如果步数太少,生成的图可能会有缺陷)。此时人类无法直接识别该图。
  -> 然后将符合要求的图通过图像编码解码模型转换为人类能识别的图像结果。
  -> 最后将生成的图像输出到本地。
文生图的工作原理
- 步骤1: 输入提示词(例如:"画一个穿红色衣服的女孩")
- 步骤2: CLIP文本编码器将提示词转换为AI语言(条件向量)
- 步骤3: 在图像生成模型的潜空间中,随机采样生成一张空白潜在图像(充满随机噪点)。相当于一张全是雪花噪点的图片。
- 步骤4: 采样器根据AI语言(条件向量)逐步迭代去除潜在图像的噪点,生成清晰的潜在图像。
- 步骤5: VAE解码器将潜在图像转换为 RGB 像素图像
- 步骤6: 输出最终的 RGB 像素图像(例如:一个穿红色衣服的女孩)
核心组件
| 组件 | 作用 | 类比 |
|---|---|---|
| CLIP文本编码器 | 将文本转换为向量 | 翻译官 |
| UNet 模型 | 执行去噪计算 | 画师的手 |
| KSampler | 控制去噪过程 | 画画的步骤 |
| VAE | 编码/解码图像 | 显影剂 |
文生图工作流示例
用流程图展示文生图工作流
图生图(Image-to-Image)
图生图和文生图的区别在于起点不同:
- 文生图:从一张"白纸"(随机噪点图)开始去噪。
- 图生图:从一张"原图"上先增加噪点,再开始去噪。
核心比喻:根据用户提供的原图和提示词,先给原图增加噪点,变成一张模糊的图片,保留原图大体结构。然后根据提示词要求,再去噪点,最终生成一张新的图像。
基本业务逻辑
输入原图和提示词
  -> 将提示词转化为AI语言。
  -> 把AI语言和原图一起发送给图像生成模型。
  -> 图像生成模型读取原图作为作画基础框架。先给原图叠加雪花噪点、将其变成一张模糊的图片。其中的重绘强度参数决定加噪点的程度,数值越高,原图模糊越彻底、可修改空间越大。
  -> 图像生成模型根据你给的提示词要求,对这个模糊的图片分几十步慢慢清理噪点:每一步都修正画面、使其贴合提示词要求。
  -> 然后将符合要求的图通过图像编码解码模型转换为人类能识别的图像结果。
  -> 最后将生成的图像保存到本地。
工作原理
专业角度介绍
- 步骤1: 输入原图和提示词
- 步骤2: CLIP文本编码器将提示词转换为AI语言(条件向量)
- 步骤3: 在模型潜空间中,先再原图的基础上叠加雪花噪点、将其变成一张模糊的图片。重绘强度决定加噪点的程度,数值越高,原图模糊越彻底、可修改空间越大。
- 步骤4: 采样器再根据AI语言(条件向量)逐步迭代去除潜在图像的噪点,生成清晰的潜在图像。
- 步骤5: VAE解码器将潜在图像转换为 RGB 像素图像
- 步骤6: 输出最终的 RGB 像素图像
图生图工作流示例
用流程图展示图生图工作流
文生视频(Text-to-Video)
通俗解释
文生视频就像让AI画一系列连续的画,然后把它们连起来变成动画:
- 你说需求:"一个女孩在草地上跑步"(提示词)
- 准备画纸:准备多张空白画纸(潜在图像序列)
- 逐帧画画:AI一张一张画,每张画是视频的一帧
- 保持连贯:确保相邻画面之间动作连贯(时间一致性)
- 合成视频:把所有画连起来变成视频
工作原理
输入提示词
  -> CLIP文本编码器将提示词转换为AI语言(条件向量)
  -> 模型创建空白潜在图像序列
  -> 视频模型逐帧生成图像
  -> 相邻帧之间添加时间一致性约束
  -> VAE解码每帧图像
  -> 组合成视频输出
图生视频(Image-to-Video)
通俗解释
图生视频就像让AI从一张静态照片开始,想象接下来会发生什么:
- 输入照片:一张女孩站在草地上的照片
- 你说需求:"让她跑起来"(提示词)
- AI想象:AI根据照片和需求,生成女孩跑步的连续画面
- 保持连贯:确保动作流畅自然
- 合成视频:把所有画面连起来变成视频
工作原理
输入原图和提示词
  -> VAE编码先将原图编码为潜在图像
  -> CLIP文本编码器将提示词转换为AI语言(条件向量)
  -> 视频模型从原图出发,逐帧生成后续画面
  -> 相邻帧之间添加时间一致性约束
  -> VAE解码每帧图像
  -> 组合成视频输出
技术术语详解
以上的文生图,图生视频中会产生许多技术术语。下面对这些术语进行介绍
潜在空间图像(Latent Space Image)
定义:一种压缩的图像表示方式,尺寸只有原图的1/8左右。
通俗解释:就像把一张大图压缩成小图来处理,处理完再放大。
优势:计算速度快,显存占用少
VAE(Variational Autoencoder,变分自编码器)
定义:负责将像素图像和潜在空间图像之间进行转换的组件。
通俗解释:VAE就像一个翻译器,在人类图像和AI内部图像之间转换。
组成:
- VAE编码器:将正常RGB图像编码为潜在空间图像
- VAE解码器:将潜在空间图像解码为正常RGB图像
CLIP(Contrastive Language-Image Pretraining,对比语言-图像预训练)
定义:一种能够将文本和图像关联起来的模型。
通俗解释:CLIP 是AI的"双语词典",知道哪些文字对应哪些图像。
作用:CLIP文本编码器负责将提示词转换为条件向量,引导图像生成。
UNet
定义:Diffusion模型中负责去噪的核心组件。
通俗解释:UNet是AI的"画笔",负责根据提示词一步步去除噪点,生成清晰的潜在图像。
特点:
- 接受条件向量和潜在图像作为输入
- 输出去噪后的潜在图像
seed 随机种子
核心作用:决定图片初始噪点的排列规律,相当于画面的 “基因编号”。同一个种子 + 完全相同的其他参数,能 100% 复现同一张图。同一个种子值 + 不同的配置参数,会导致不同的画面效果。
如图所示,不同的随机种子,会导致不同的画面的初始噪声图,进而导致最终的画面效果。 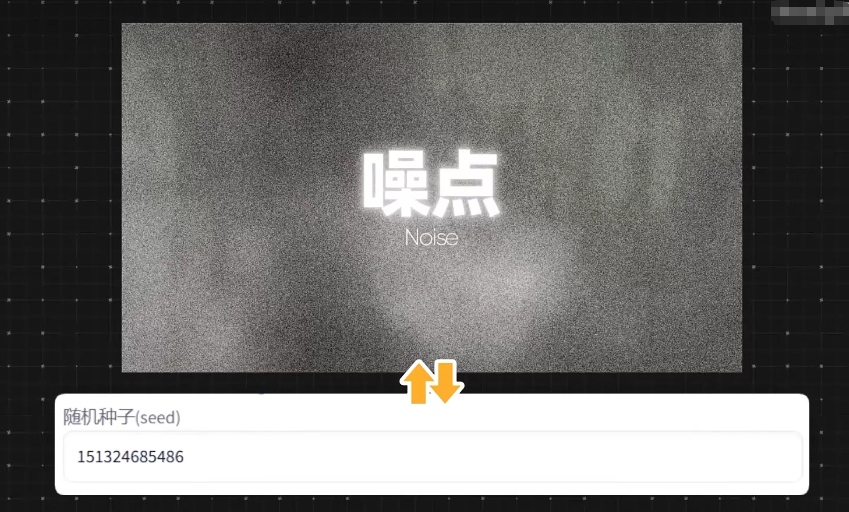
随机种子使用建议
- 找灵感阶段:seed数值设置为-1,那么种子值会随机生成,然后再配合批量出图,挑选出满意的构图和氛围。
- 微调图片阶段:先固定种子数值,只修改提示词/小参数,保证画面整体构图不变、只调整画面细节,这样效率最高。
采样(Sampling)
什么是采样?
diffusion扩散模型生成图片的过程是: 先随机生成一个噪声图像 -> 然后根据提示词去除噪声 -> 最后生成具体的图像。
如图是采样的过程。图片在每一次迭代中,都会被去除一些噪声。每一次迭代都会让图片更接近最终的图像。 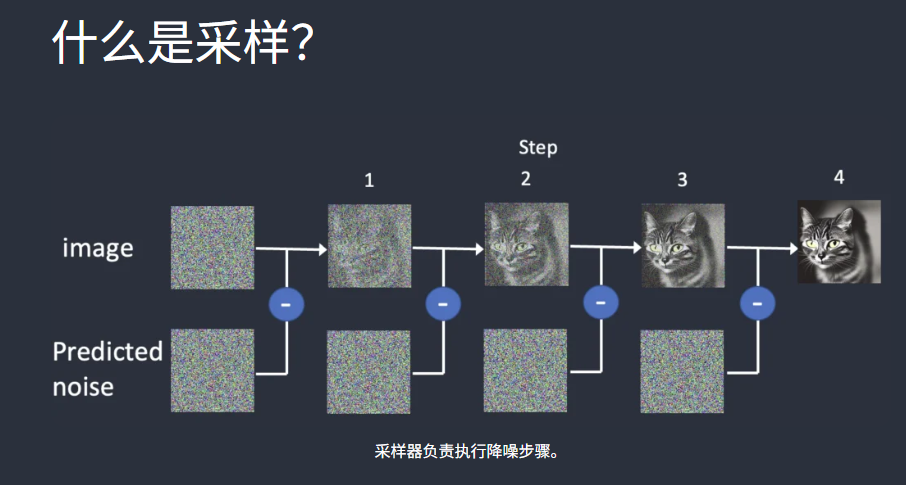
简而言之,采样就是图像生成中去除噪声,生成清晰图像的过程。
具体详细的采样介绍,可以参考 https://stable-diffusion-art.com/samplers/。
什么是采样器(Sampler)?
定义:采样器就是在图像生成过程中,根据提示词去除噪声的算法。不同的采样器使用不同的采样算法来去除噪声。
通俗解释:不同的采样器就像不同的画画风格,有的画得快,有的画得细致。
如何选择采样器?
目前有许多采样器,但是这些采样器有的已经过时,有的效果不好。建议绝大多数情况下,选择默认的采样器即可。
目前仅推荐以下几种采样器:
| 采样器 | 特点 | 类比 |
|---|---|---|
| DPM++ 2M | 最常用的采样器,平衡效果和质量,速度快。相对全能的一个采样器。推荐使用。 | 素描 |
| DPM++ SDE | 高质量,适合最终渲染 | 油画 |
| Euler | 快速,适合预览 | 速写 |
| Euler a | 在Euler采样器的基础上,添加了一些改进。随机性强,创意丰富 | 写意画 |
| Restart | 新一代采样器,效率高,可以在较少的迭代步数上就能够生成高质量的图像。 | 速写 |
采样步数(即采样迭代次数)
核心作用:决定采样器在图像上迭代的次数。简而言之就是 AI 迭代画面的次数。步数越少迭代次数越少,生成越快,步数越多迭代次数越多,生成越慢,细节越完整。
注意:采样步数与采样器和调度器的选择相关。不同的模型对应的采样步数的推荐值是不同的。对于大多数模型来说,采样步数的推荐值是25步左右。但达到一定步数后再加步数,画面几乎不会提升,边际效果减少,纯浪费时间。
不同模型对应采样步数的推荐值:
- SD-1.5模型:20~28 步
- SDXL模型:24~35步
- Z-Image-Turbo模型:8步
- Wan2.1模型:24~28步
调度器(Scheduler)
定义:调度器就是在图像生成的每一次迭代过程中,根据采样器的结果,调度器决定了下一次迭代中去噪的幅度和方式。
如何选择调度器?
大多情况下,调度器可以选默认即可。即程序会根据采样器的选择来选择合适的调度器。或者拿不准的时候,可以选择Karras调度器。
- Karras: 最常用的调度器,效果好,速度快,相对全能的一个调度器。推荐使用。
注意:不同的模型需要搭配不同的采样器和调度器。因为模型在训练时,会更倾向使用某种采样器和调度器。具体可以参考模型的文档,或者参考模型作者的建议。
cfg 提示词强度
定义:控制提示词对生成结果的影响程度。CFG数值越低,AI 越自由发挥;数值越高,越严格贴合你写的提示词描述。
常见范围:5-15,推荐7-10
- 太低(< 3):提示词几乎失效,画面随机感强,内容容易跑偏。
- 太高(>10):画面僵硬、色彩过饱和、细节重复(俗称 “CFG 烧了”),反而会变糊、出现畸形元素。
注意:先按模型文档中推荐的cfg值来,觉得画面不符合描述就加 0.5~1,觉得画面僵硬不自然就减 0.5~1。
不同模型对应CFG的推荐值:
- SD-1.5模型:建议5~7。首选6
- SDXL模型:建议5~8。首选7
- Z-Image-Turbo模型:3~5。首选4
- Wan2.1模型:6~7
Denoise(去噪强度,降噪强度)
定义:由于图生图是需要先对原图添加噪声的。降噪强度就是对原图添加噪声的修改程度。数值越大,AI对原图的修改越多;值越小,保留原图越多。数值范围是0 ~ 1。
注意:降噪强度Denoise 在文生图的场景下无效。因为文生图是没有原图的。
适用范围
| Denoise值 | 效果 | 类比 |
|---|---|---|
| 0.1~0.3 | 只优化画质、光影、色彩,构图主体几乎不变(比如照片修复、提清晰度) | 微改动 |
| 0.3~0.5 | 轻微修改,保留主体构图,更换画风、细化细节(比如照片转动漫)。 | 小改 |
| 0.5~0.7 | 中等修改,主体大致保留,细节和背景大幅修改。 | 中改 |
| 0.7~0.9 | 较大修改,主体只保留大致轮廓,几乎重新创作。 | 大改 |
| 0.9 以上 | 完全重绘,接近纯文生图参考图只剩极浅的影子。 | 重画 |