[toc]
StableDiffusion笔记
Stable Diffusion是Stability AI公司开发的一种AI绘画生成工具。用户可以随意输入自己想要的内容,然后计算机就会自动生成艺术渲染作品。
最新版本Stable Diffusion 已迭代至 3.5 版本,相比前代版本能够生成更高质量、更精细的图像。无论您是专业设计师还是创意爱好者,Stable Diffusion都能将您的想象力转化为视觉现实。
官网截图 
我的当前显卡设备是 NVIDIA RTX 5060TI 16GB。
StableDiffusion 介绍
Stable Diffusion是一种基于深度学习的潜在文本到图像扩散模型,能够根据任何文本输入生成照片级真实感图像。该模型首先将图像压缩到潜在空间,然后通过逐步添加噪声来训练模型逆转这一过程,从零开始重新生成图像。
扩散模型原理
- 将图像压缩到低维潜在空间进行处理
- 逐步向图像添加高斯噪声破坏原图
- 训练神经网络学习逆转噪声添加过程
- 从随机噪声开始逐步还原清晰图像
- 文本编码器将提示词转化为引导向量
Stable Diffusion WebUI
最开始Stability AI公司只是发布了Stable Diffusion模型的模型文件。而如果想要使用Stable Diffusion模型进行文生图,图生图等操作,还需要围绕模型文件去配置运行环境,编写程序代码才能使用。
但后来github有一个开发者开发了一个Stable Diffusion WebUI项目。该WebUI项目可以让用户通过浏览器来使用 Stable Diffusion 模型。并进行文生图,图生图等操作。
项目地址 https://github.com/AUTOMATIC1111/stable-dusion-webui
项目截图 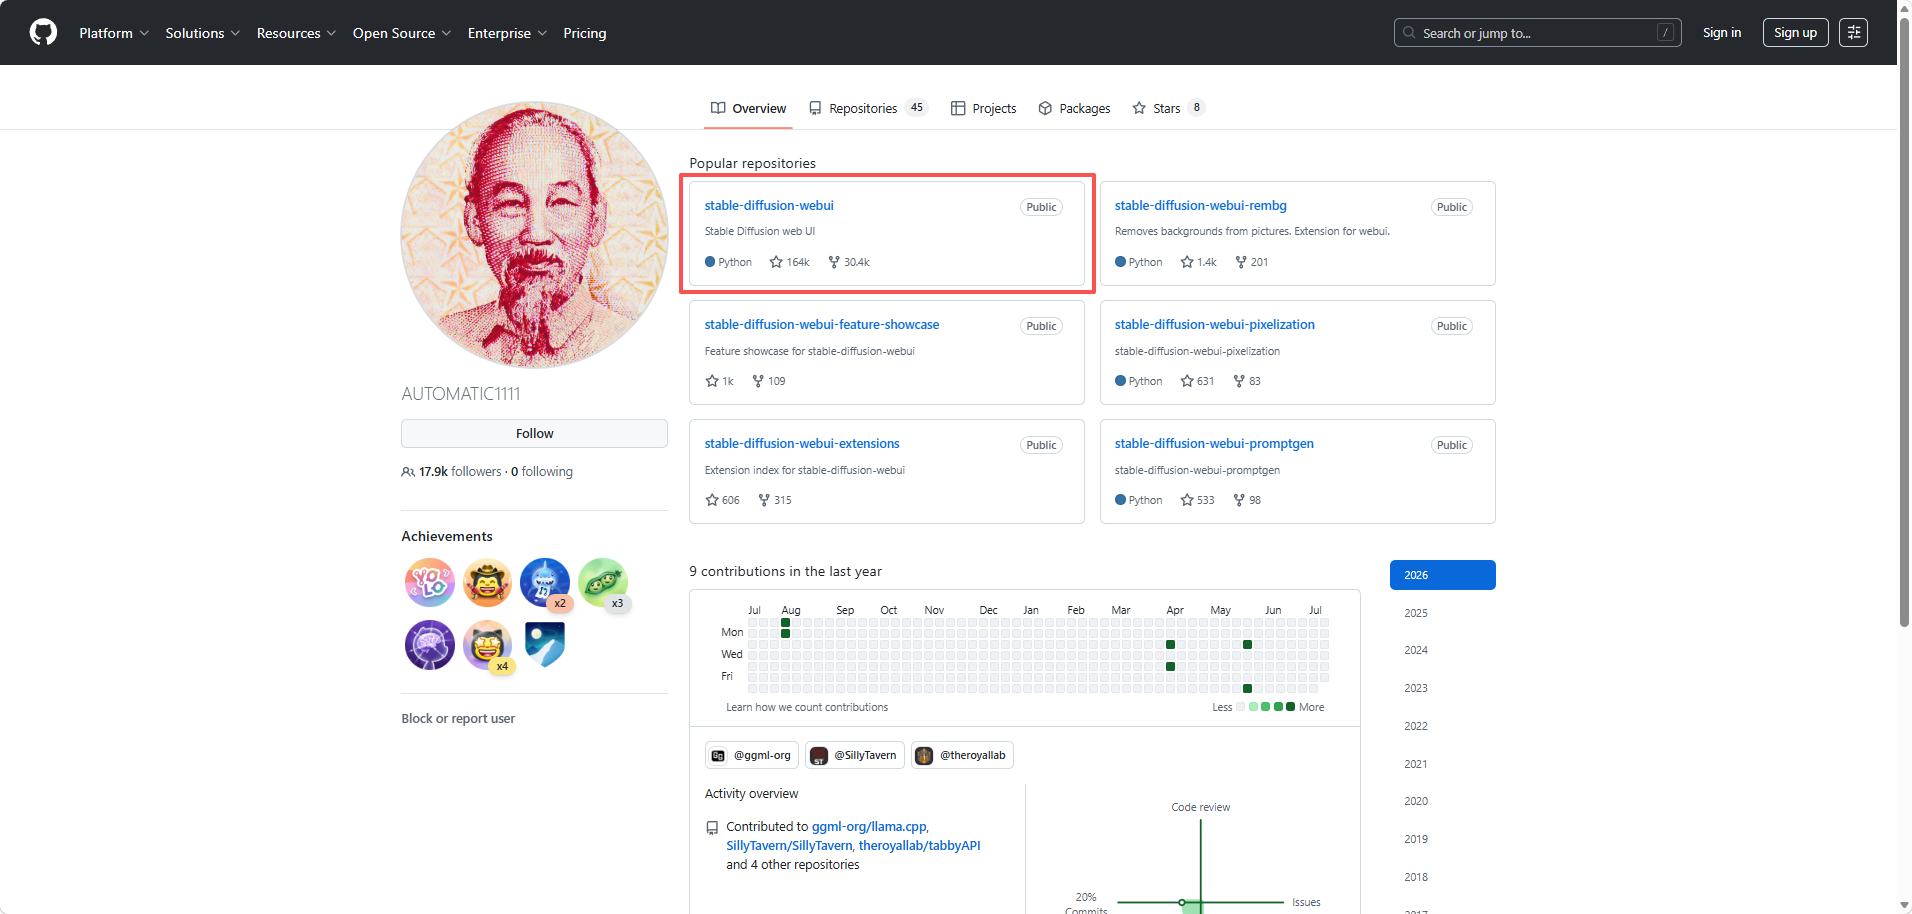
安装 WebUI
你可以通过在github上下载该项目代码,然后根据项目介绍来进行安装。
也可以在网上找到其他开发者对该项目的整合包,直接下载安装即可。
运行该WebUI项目后,会在浏览器中打开一个界面。如图所示 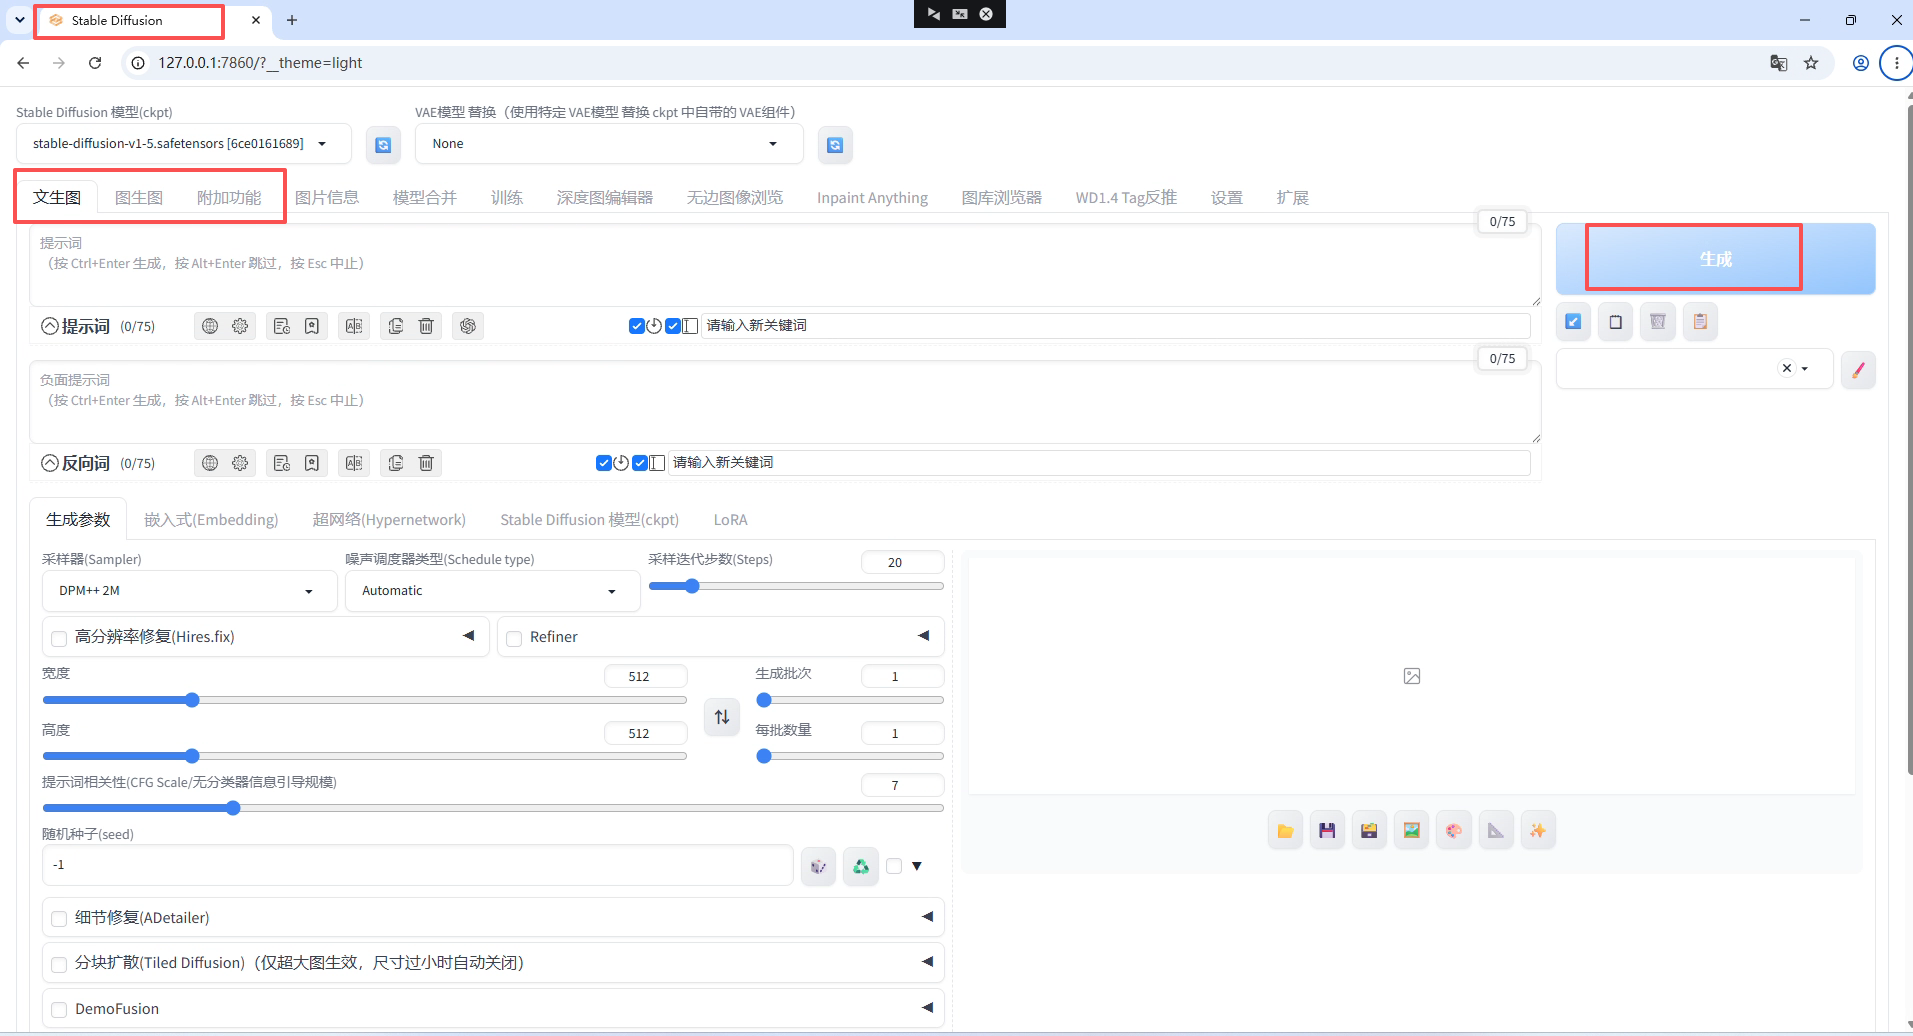
stable diffusion 提示词
提示词就是用户需要输入的文本,来描述他想要生成的图片。提示词越详细,生成的图片越符合用户的需求。
注意stable diffusion模型的提示词,需要用英语来描述。
正面提示词
正面提示词就是用户想要生成的图片的描述。
正面提示词通用模板:
质量词, 主体描述, 环境背景, 风格词, 画质词完整示例:
masterpiece, best quality, ultra detailed, a beautiful young woman with long blonde hair and blue eyes, wearing a white dress, standing in a sunlit meadow with colorful flowers, soft lighting, cinematic, 8k resolution

# 对应中文翻译:
# 杰作,品质卓越,细节超群,一位美丽的年轻女子,拥有长长的金发和蓝色的眼睛,身着白色连衣裙,站在阳光照耀、五彩缤纷的草地上,光线柔和,如电影画面般,8K分辨率各部分说明:
- 质量词:masterpiece, best quality, ultra detailed(告诉模型要画得好)
- 主体描述:a beautiful young woman with long blonde hair and blue eyes(描述画的主体)
- 环境背景:standing in a sunlit meadow with colorful flowers(描述背景环境)
- 风格词:cinematic(描述画风)
- 画质词:8k resolution(描述画质要求)
提示词顺序有影响,越靠前的词影响越大。
负面提示词
负面提示词就是用户不想要生成的图片的描述。
为什么需要负面提示词?
模型训练时可能学到了一些不好的特征(如模糊、变形、水印等),负面提示词可以帮助模型避免这些问题。
通用负面提示词模板:
bad quality, low quality, blurry, distorted, ugly, deformed, bad anatomy, text, watermark, signature, extra fingers, missing fingers, fused fingers, mutated hands, disfigured, poorly drawn face, poorly drawn hands

# 对应中文翻译:
# 质量差、质量低、模糊、扭曲、丑陋、变形、解剖结构不良、文字、水印、签名、多余手指、缺失手指、手指粘连、手部变异、面容受损、脸部绘制不佳、手部绘制不佳常见负面词分类:
- 质量问题:bad quality, low quality, blurry, pixelated
- 变形问题:distorted, deformed, bad anatomy, disfigured
- 多余内容:text, watermark, signature, logo
- 手部问题:extra fingers, missing fingers, fused fingers, mutated hands
- 面部问题:poorly drawn face, ugly, deformed face
提示词写法
在stable diffusion模型中,提示词的写法有以下几种。
逗号分隔
提示词之间用逗号分隔,这是最基本的写法。
a cat, sitting on a couch, cute, fluffy

# 对应中文翻译:
# 一只猫,坐在一张沙发上,很可爱,很软
SD 1.5 vs SDXL 提示词差异
不同的模型,提示词的写法也有差异。
| 模型 | 提示词长度 | 推荐写法 |
|---|---|---|
| SD 1.5 | 50-75 tokens | 简洁明了,重点突出 |
| SDXL | 75-100+ tokens | 更详细的描述,更多细节词 |
提示词权重
提示词权重就是用户可以对提示词进行加权,来控制提示词对模型的影响。默认情况下,提示词的权重是1,用户可以根据自己的需求来调整。
常见权重范围:
| 权重值 | 效果 | 适用场景 |
|---|---|---|
| 0.5-0.8 | 降低影响 | 不太重要的词 |
| 1.0 | 默认权重 | 一般描述词 |
| 1.2-1.5 | 增强影响 | 重要特征词 |
| 1.5-2.0 | 大幅增强 | 核心特征词 |
| >2.0 | 过度增强 | 可能产生不良效果,慎用 |
括号加权降权
使用括号 () 可以增加提示词的权重,语法为 (word:weight),默认权重为1。
大于1的权重会增强效果,小于1的权重会降低影响。
# 例如这个提示词,cute cat的权重为1.2,sitting on a couch的权重为1.0,fluffy的权重为1.2

(cute cat:1.2), sitting on a couch, (fluffy:0.8)(word:1.5):权重为1.5,增强效果(word:2.0):权重为2.0,大幅增强效果(word:0.5):权重为0.5,降低影响。
嵌套括号
可以嵌套使用括号,权重会相乘。
((cute cat:1.2):1.3) # 等效于 (cute cat:1.56)权重使用技巧:
- 突出核心特征:对最重要的特征词增加权重
- 弱化次要特征:对不太重要的词降低权重
- 平衡风格与内容:如果风格词太强,可以适当降低权重
- 避免极端权重:权重过高可能导致图像畸形或出现伪影
提示词权重是微调图像效果的重要手段,需要根据实际效果不断调整。
提示词起手式
提示词起手式就是用户常用的提示词,用户可以将常用的提示词保存为模板,方便后续一键调用。
在 sd webui 中,用户可以在提示词中添加起手式,来控制模型的生成结果。
如图是提示词起手式的设置。 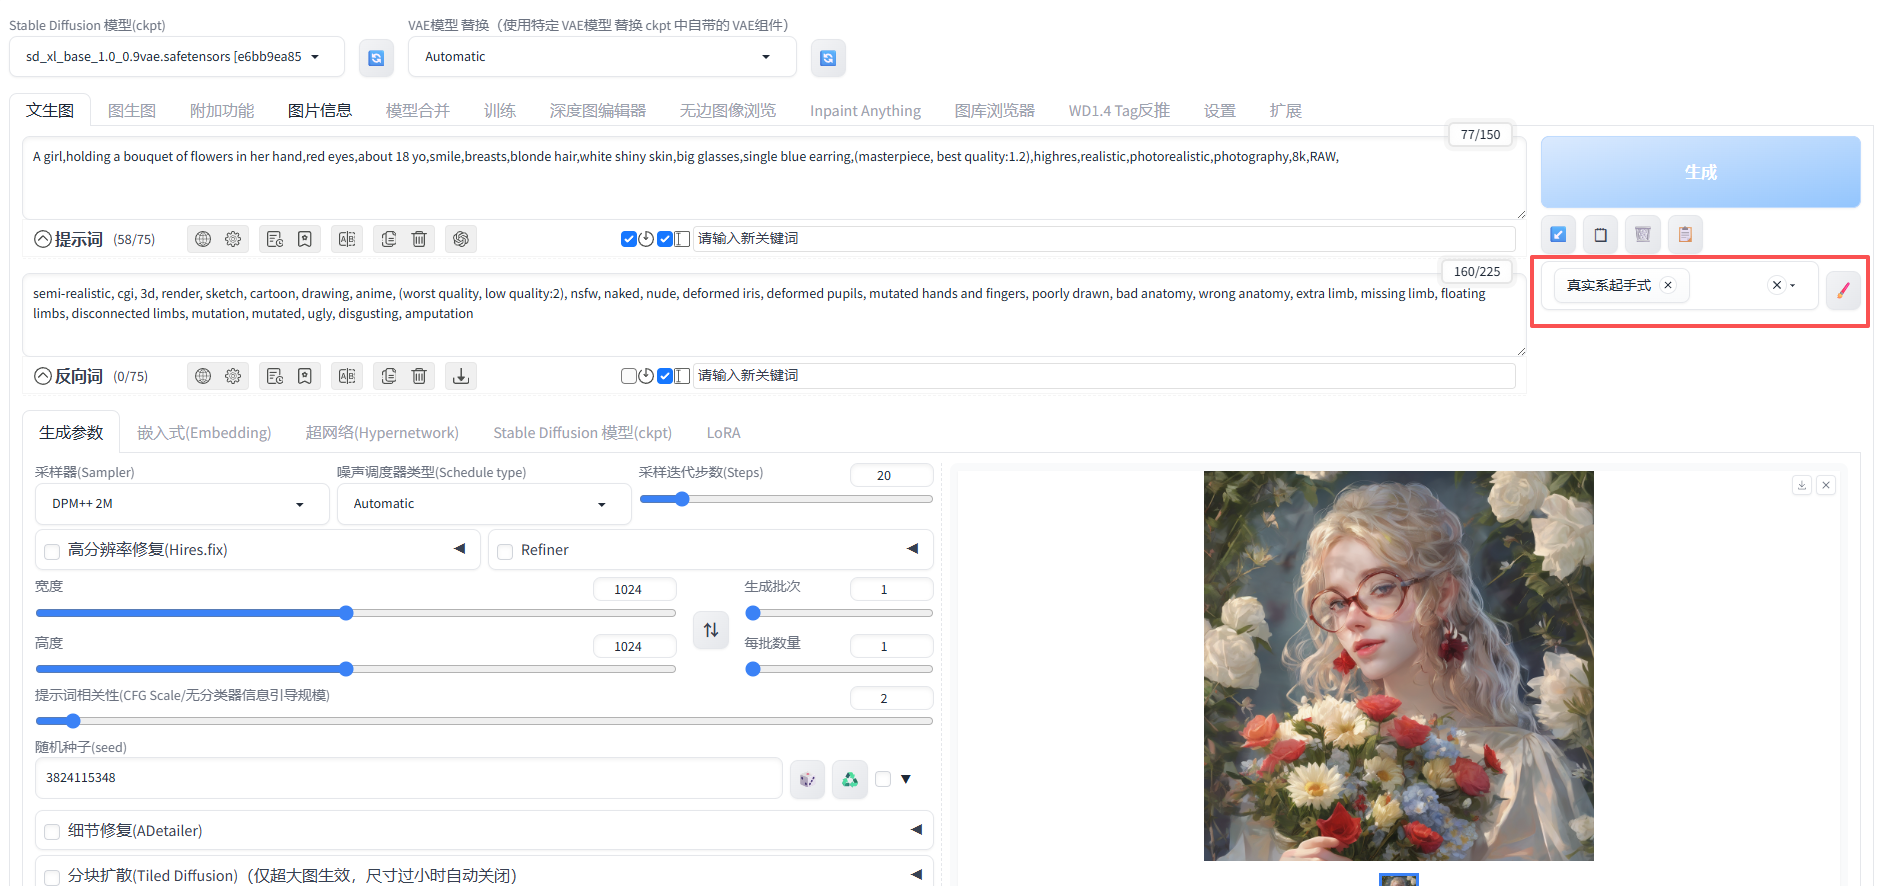
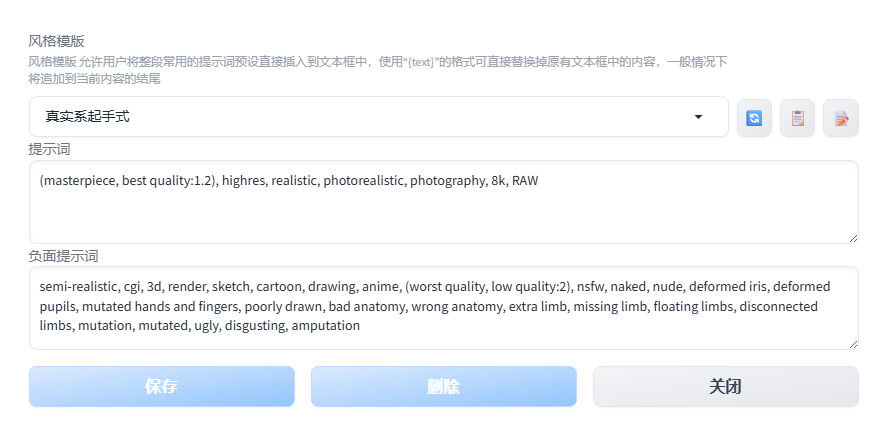
下面是一些通用的sd webui的提示词起手式。
通用提示词起手式
# 正面提示词:
(masterpiece, best quality:1.2), 8K, RAW, highres,

# 负面提示词:
NSFW, (worst quality:2), (low quality:2), (normal quality:2), lowres, normal quality, ((monochrome)), ((grayscale)), skin spots, acnes, skin blemishes, age spot, (ugly:1.331), (duplicate:1.331), (morbid:1.21), (mutilated:1.21), (tranny:1.331), mutated hands, (poorly drawn hands:1.5), blurry, (bad anatomy:1.21), (bad proportions:1.331), extra limbs, (disfigured:1.331), (missing arms:1.331), (extra legs:1.331), (fused fingers:1.61051), (too many fingers:1.61051), (unclear eyes:1.331), lowers, bad hands, missing fingers, extra digit,bad hands, missing fingers, (((extra arms and legs))),
真实系提示词起手式
# 正面提示词:
(masterpiece, best quality:1.2), highres, realistic, photorealistic, photography, 8k, RAW

# 负面提示词:
semi-realistic, cgi, 3d, render, sketch, cartoon, drawing, anime, (worst quality, low quality:2), nsfw, naked, nude, deformed iris, deformed pupils, mutated hands and fingers, poorly drawn, bad anatomy, wrong anatomy, extra limb, missing limb, floating limbs, disconnected limbs, mutation, mutated, ugly, disgusting, amputation
2.5D系风格起手式
# 正面提示词:
(masterpiece, best quality:1.2), 3d, 3d rendering, professional 3d model, rendered, cgi

# 负面提示词:
sketch, cartoon, drawing, anime,(worst quality, low quality, normal quality:2), nsfw, naked, nude, deformed iris, deformed pupils, mutated hands and fingers, poorly drawn, bad anatomy, wrong anatomy, extra limb, missing limb, floating limbs, disconnected limbs, mutation, mutated, ugly, disgusting, amputation
二次元风格起手式
# 正面提示词:
(masterpiece, best quality:1.2), anime, illustration, very aesthetic, wallpaper

# 负面提示词:
photorealistic, realistic, (worst quality, low quality, normal quality:2), nsfw, naked, nude, deformed iris, deformed pupils, mutated hands and fingers, poorly drawn, bad anatomy, wrong anatomy, extra limb, missing limb, floating limbs, disconnected limbs, mutation, mutated, ugly, disgusting, amputation
sd webui 模型参数设置
最佳生成分辨率
不同的图像生成模型都有一个最佳生成分辨率。例如 stable diffusion 1.5 最佳生成分辨率为 512x512,而 stable diffusion xl 最佳生成分辨率为 1024x1024。
这是因为有的模型在训练时,大量使用了某个分辨率的图像。导致这个模型在生成图像时,对于这个分辨率的图像有更高的质量。
因此,用户在使用模型时,建议使用最佳生成分辨率来生成图像。有更大概率生成高质量的图像。
那假如需要更大分辨率的图像,该如何办?
有两种方式:
- 方式① 可以先按照最佳生成分辨率来生成图像。然后再通过高清分辨率修复功能,来无损放大图像的分辨率。
- 方式② 根据最佳生成分辨率,按比例调整图像的分辨率。例如宽不变,高2倍或者高不变,宽2倍等。
采样器和调度器
简而言之,采样就是图像生成中去除噪声的过程。具体可以参考其他笔记。
- 采样器:就是在图像生成过程中,根据提示词去除噪声的算法。不同的采样器使用不同的采样算法来去除噪声。
- 调度器:就是在图像生成过程中,根据采样器的结果,来控制采样器每一阶段的噪声的去噪程度。
如图是stable diffusion webui的采样器和调度器设置。 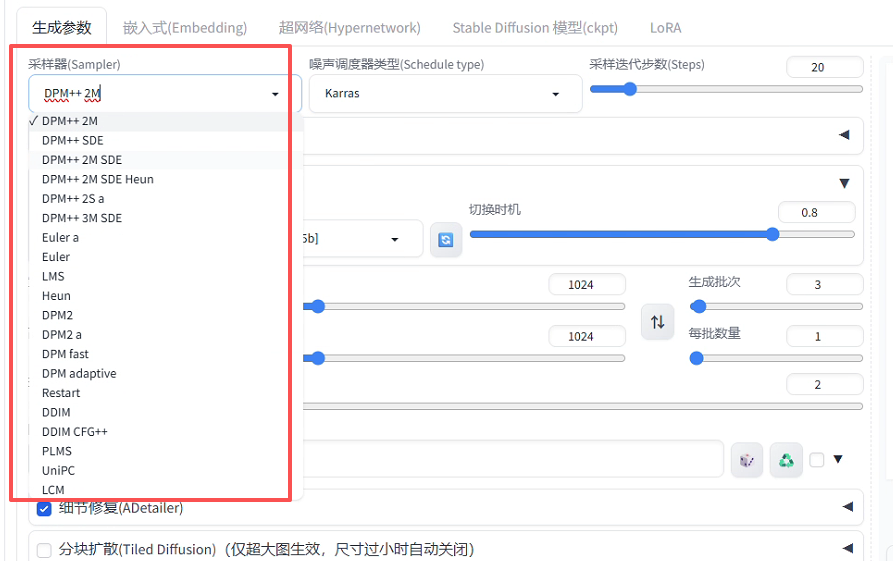
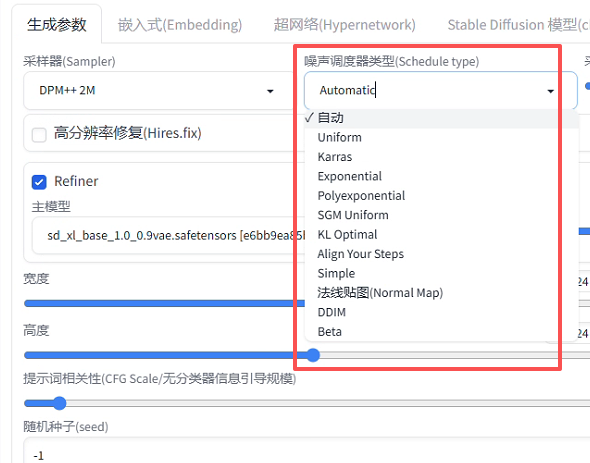
如何选择采样器?
目前仅推荐以下几种采样器。
- DPM++ 2M: 最常用的采样器,效果好,速度快。相对全能的一个采样器。推荐使用。
- Euler: 稳定,简单的采样器,结果可预测。
- Euler a: 在Euler采样器的基础上,添加了一些改进,效果好,速度快。
- Restart: 新一代采样器,效率高,可以在较少的迭代步数上就能够生成高质量的图像。
如何选择调度器?
大多情况下,调度器可以选默认即可。即程序会根据采样器的选择来选择合适的调度器。或者拿不准的时候,可以选择Karras调度器。
- Karras: 最常用的调度器,效果好,速度快,相对全能的一个调度器。推荐使用。
注意:不同的模型需要搭配不同的采样器和调度器。因为模型在训练时,会更倾向使用某种采样器和调度器。具体可以参考模型的文档,或者参考模型作者的建议。
采样步数(即采样迭代次数)
核心作用:决定采样器在图像上迭代的次数。简而言之就是 AI 迭代画面的次数。步数越少迭代次数越少,生成越快,步数越多迭代次数越多,生成越慢,细节越完整。
如图是sd webui的采样步数设置。 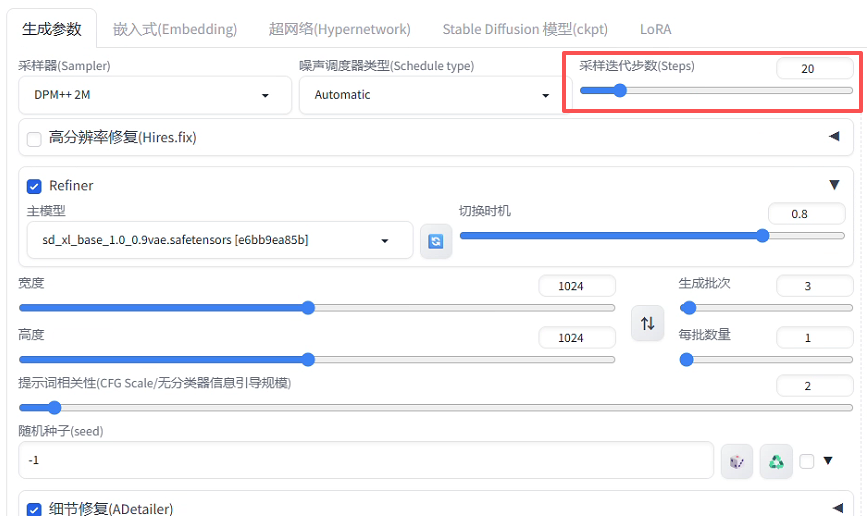
不同模型对应采样步数的推荐值
- SD-1.5模型:20~28 步
- SDXL模型:24~35步
- Z-Image-Turbo模型:8步
- Wan2.1模型:24~28步
seed 随机种子
核心作用:决定图片初始噪点的排列规律,相当于画面的 “基因编号”。同一个种子 + 完全相同的其他参数,能 100% 复现同一张图。同一个种子值 + 不同的其他参数,会导致不同的画面效果。
如图是 sd webui的随机种子设置。 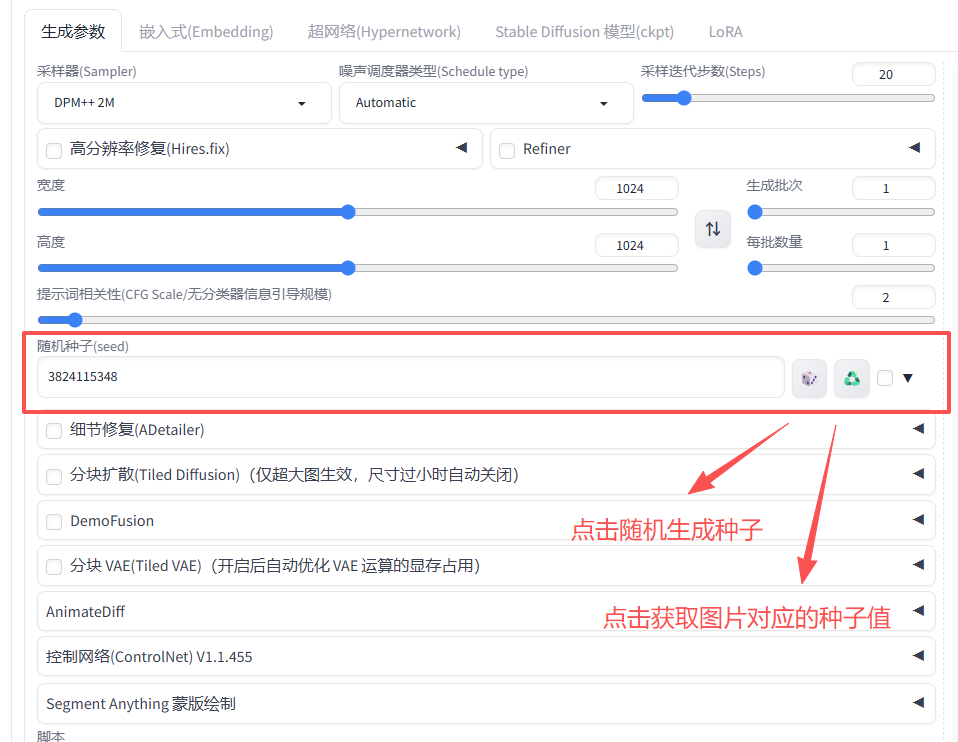
随机种子使用建议
- 找灵感阶段:seed数值设置为-1,那么种子值会随机生成,然后再配合批量出图,挑选出满意的构图和氛围。
- 微调图片阶段:先固定种子数值,只修改提示词/小参数,保证画面整体构图不变、只调整画面细节,这样效率最高。
cfg 提示词强度
核心作用:控制 AI “听不听提示词的话”。数值越低,AI 越自由发挥;数值越高,越严格贴合你写的提示词描述。
如图是sd webui的CFG值设置。 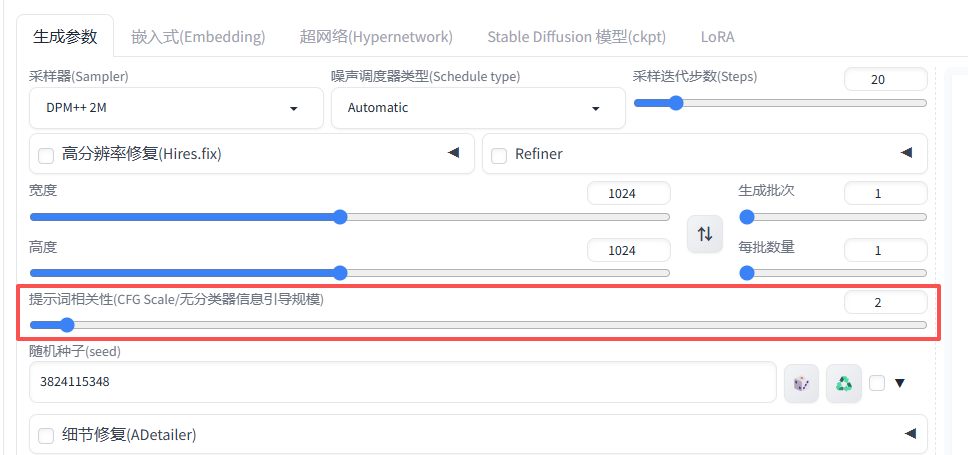
注意:先按推荐cfg值来,觉得画面不符合描述就加 0.5~1,觉得画面僵硬不自然就减 0.5~1。
不同模型对应CFG的推荐值
- SD-1.5模型:建议5~7。首选6
- SDXL模型:建议5~8。首选7
- Z-Image-Turbo模型:3~5。首选4
- Wan2.1模型:6~7
denoise 降噪强度
定义:由于图生图是需要先对原图添加噪声的。降噪强度就是对原图添加噪声的修改程度。数值越大,AI对原图的修改越多;值越小,保留原图越多。数值范围是0 ~ 1。
注意:降噪强度Denoise 在文生图的场景下无效。
如图是sd webui的降噪强度设置。 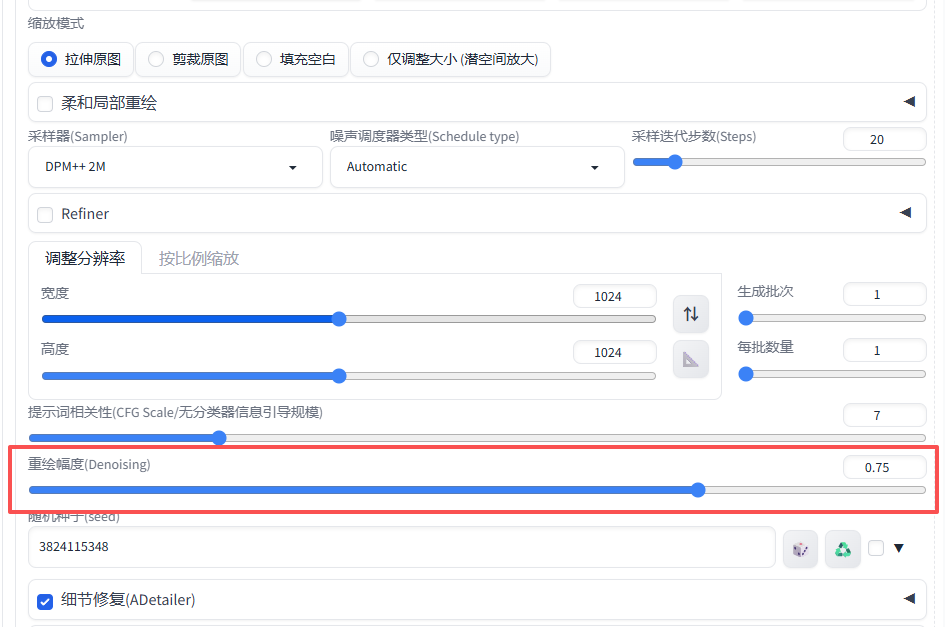
适用场景
| Denoise值 | 效果 | 类比 |
|---|---|---|
| 0.1~0.3 | 只优化画质、光影、色彩,构图主体几乎不变(比如照片修复、提清晰度) | 微改动 |
| 0.3~0.5 | 轻微修改,保留主体构图,更换画风、细化细节(比如照片转动漫)。 | 小改 |
| 0.5~0.7 | 中等修改,主体大致保留,细节和背景大幅修改。 | 中改 |
| 0.7~0.9 | 较大修改,主体只保留大致轮廓,几乎重新创作。 | 大改 |
| 0.9 以上 | 完全重绘,接近纯文生图参考图只剩极浅的影子。 | 重画 |
文生图
当你了解上面的操作之后,就可以在sd webui中进行文生图了。
如图是在sd webui中设置了提示词,采样器,调度器,采样步数,随机种子,CFG值等参数后。生成的一张图片。 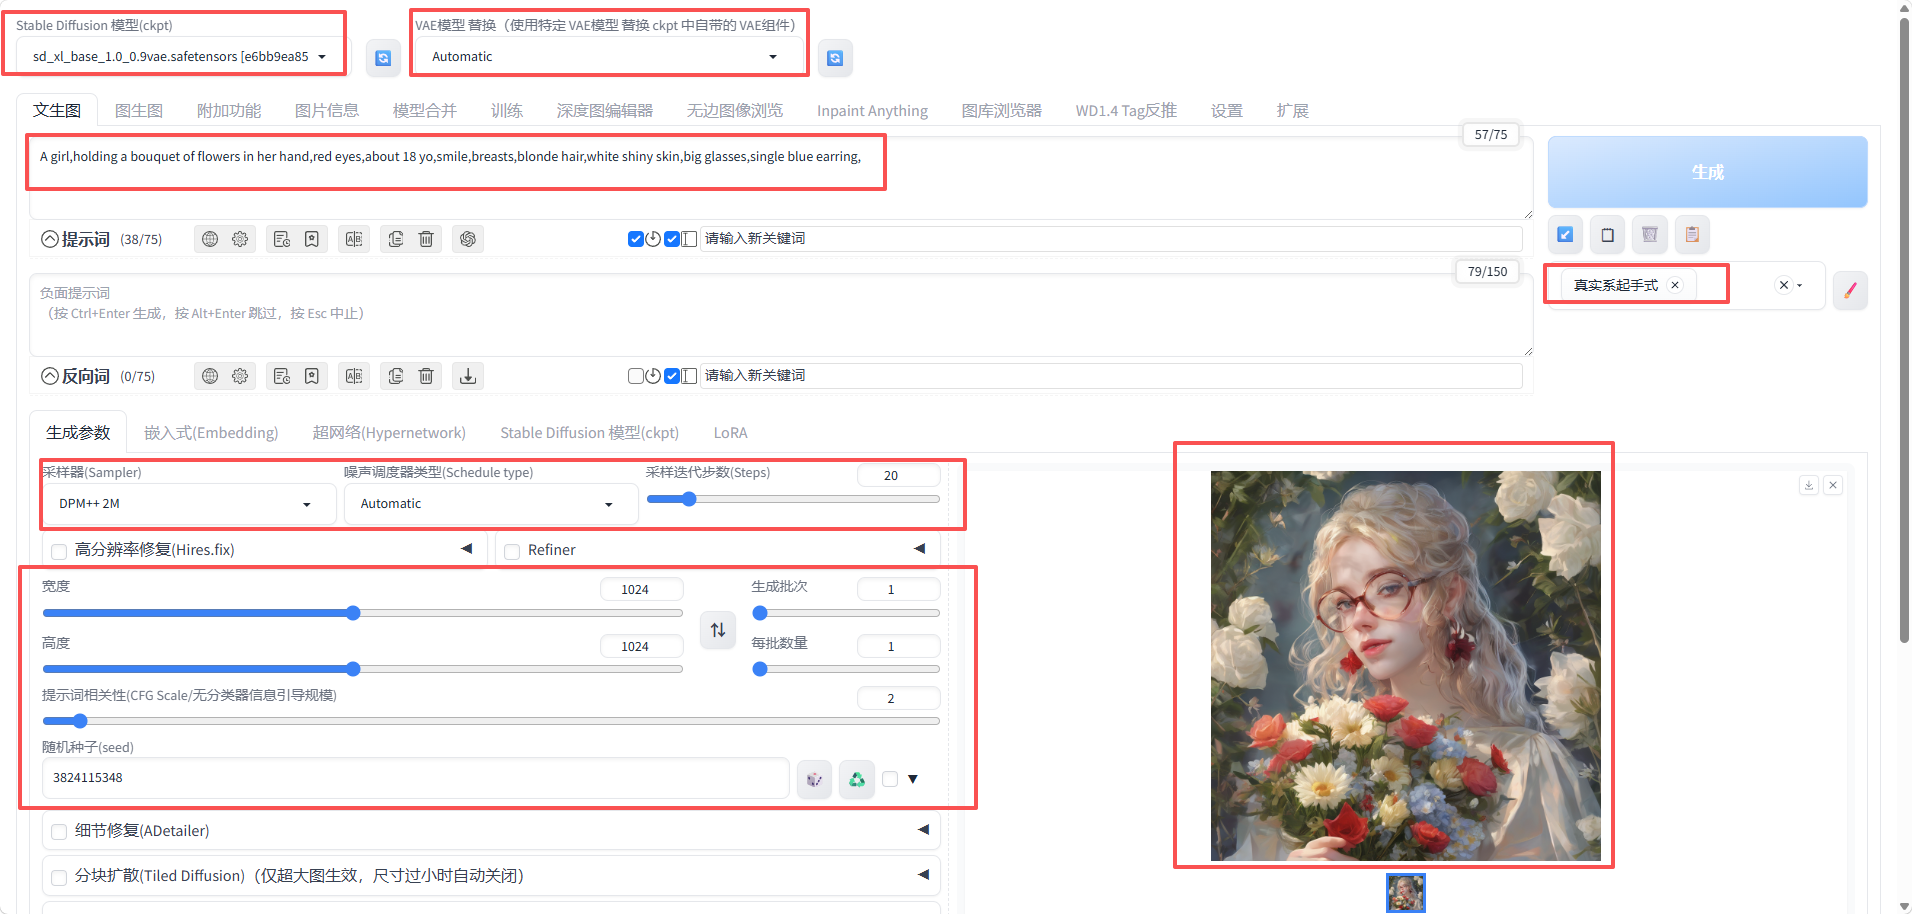
# 这是sd webui中对这个图片的完整参数,包括提示词,采样器,调度器,采样步数,随机种子,CFG值等参数。
A girl,holding a bouquet of flowers in her hand,red eyes,about 18 yo,smile,breasts,blonde hair,white shiny skin,big glasses,single blue earring,, (masterpiece, best quality:1.2), highres, realistic, photorealistic, photography, 8k, RAW
Negative prompt: semi-realistic, cgi, 3d, render, sketch, cartoon, drawing, anime, (worst quality, low quality:2), nsfw, naked, nude, deformed iris, deformed pupils, mutated hands and fingers, poorly drawn, bad anatomy, wrong anatomy, extra limb, missing limb, floating limbs, disconnected limbs, mutation, mutated, ugly, disgusting, amputation
Steps: 20, Sampler: DPM++ 2M, Schedule type: Karras, CFG scale: 2, Seed: 3824115348, Size: 1024x1024, Model hash: e6bb9ea85b, Model: sd_xl_base_1.0_0.9vae, Clip skip: 2, Downcast alphas_cumprod: True, Pad conds: True, Version: v1.10.1
图生图
图生图和文生图的区别在于起点不同:
- 文生图:从一张"白纸"(随机噪点图)开始去噪。
- 图生图:从一张"原图"上先增加噪点,再开始去噪。
核心比喻:根据用户提供的原图和提示词,先给原图增加噪点,变成一张模糊的图片,保留原图大体结构。然后根据提示词要求,再去噪点,最终生成一张新的图像。
四种缩放模式
当我们需要生成的图片尺寸 与 上传的原图尺寸不对应的时候。需要设置缩放模式。
如图是sd webui中图生图的四种缩放模式设置。 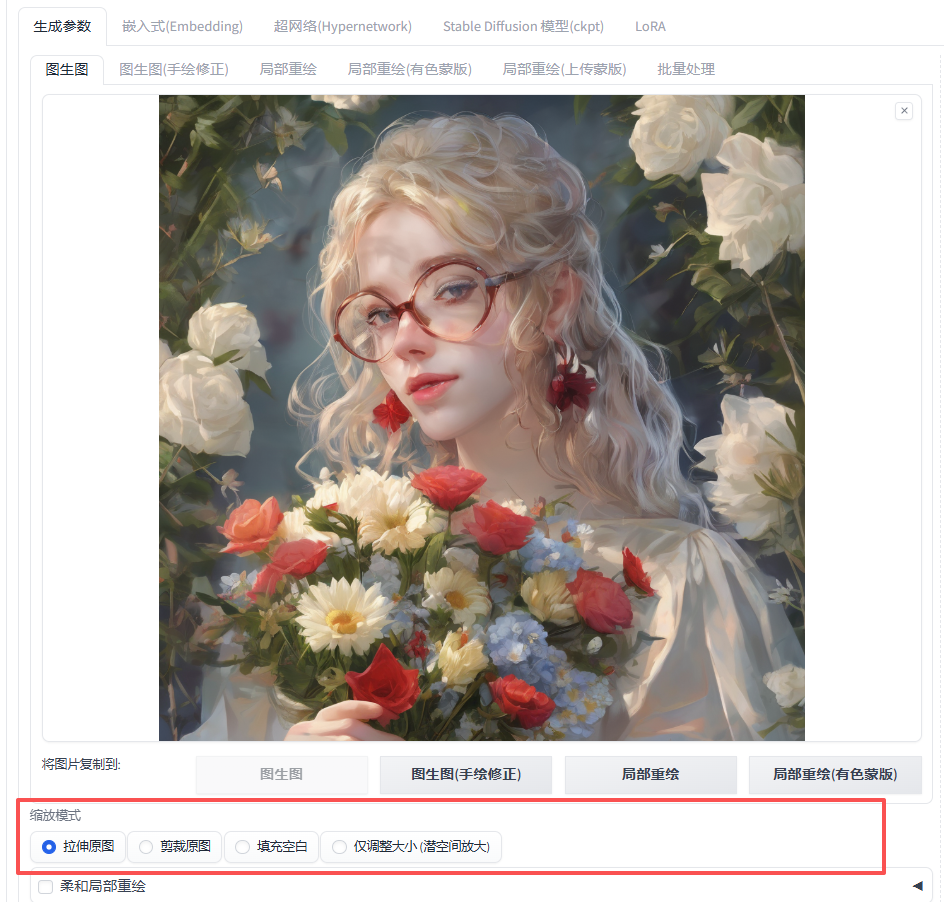
- 拉伸原图(默认选项):将原图拉伸到目标尺寸后,再进行创作。
- 裁剪原图:将原图裁剪到目标尺寸,再进行创作。
- 填充空白:等比例缩小原图,不足的空白区域,用原图边缘像素做模糊填充。然后再进行创作。
- 仅调整大小 (潜空间放大):与填充空白类似。
示例
如图是我再sd webui中通过一个抽象的原图,生成了一张新的图片。 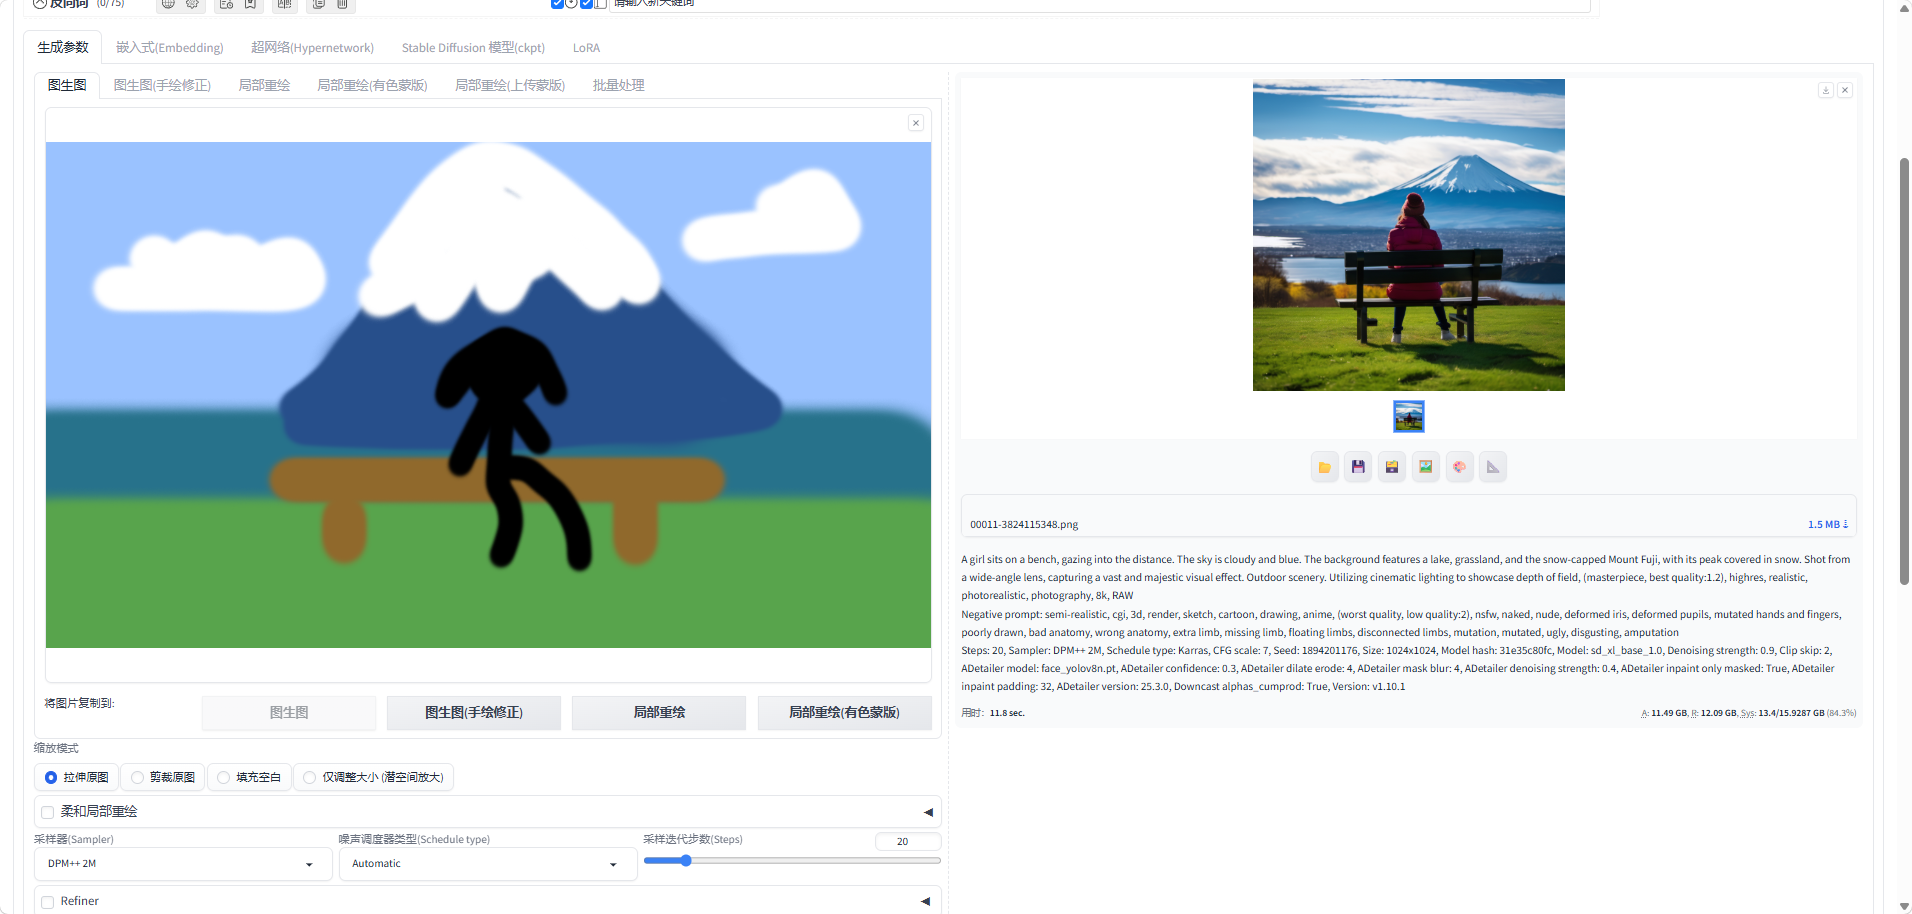
原图与新图差距过大,我是设置的降噪强度为0.9。
# 这是sd webui中对这个图片的完整参数,包括提示词,采样器,调度器,采样步数,随机种子,CFG值等参数。
A girl sits on a bench, gazing into the distance. The sky is cloudy and blue. The background features a lake, grassland, and the snow-capped Mount Fuji, with its peak covered in snow. Shot from a wide-angle lens, capturing a vast and majestic visual effect. Outdoor scenery. Utilizing cinematic lighting to showcase depth of field, (masterpiece, best quality:1.2), highres, realistic, photorealistic, photography, 8k, RAW
Negative prompt: semi-realistic, cgi, 3d, render, sketch, cartoon, drawing, anime, (worst quality, low quality:2), nsfw, naked, nude, deformed iris, deformed pupils, mutated hands and fingers, poorly drawn, bad anatomy, wrong anatomy, extra limb, missing limb, floating limbs, disconnected limbs, mutation, mutated, ugly, disgusting, amputation
Steps: 20, Sampler: DPM++ 2M, Schedule type: Karras, CFG scale: 7, Seed: 1894201176, Size: 1024x1024, Model hash: 31e35c80fc, Model: sd_xl_base_1.0, Denoising strength: 0.9, Clip skip: 2, ADetailer model: face_yolov8n.pt, ADetailer confidence: 0.3, ADetailer dilate erode: 4, ADetailer mask blur: 4, ADetailer denoising strength: 0.4, ADetailer inpaint only masked: True, ADetailer inpaint padding: 32, ADetailer version: 25.3.0, Downcast alphas_cumprod: True, Version: v1.10.1
sd webui的图像放大
不同的图像生成模型都有一个最佳生成分辨率。例如 stable diffusion 1.5 最佳生成分辨率为 512x512,而 stable diffusion xl 最佳生成分辨率为 1024x1024。
但这些分辨率的图像对于现在的网站来说,还是有些太小了。
由于模型的最佳分辨率的限制,目前我们无法直接获取更大分辨率的图像。那么我们该如何获取更大分辨率的图像呢?
答案就是将图像进行无损放大。sd webui 提供了图像放大功能。可以将一个低分辨率的图像放大到高分辨率。
高清分辨率修复
高清分辨率修复功能,原理就是先生成一张低分辨率的图像,然后再通过图生图的功能,以这个低分辨率的图像为基础再重新生成生成一个高分辨率的图像。
如图是高清分辨率修复的示例。 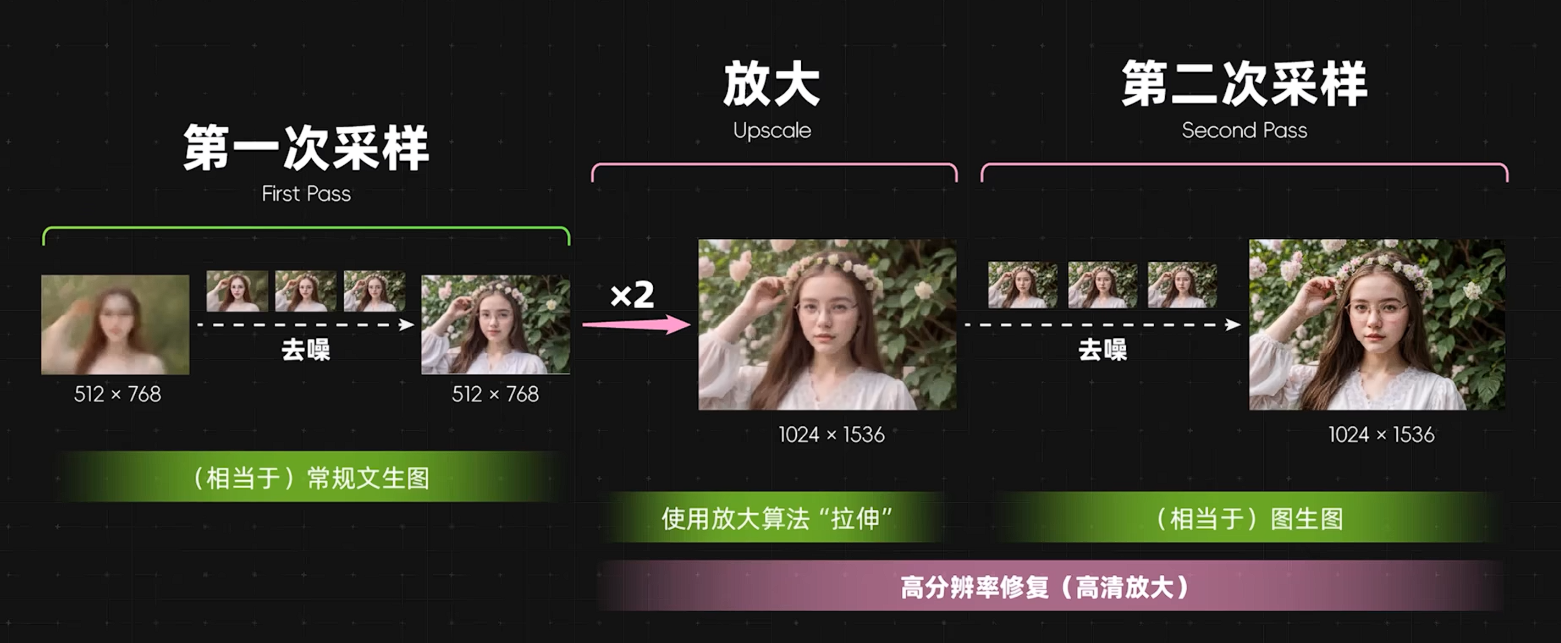
如图是sd webui中高清分辨率修复的设置。由于高清分辨率修复功能类似图生图,因此也需要设置降噪强度。 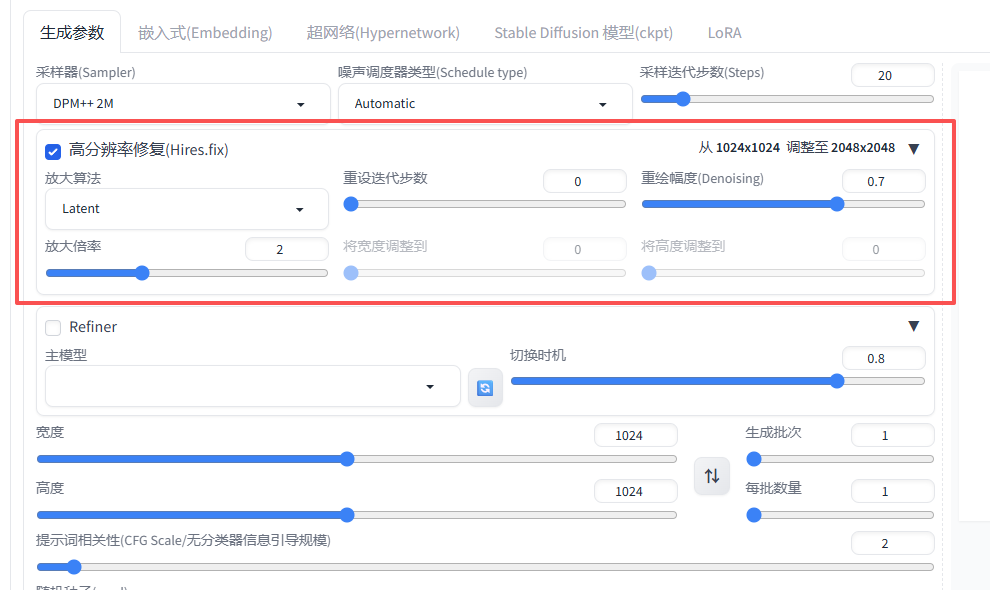
放大算法
如图是sd webui中放大算法的设置。 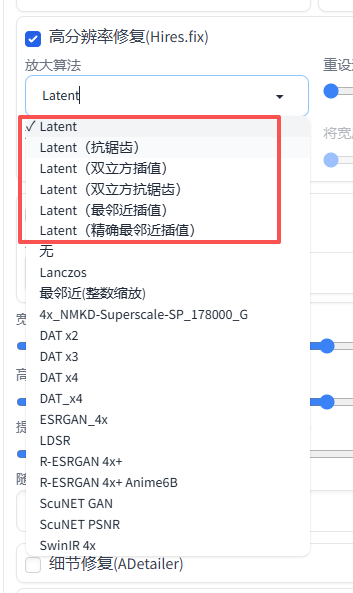
放大算法主要分为两种,一种是潜空间类型的,即以latent-xxx 等放大算法。一种是以非潜空间类型的,即以upscale 等放大算法。
潜空间类型的放大算法
潜空间类型的放大算法,是先将原图在模型潜空间中进行放大,然后再生成出来。
- 优点:由于是在"潜空间"中进行放大,所以效率高。
- 缺点:由于是在"潜空间"中进行放大。因此放大的时候,更容易改变原图的结构和细节。
- 推荐:推荐使用Latent 放大算法即可。
注意:潜空间类型的放大算法。会给放大过程带来更多不确定的变化。可能会出现一些不期望的结果。
非潜空间类型的放大算法
非潜空间类型的放大算法,是再原图生成之后,再进行放大。
- 优点:由于原图生成之后,再进行放大。所以放大的时候,不会改变原图的结构和细节。
- 缺点:效率低,由于是在"非潜空间"中进行放大,所以效率低。
- 推荐:推荐使用R-ESRGAN 4x+ 放大算法即可。其中R-ESRGAN 4x+ Anime6B 是针对动漫图片的放大算法。
注意:非潜空间类型的放大算法。给放大过程带来了确定性。不会出现一些不期望的结果放大。
放大算法模型 网站
对于有些放大算法需要放大模型的支持。因此需要在网上下载放大算法模型。
OpenModelDB 模型网站 https://openmodeldb.info/
如图是网站截图 
sd 放大脚本(分块放大)
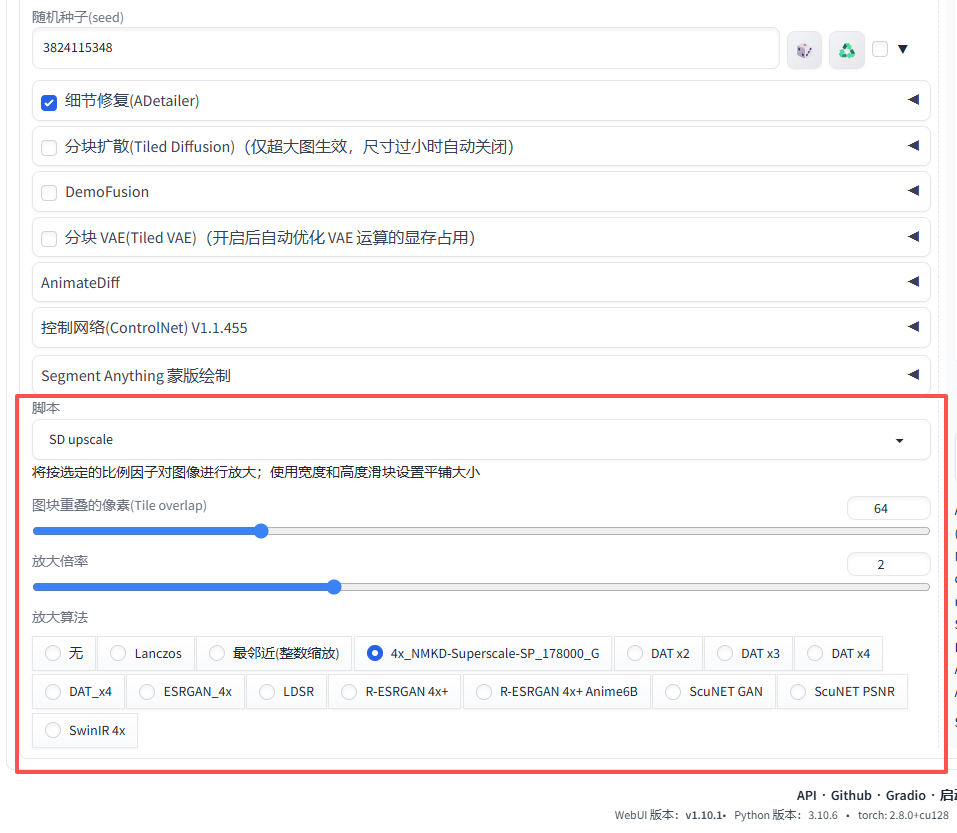
在sd webui的图生图功能中,有一个脚本的选项。里面可以选着放大脚本。通过这个放大脚本去进行图像的放大。
如图所示 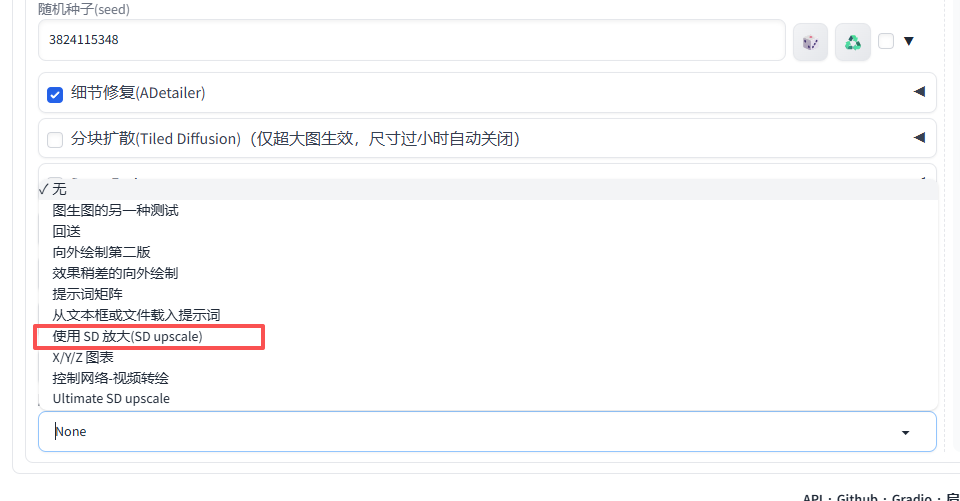
选中放大脚本选项后,就可以进行放大算法,放大图像的分辨率的参数选择了。
sd 放大脚本的原理
该放大脚本的原理是将原图分成多个小块,每个小块进行放大。最后将所有小块合并起来,就得到了放大后的图像。
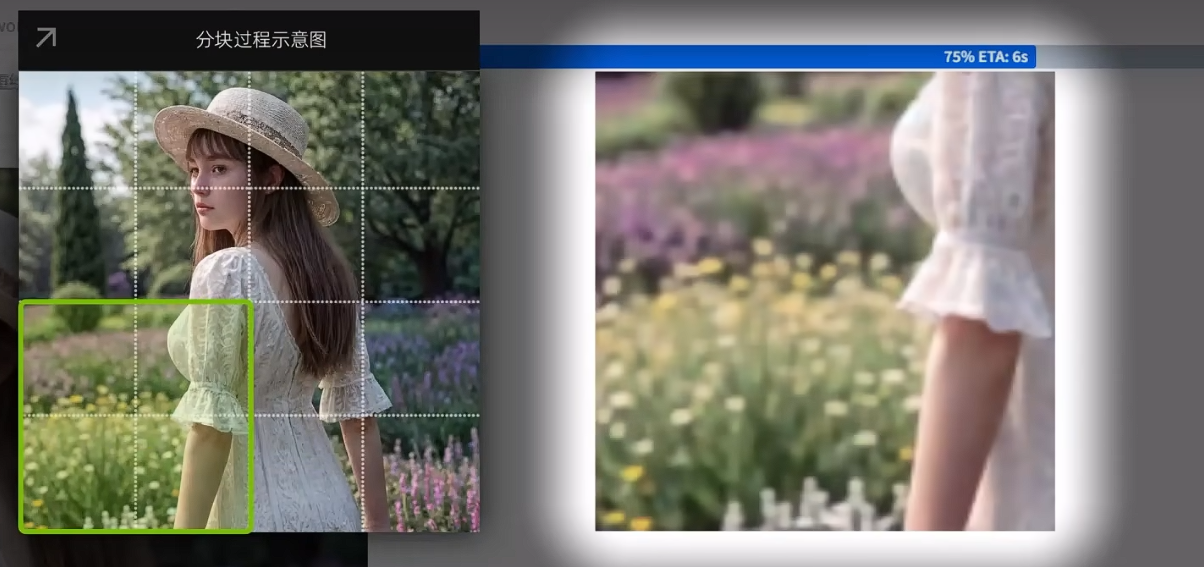
图块重叠像素,是指在给图片分块放大后,然后进行合并小块时,每个小块之间的重叠像素数量。
注意:当图像放大后,发现图块重叠区域有违和感的时候,可以尝试加大图块重叠像素的数量。来解决这个问题。
sd webui 局部重绘
当你生成一张图像的时候,你对这个图像的一些细节上你感觉不太满意,那么你可以使用局部重绘功能,来对这个图像的细节部分进行修改。
局部重绘可以让你对图像的一个特定区域进行重新生成。实现对图像任意区域的内容修改。类似与对图像的局部区域重新进行图生图功能,然后将重新生成的图像与原图像合并起来。
局部重绘允许用户只修改画面中的某个区域,而非整张重画。通过在图像上涂抹蒙版并结合提示词,就能让 AI 定向生成闭眼、换发色、加物体等效果。
在sd webui中,在图生图的菜单中,可以看到局部重绘的功能。
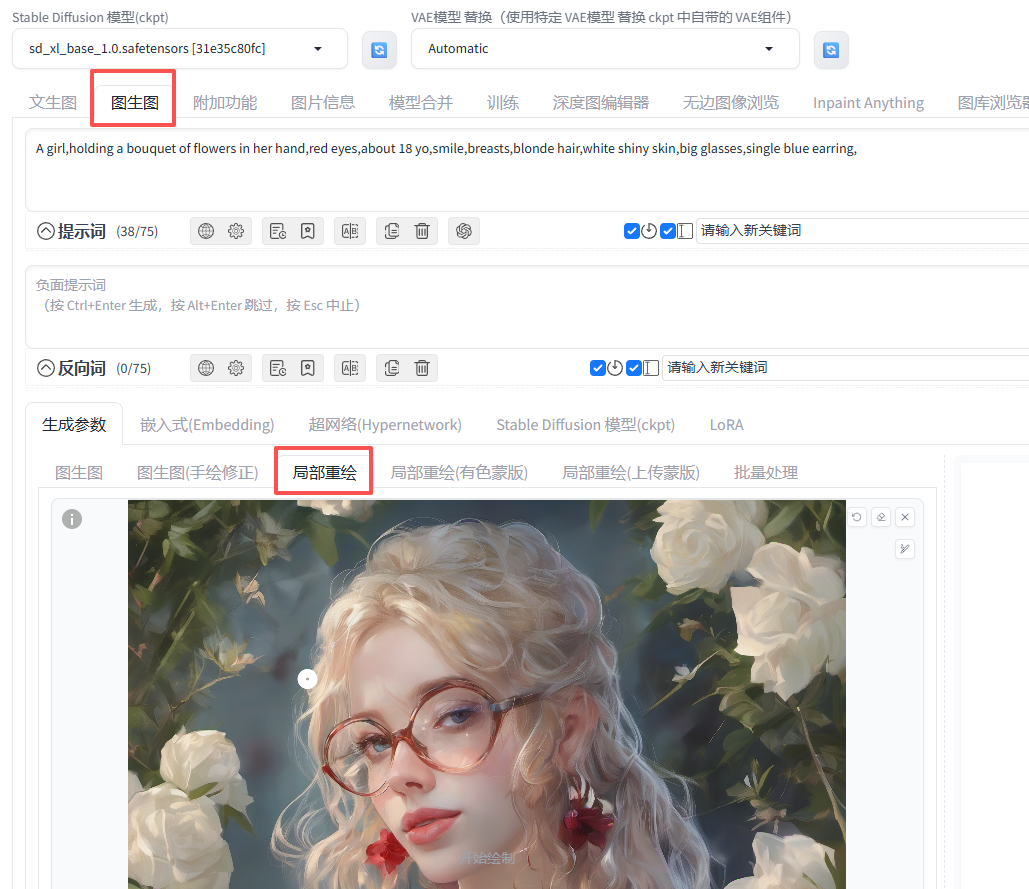
局部重绘参数
如图就是相关的局部重绘参数 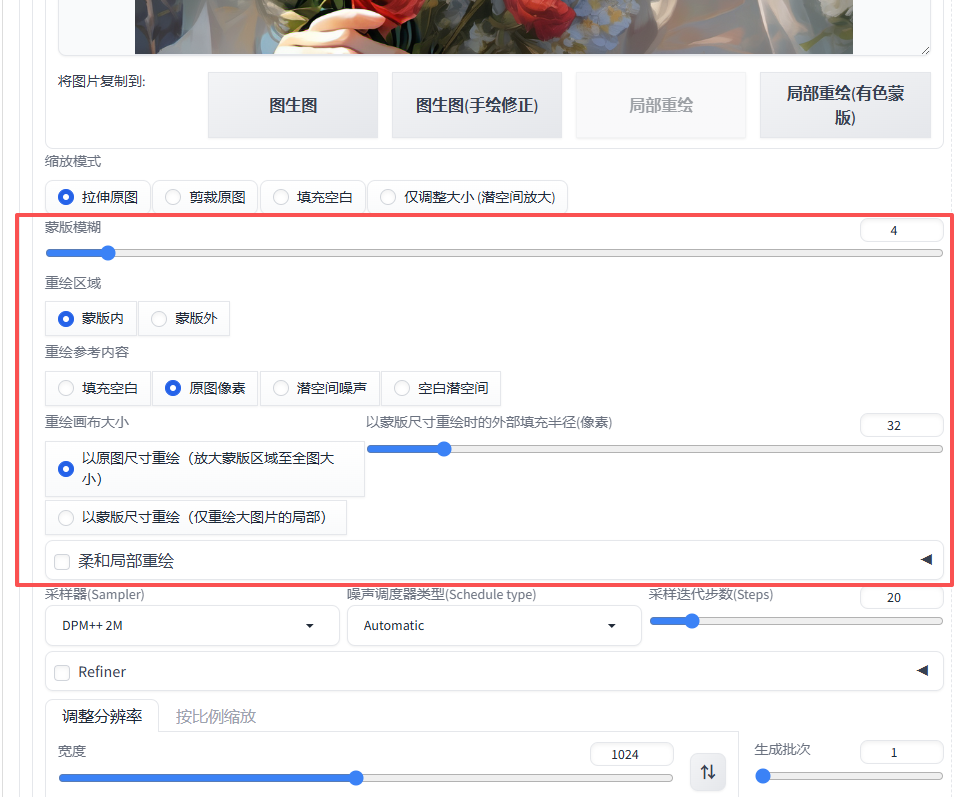
蒙版
蒙版:就是你对图像的一个特定区域进行重绘的区域。
蒙版内就是你对蒙版区域进行重绘。蒙版外就是你对蒙版之外的区域进行重绘。
蒙版模糊是指对蒙版区域和非蒙版区域进行模糊处理。从而让重绘区域的边界更加平滑。不那么有违和感。
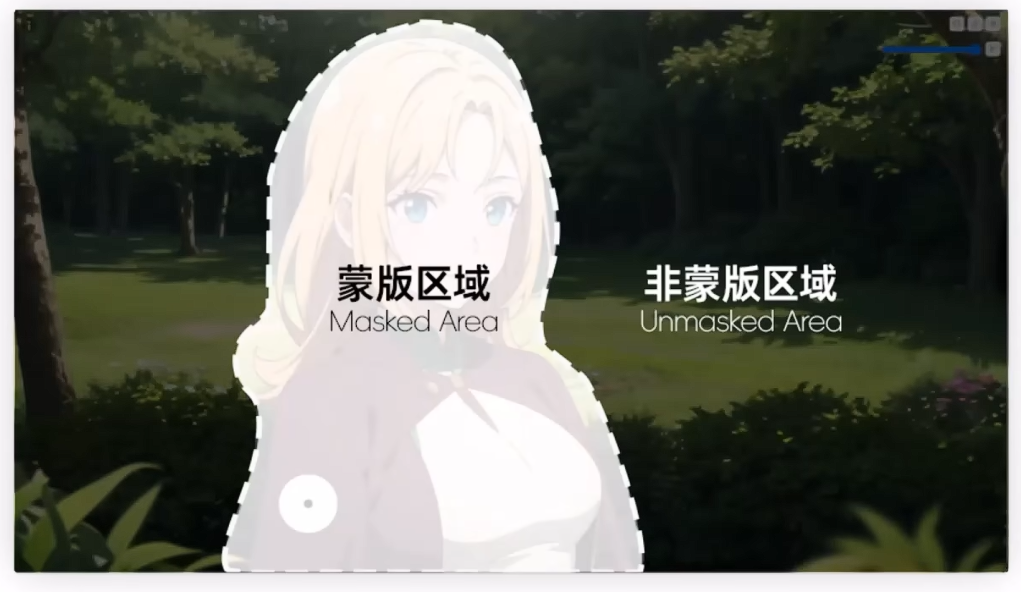
柔和局部重绘
柔和局部重绘选项可以勾选,它能够让重绘区域的边界更加平滑。不那么有违和感。
大多情况下选择默认选项即可。
重绘参考内容
该参数有四个选项。
- 原图像素(默认选项):对重绘区域进行再次图生图功能。适合微调。
- 填充空白:对重绘区域先进行模糊之后,再进行重绘。重绘区域的像素值是填充空白的像素值。
- 潜空间噪声:对重绘区域进行填充潜空间噪声。然后再进行重绘。
- 空白潜空间:对重绘区域进行填充空白潜空间。然后再进行重绘。
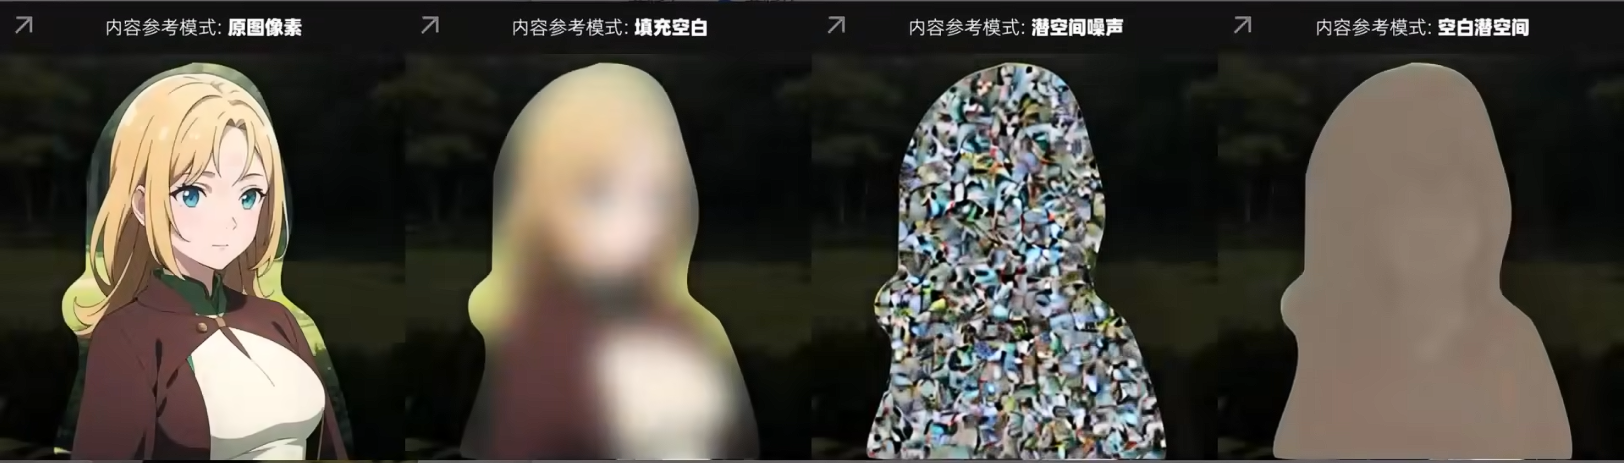
重绘修改强度: 原图像素 < 填充空白 < 潜空间噪声 < 空白潜空间
重绘模型
在进行局部重绘的时候,我们还可以选择特定的重绘模型来对图像进行重绘。
重绘模型相对图像生成模型,可能直接生成图像的质量没有原模型的效果好,但是在重绘功能上,重绘模型是针对重绘功能进行特定强化的。
一般重绘模型的名称是包含有 xxx-inpainting的。
sd webui 局部重绘(有色蒙版)
局部重绘(有色蒙版)相比局部重绘功能,能够更加精确控制重绘区域的形状和颜色。可以理解为在图像上通过画笔进行二次涂鸦。然后结合提示词对二次涂鸦的区域进行局部重绘。
注意:画笔画画的区域就是一个有颜色的蒙版区域,所以才叫有色蒙版。
例如,通过有色蒙版给图像中的一个区域上进行画一块绿色的区域。然后添加提示词绿色的鸟,让这个绿色区域重绘成一只绿色的鸟。
如图所示 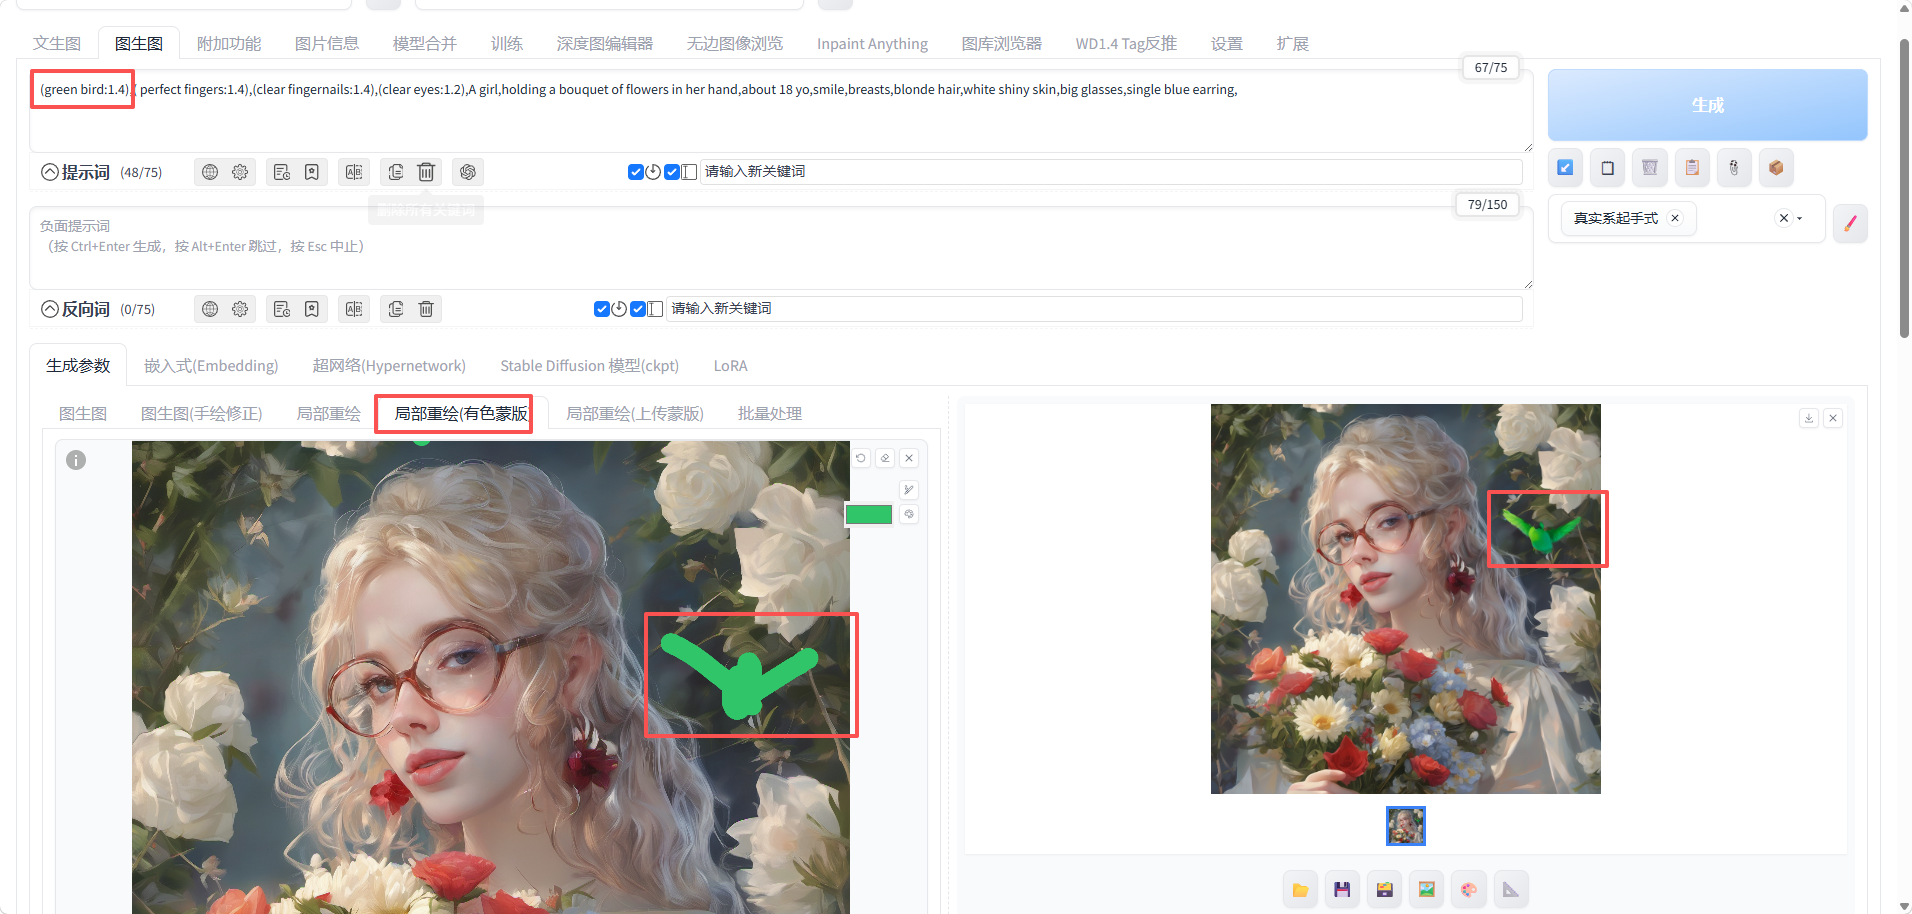
注意:由于这种重绘相对来说改动幅度更大,因此建议将种子值改为-1。此处的改动只会影响重绘区域,不会影响其他区域。
sd webui 图生图(手绘修正)
你可以在原图上进行二次涂鸦。然后结合提示词会对整个原图以及二次涂鸦的区域一起再次进行图生图功能。
图生图(手绘修正) 这个功能和 局部重绘(有色蒙版)功能是差不多的。只不过图生图(手绘修正) 是对整个图像进行图生图功能。而局部重绘(有色蒙版)是只对图像的涂鸦区域进行图生图功能。
区别
- 图生图(手绘修正) 会对原图及其二次涂鸦的区域的地方一起产生改动。
- 局部重绘(有色蒙版)只会对二次涂鸦的区域的地方产生改动,不会对其他区域产生改动。
如图是图生图(手绘修正) 的示例截图 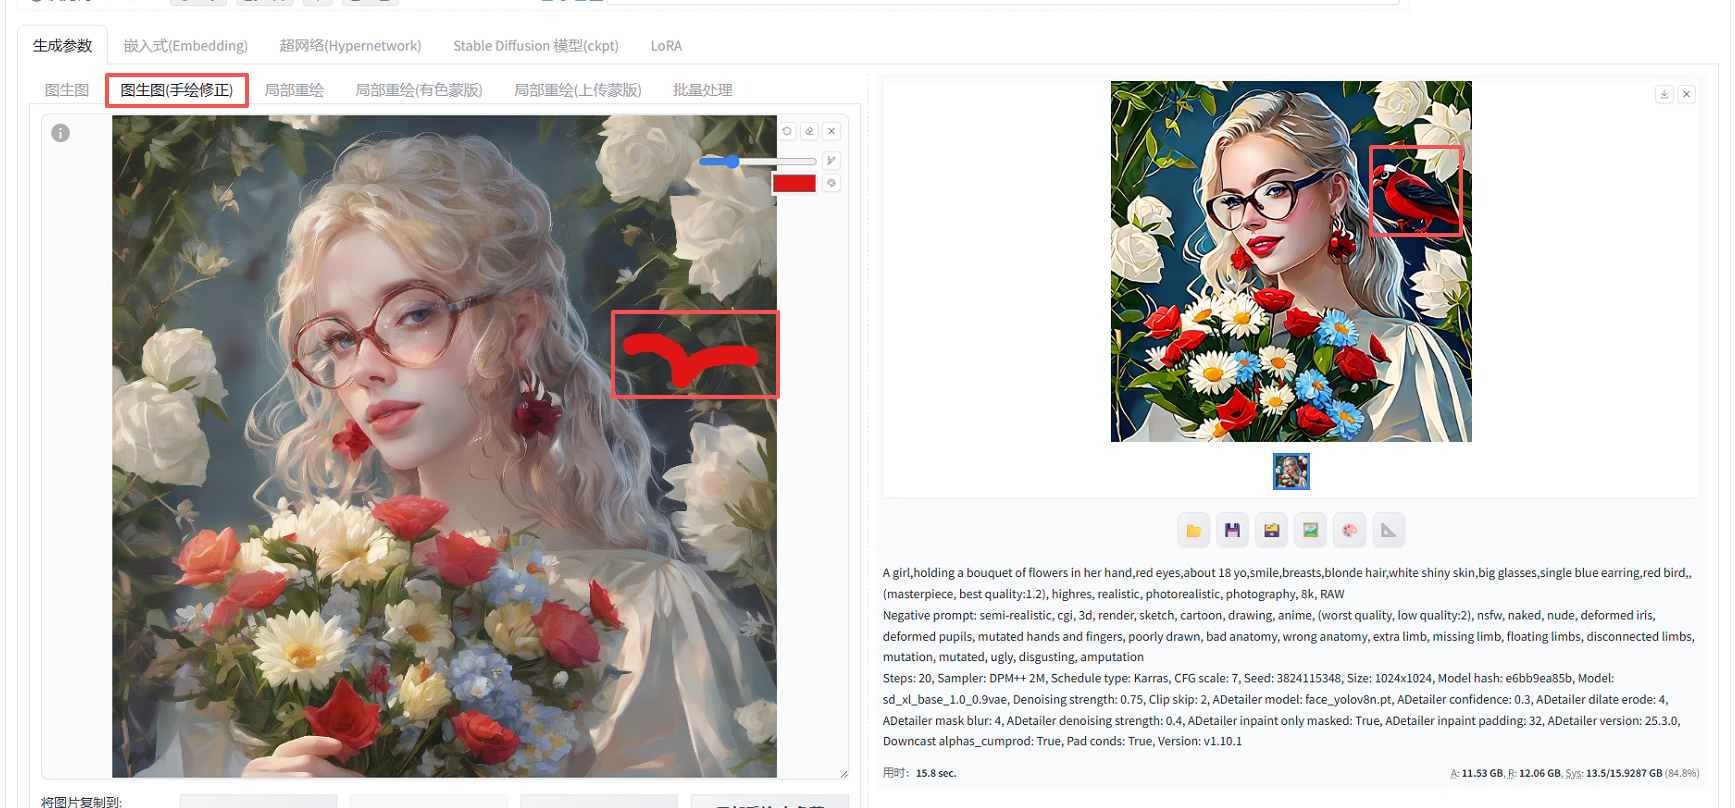
注意:当重绘幅度(降噪强度) 大的时候,整个图像才会有明显的改动,而当重绘幅度(降噪强度) 小的时候,整个图像的改动会比较小。
sd webui 加载 embedding 模型
什么是 embedding 模型?
Embedding 模型是一种轻巧却实用的工具,它能像“打包的提示词”一样,快速赋予生成作品特定的角色特征或风格。例如只需调用角色 Embedding,就能轻松复现动漫人物形象,或通过风格 Embedding 为画面套用水晶雕塑、涂色书等独特质感。
Embedding 还可能带有触发词,用以增强效果。使用触发词可以大幅减少复杂提示词的负担。此外,Embedding 也有“负面”版本,被用于修复 AI 常见的错误,如畸形手、错乱肢体或画面噪点。相比冗长的负面提示词,这类负面 Embedding 更高效、更稳定,成为许多玩家的常备工具。
embedding 模型的使用
embedding 模型不能单独运行,需要搭配图像生成模型来使用。
通过搭配embedding 模型,可以补充图像生成模型的语言能力,从而实现对图像的更精确控制。
例如有的图像生成模型出现的时候比较早,因此该图像生成模型就无法识别新出现的词语。而通过搭配 embedding 模型,就可以补充扩展该图像生成模型的文本语言能力,让其识别新出现的词语。
embedding 模型本身体积很小,通常只有几 KB ~ 几 MB。因此学习的成本很低,速度也很快。通过少量图片(通常3-10张)训练,就能让 embedding 模型学会一个新的"单词"。
embedding 模型安装位置
当我们在模型网站上下载好embedding 模型后,需要将其放到sd webui的安装目录下。路径是:安装目录/webui/embeddings目录
注意:根据适配的图像生成模型来选择embedding模型。
sd webui 加载 embedding 模型
- 先选中正面提示词,或者负面提示词框。
- 然后在sd webui中选择对应提示词效果的embedding 模型即可。
- 选中后,对应的提示词框会出现对应embedding 模型的名词。这就表示该embedding 模型已经被添加到该提示词中了。
注意:embedding 模型有的是用于正面提示词的,有的是用于负面提示词的。
如图是sd webui中选择embedding 模型。 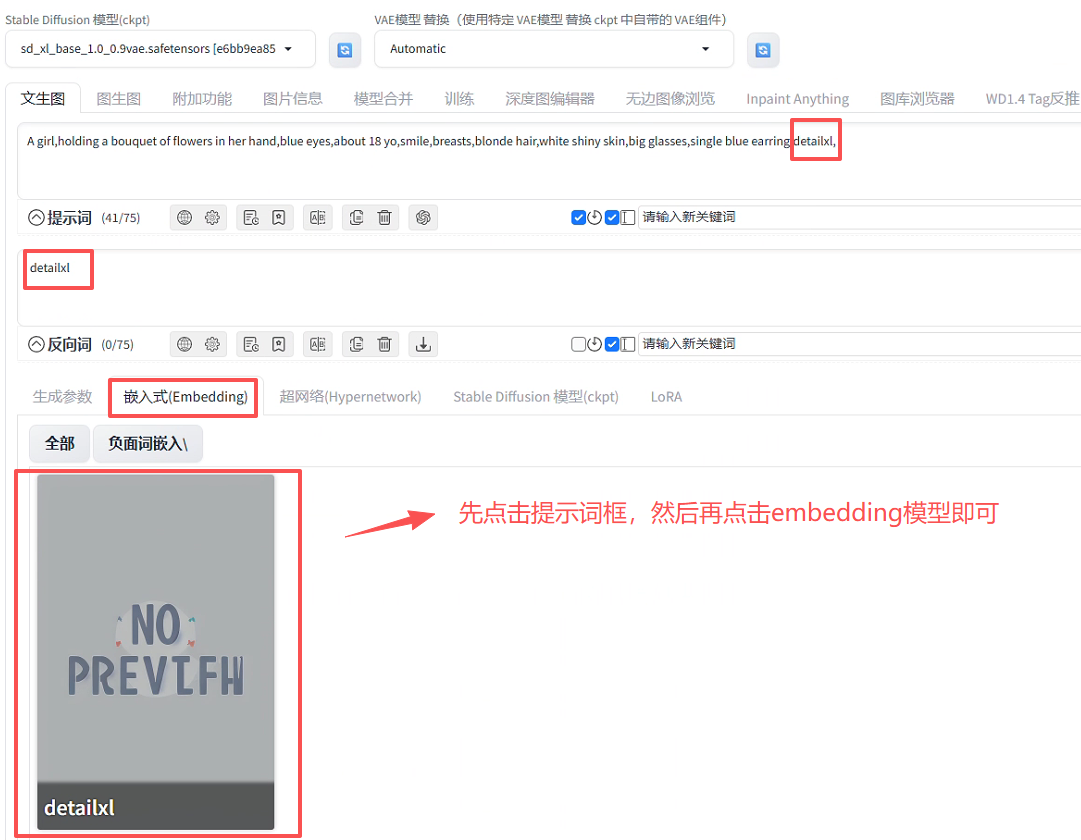
用法1:理解新词
当图像生成模型无法识别新出现的词语的时候,就可以通过搭配 embedding 模型来补充扩展该图像生成模型的文本语言能力。即让图像生成模型能够识别新出现的词语。
例如,有的图像生成模型无法认识新的词语 "电锯人 玛琪玛"。而通过搭配 embedding 模型(关于电锯人的),就让该图像生成模型识别 "电锯人 玛琪玛"。
注意:详细用法还是需要参考embedding 模型的文档。
用法2:装饰风格
例如当我们想要生成一张素描风格的图片的时候,就可以通过搭配 embedding 模型(关于素描风格的),来让该图像生成模型能够快速生成素描风格的图片。
注意:详细用法还是需要参考embedding 模型的文档。
用法3:消除负面影响
当使用图像生成模型生成一个效果不好的图片的时候,就可以通过搭配 embedding 模型(关于负面提示词的),来消除该图片的负面影响。
例如,生成的图片关于手指部分有负面效果,我们可以加载一个关于手指的负面提示词的embedding 模型。来消除手指部分的负面效果。
注意:详细用法还是需要参考embedding 模型的文档。
sd webui 加载 Lora 模型
什么是 Lora 模型?
Lora模型是完全基于模型本体的一小部分模型参数进行训练的微调产物。因此Lora模型不可以独立运行,只能搭配对应的模型本体一起使用。
Lora 模型就像给模型本体 定制了一个扩展包。通过将LoRA模型与模型本体 搭配使用,通过权重调节控制作用强弱,既能固定角色与 IP 形象,也能迁移特定画风,或植入发型、服饰,加速图像生成等。
Lora 模型与Embedding 模型的区别?
与 Embedding 相比,LoRA 在还原人物特征和稳定性上表现更好,甚至能通过多个 LoRA 叠加组合实现风格与形象的双重控制。
sd webui 加载 Lora 模型的用法
- 下载好 Lora 模型后,需要将其放到sd webui的安装目录下。路径是:
安装目录/webui/models/lora - 然后在sd webui中选择对应 Lora 模型即可。
- lora模型提示词格式为:
<lora:模型名称:权重>
如图所示 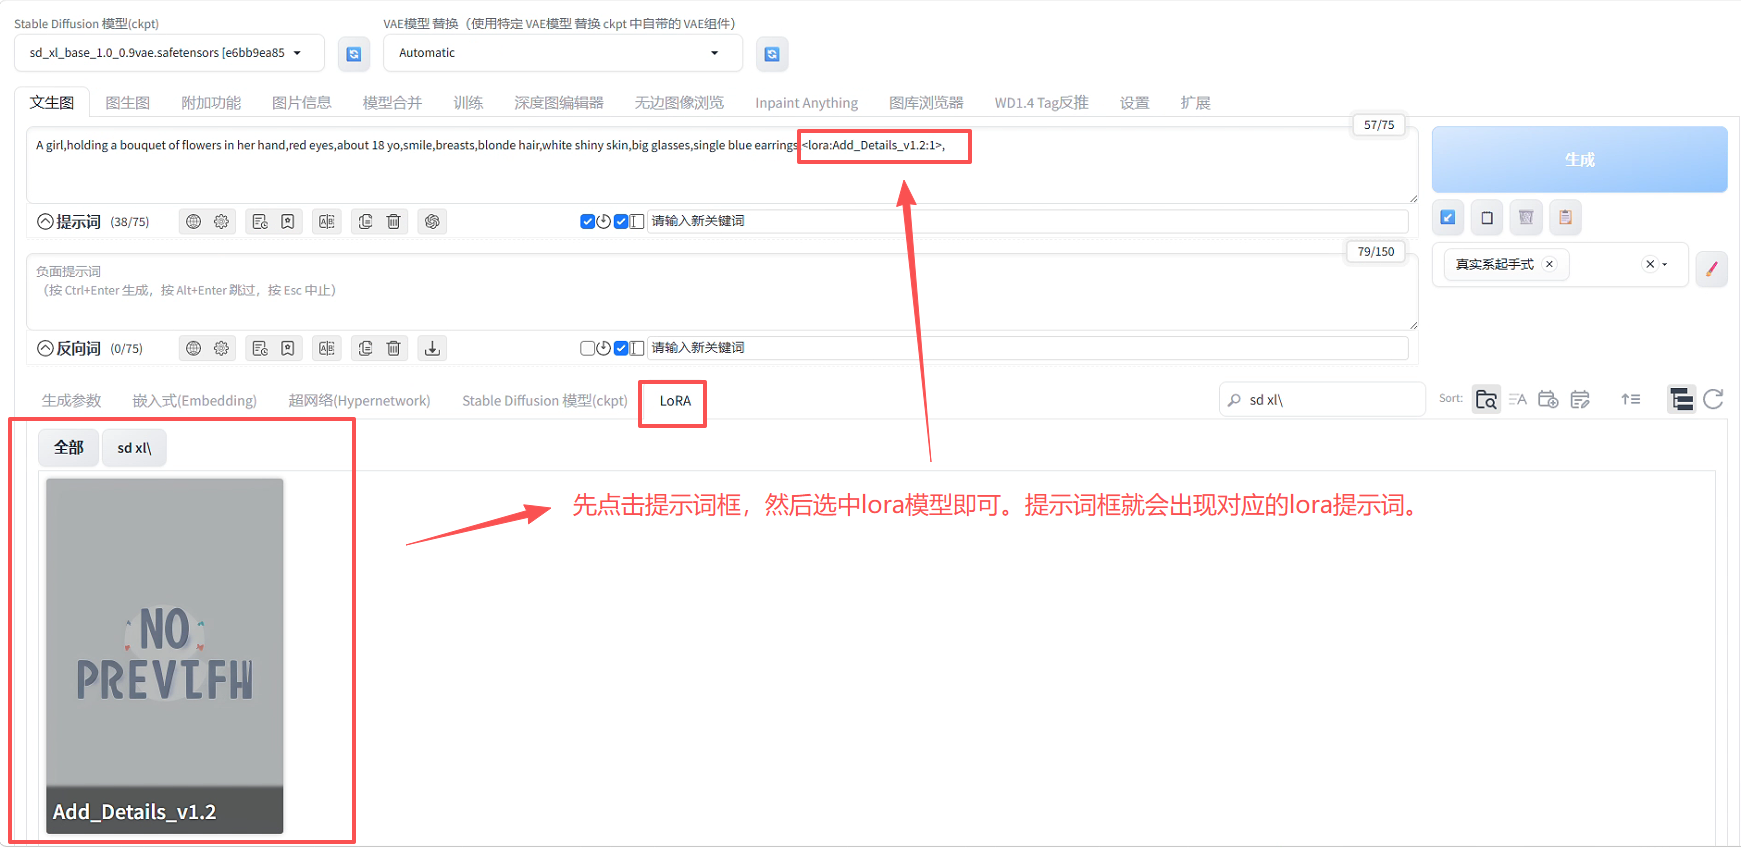
注意:lora 模型的详细用法还是需要参考Lora 模型的文档。有时候还需要添加其他的提示词来提高 Lora 模型的效果。
用法1:角色类Lora模型
例如我们想生成某一个角色的大量图片,就可以通过搭配 Lora 模型(关于该角色的),来让该图像生成模型能够快速生成该角色的图片。
注意:详细用法还是需要参考该Lora 模型的文档。
用法2:风格类Lora模型
例如添加一个 Lora 模型(关于某个动漫风格的),就可以让该图像生成模型能够快速生成 某个动漫风格的图片。
注意:详细用法还是需要参考该Lora 模型的文档。
用法3:功能类Lora模型
例如给某个图像中的人物切换各种特征。例如发型,衣服,鞋子,表情等。或者实现其他功能。
我们都可以搭配 Lora 模型(对应功能的)来实现该功能。
注意:详细用法还是需要参考该Lora 模型的文档。
用法4:加速类Lora模型
Lora模型除了能为图像提供更多功能外,还能加速图像生成。例如,搭配一个加速类Lora模型(关于加速的),就可以让该图像生成模型能够快速生成图片。
这种能够加快图像生成的Lora模型,叫做加速类Lora模型。其核心作用是把传统 20~30 步采样压缩到 2~8 步,总生成时间直接缩短 60%~90%,是扩散模型主流提速方案。
通常情况下,加速类的Lora模型,在命名上会包含:lighting,turbo,light等字样,以及推荐采样步数的数字。例如:qwen-image-edit-2509-lightning-4steps-v1.0-bf16.safetensors。 这个就是qwen的加速lora模型,推荐采样步数为4步。
注意:当使用加速类Lora模型时,需要修改采样器的采样步数为对应加速类Lora模型的采样步数。还有调低采样器的CFG值。
注意:详细用法还是需要参考该Lora 模型的文档。
sd webui 扩展插件
如图是sd webui中扩展插件页面,可以在这里下载和安装各种扩展插件。 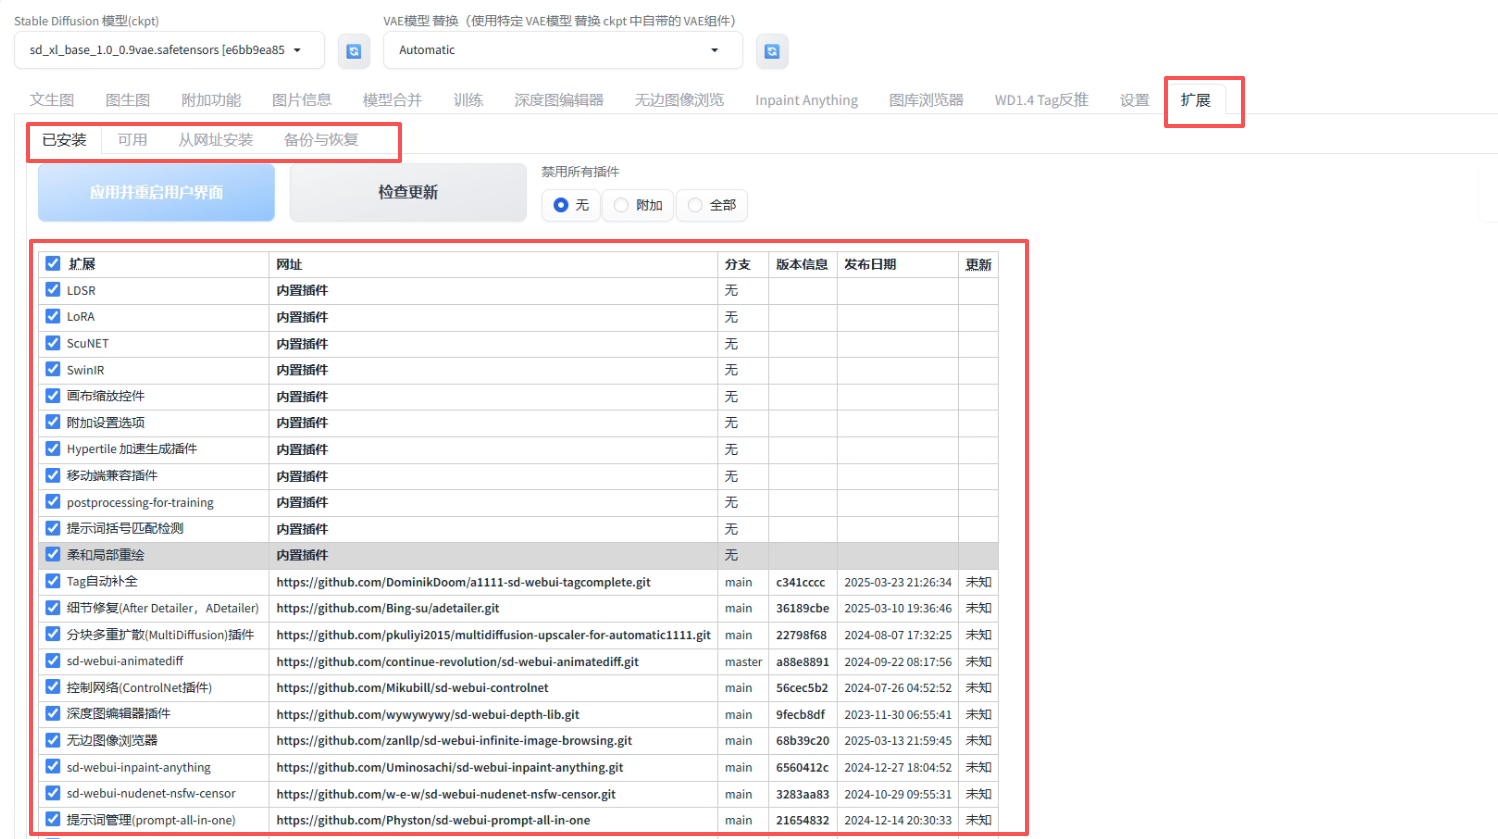
sd webui ControlNet
什么是 ControlNet ?
一般情况下,通过图像生成模型生成的图像,会根据文字提示词,自由发挥,人物姿势、物体轮廓很容易画崩、变形。就算是通过图生图的方式,也与原图有很大的差异。
而 ControlNet 就像一根 “定形支架”,强制让图像生成模型 严格按照你给的图片轮廓、姿势、结构去画,不让它乱变形。
如图所示,先将原图通过预处理器,生成控制图。再将控制图通过ControlNet模型,生成图像。 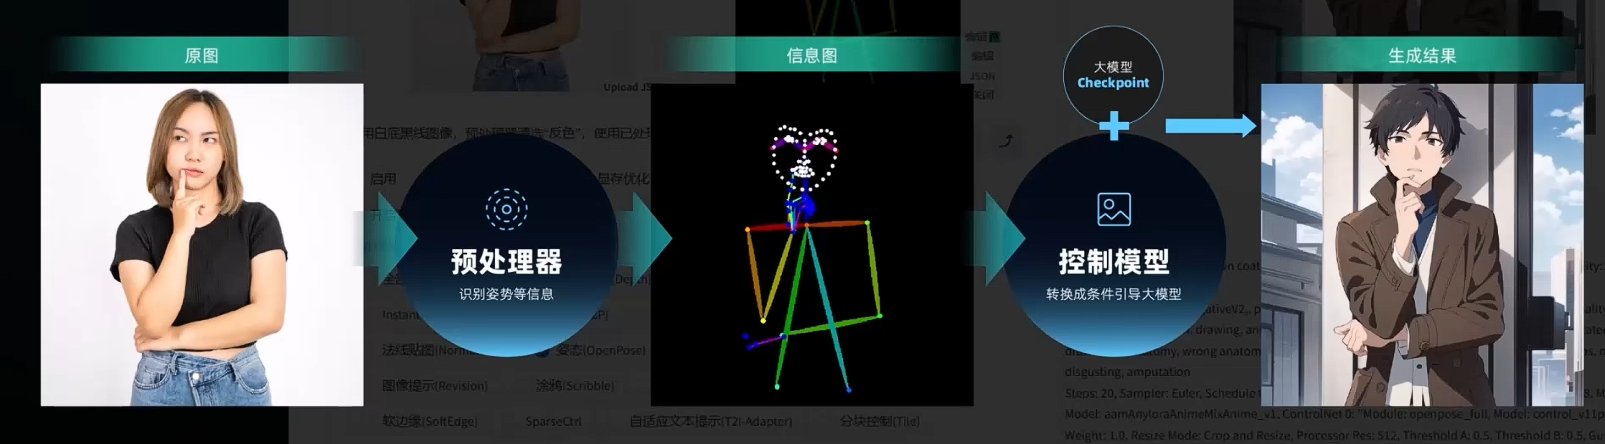
注意:ControlNet模型必须配合对应架构的基础模型协同工作。
使用 ControlNet 控制网络
当我们安装了ControlNet 控制插件后,就可以sd webui界面中找到对应的ControlNet 选项。
例如我们想要让 ControlNet 控制网络来分析图像中人物的姿态。可以按下面步骤操作
- 选择原图
- 选择 ControlNet 控制网络模型类型为 "OpenPose",即姿态分析
- 选择对应姿态分析预处理器和姿态分析模型(需要搭配对一个模型本体)。如果没有,需要去模型网站下载。
- 点击旁边的“爆炸”图标的按钮,可以预览原图的人物姿态分析结果。
- 输入提示词“一个女性骑士”。然后点击生成按钮
- 此时图像生成模型会根据 人物姿态分析结果,来生成一个女性骑士的图片。
如图所示 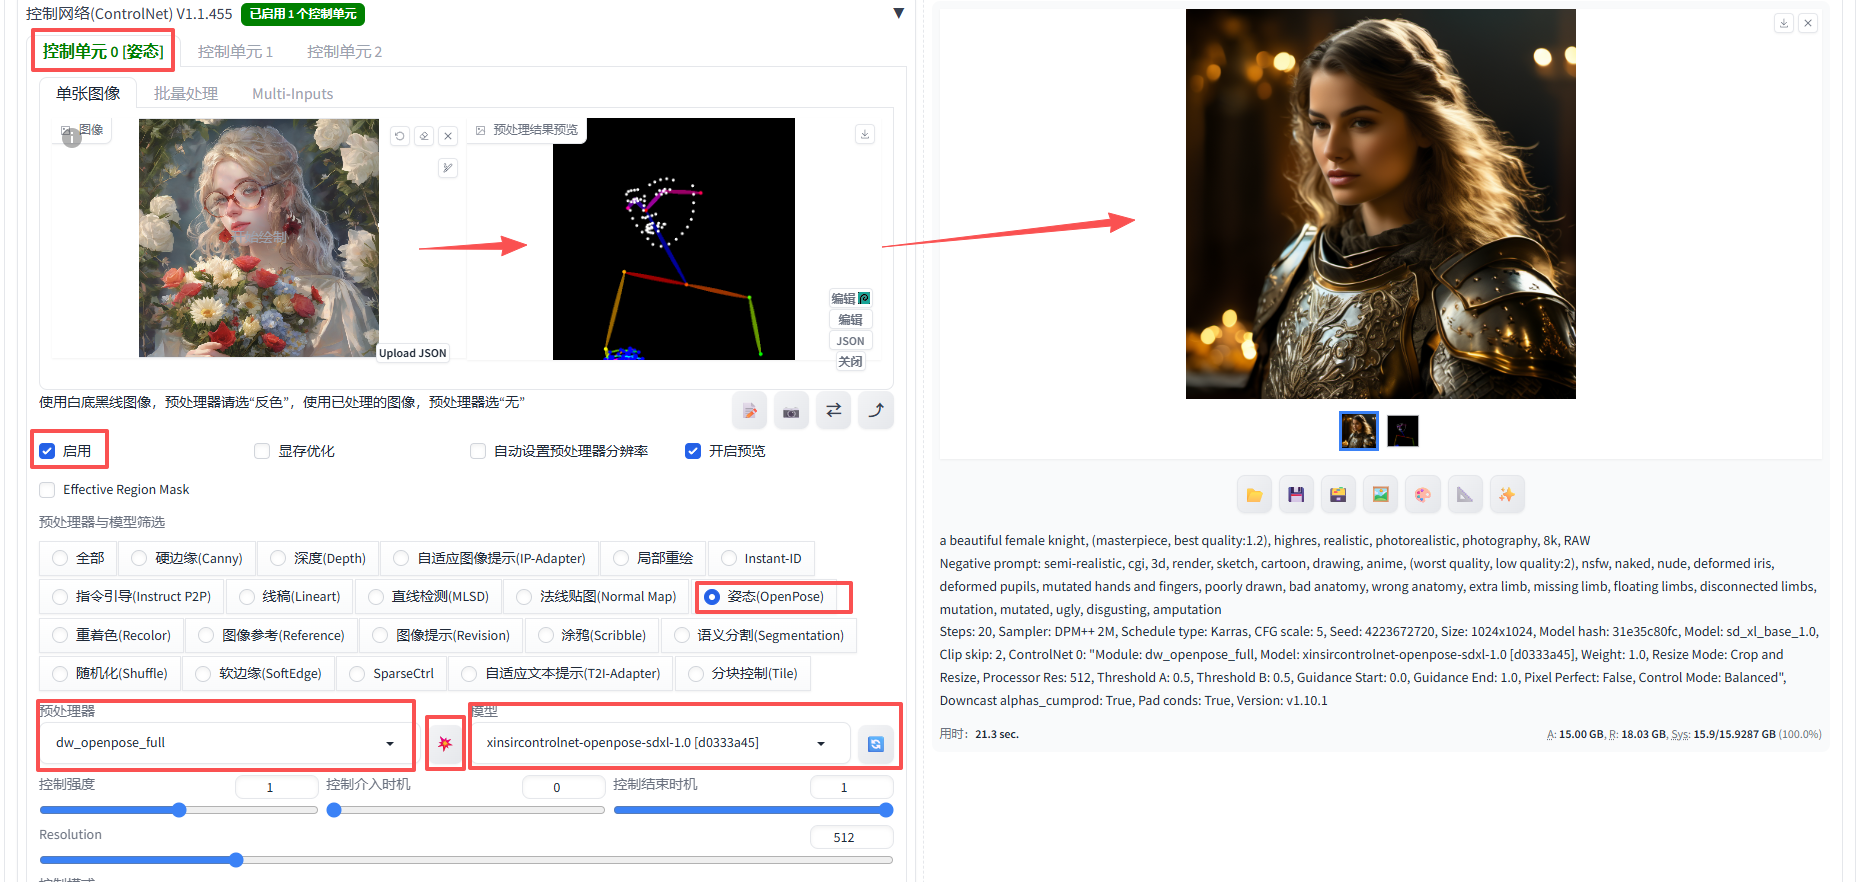
ControlNet 控制网络的选项
sd webui 中的 ControlNet 控制网络选项如图所示
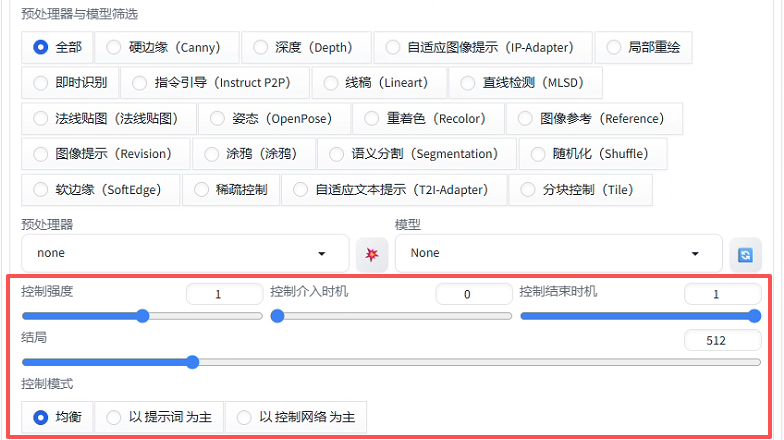
控制强度
控制强度是新图相比原图的还原度。范围从0-2,默认为1。
如图是不同控制强度下的效果对比图。 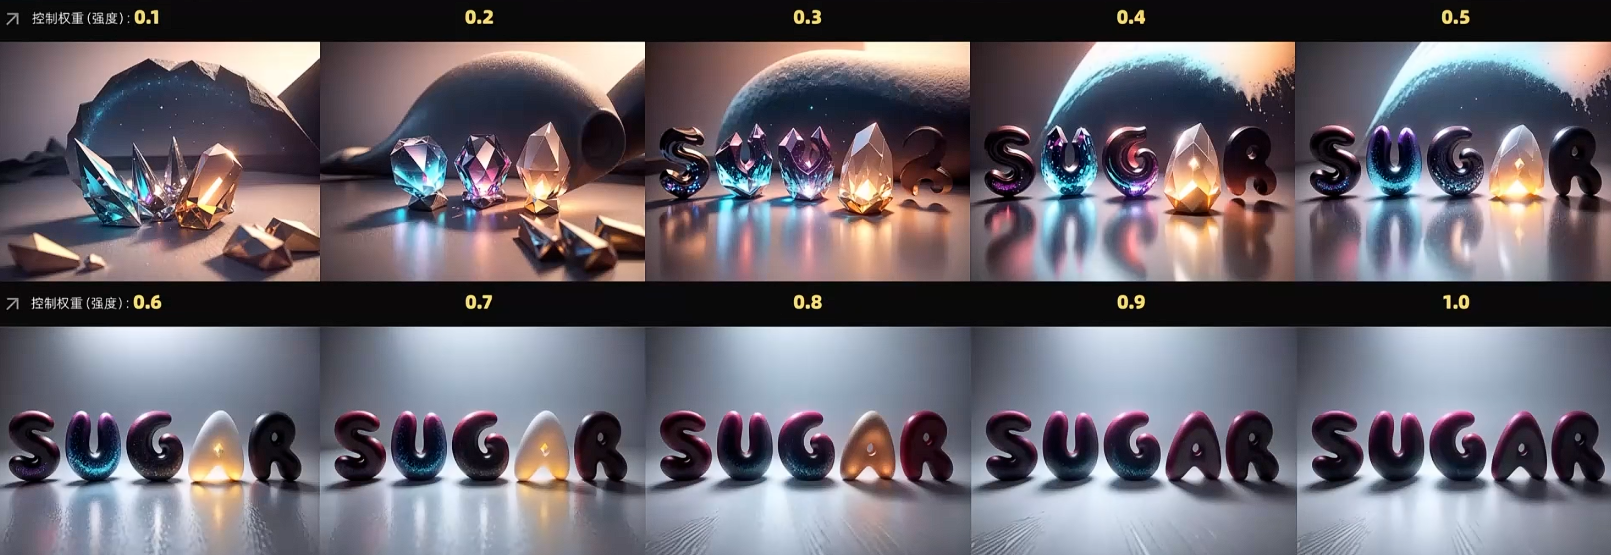
注意:控制强度越大代表越按照原图的特征来生成,越小代表越灵活。
控制时机
控制时机分为开始时机和结束时机。
控制时机是 ControlNet 控制网络在生成图像时,什么时候开始工作,什么时候结束工作。
范围从0-1。默认开始时机为0,结束时机为1。
如图是不同控制时机下的效果对比图。 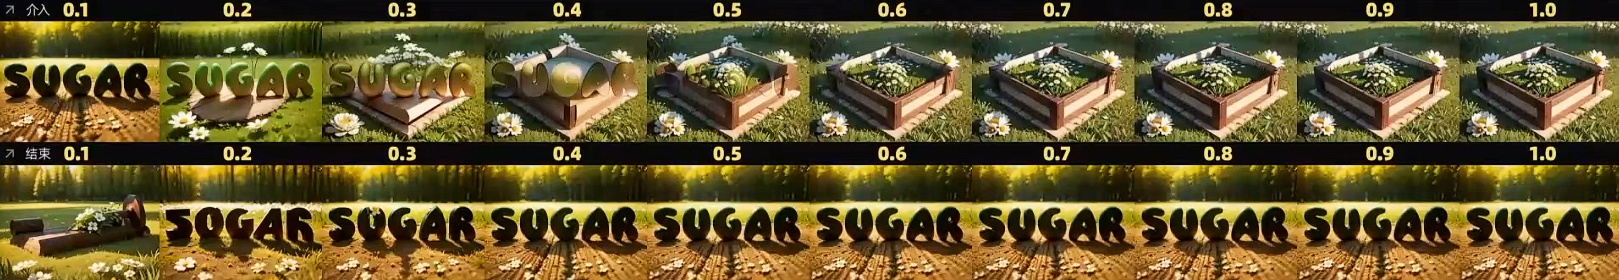
注意:开始时机太晚或者结束时机太早,会导致控制网络在生成图像时,没有足够的时间来工作。导致控制效果不理想。
ControlNet 控制网络的各种模型介绍
根据上面图片所示,ControlNet 控制网络分为20多种类型的模型。每个类型的模型都有其特定的功能和适用场景。
模型分类
表格是部分模型的介绍:
| 序号 | 模型名称 | 作用 | 使用场景 | 特点 |
|---|---|---|---|---|
| 1 | Canny(边缘检测) | 检测图像边缘,控制轮廓形状 | 线稿上色、轮廓控制、保持特定形状 | 对线条要求不高,草图也能使用 |
| 2 | OpenPose(姿态估计) | 检测人体关键点,控制人物姿势和动作 | 人物动作控制、多人互动场景、角色动画 | 支持单人、多人姿态检测 |
| 3 | Depth(深度图) | 生成深度图,控制空间关系和透视 | 场景布局、透视控制、3D 效果增强 | 支持多种深度估计模型 |
| 4 | Segmentation(分割图) | 将图像分割为不同区域,分别控制 | 区域风格化、内容替换、多主题生成 | 需要精确的分割标注 |
| 5 | Tile(平铺控制) | 通过局部图像块控制生成 | 高清修复、图像扩展、细节增强 | 对显存要求较低 |
| 6 | Scribble(涂鸦控制) | 根据简单涂鸦生成图像 | 草图生成、创意快速表达 | 对绘画技巧要求极低 |
| 7 | Lineart(艺术线稿控制) | 根据简单艺术线稿生成图像 | 艺术线稿上色 | 对线条要求不高,草图也能使用 |
| 8 | Softedge(软边缘控制) | 根据简单软边缘生成图像 | 软边缘控制, 水彩、手绘风格 | 对软边缘要求不高,草图也能使用 |
| 9 | Normal Map(法线贴图控制) | 根据简单法线贴图生成图像 | 3D 渲染、光照控制 | 对法线要求不高,草图也能使用 |
应用层面分类
在应用层面,ControlNet 的控制类型大致分为三类:
- 强控制:如 Canny、LineArt、SoftEdge、Depth,它们严格固定图像的结构和轮廓,适合用来复现主体形象、线稿上色、风格转绘或保持画面构图。例如用 Canny 给线稿快速上色,用 Depth 让建筑或景观作品具备真实的空间感,甚至能通过深度图修复人物手势。
- 弱控制:如 OpenPose、Scribble、Segmentation,它们把控更宽松,给模型保留更多发挥空间。OpenPose 能精准复现复杂姿势,并且可通过姿势编辑器手动摆出任意动作;Scribble 则允许用户用随意的涂鸦勾勒大致轮廓,AI 会在此基础上自由生成;Segmentation 通过语义分割让用户能添加或替换画面元素,比如往场景中植入一个新人物。
- 功能型控制:如 Tile、Recolor、Inpaint,它们更像为特定场景准备的“工具包”。Tile 用于保持放大或修复时的全局一致性,避免画面分块错乱;Recolor 可以为黑白照片上色或为现有作品整体换色;Inpaint 则赋予任何模型局部重绘的能力,让修改、去除或扩展画面内容变得自然流畅。
在大多数业务场景中,通常是使用多种ControlNet模型来实现复杂的控制效果。比如先用 OpenPose 固定姿势,再用 Depth 辅助空间关系,从而达到单一控制无法实现的效果。
Canny 边缘检测模型(细线条识别)
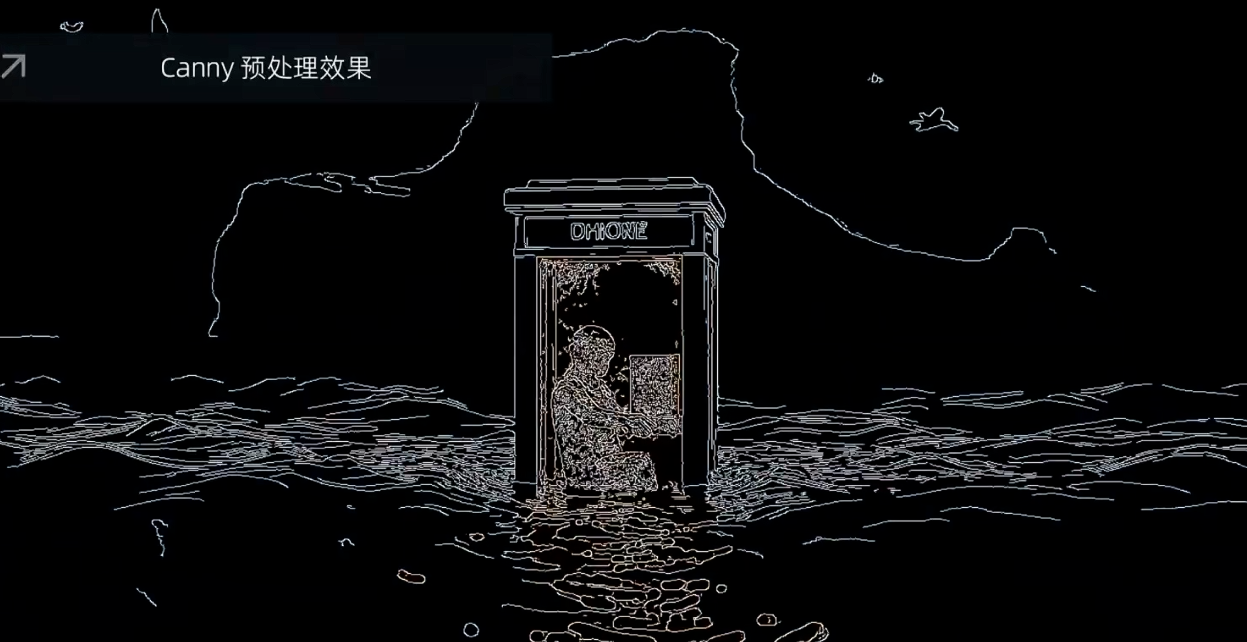
canny 是一种基于 Canny 边缘检测算法的模型。它能够检测图像中的线条边缘识别出来。
如图所示,一个是原图,一个是Canny 边缘检测结果。 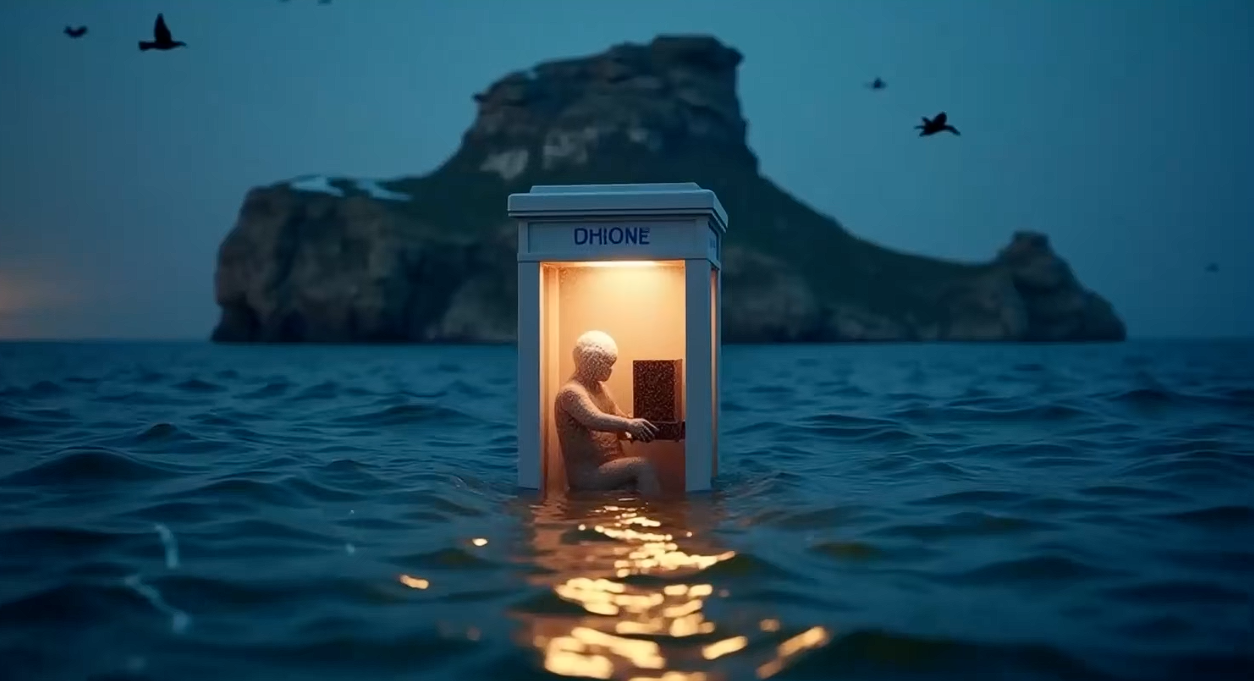
高低阈值选项
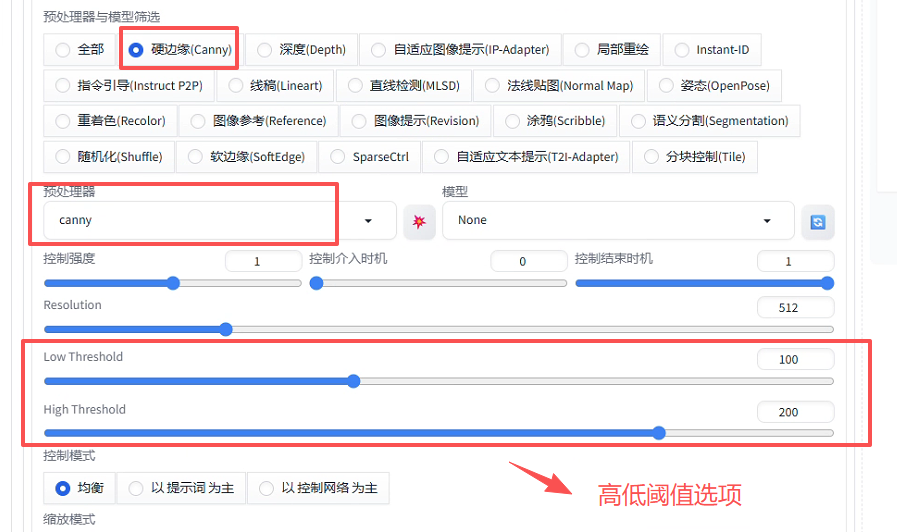
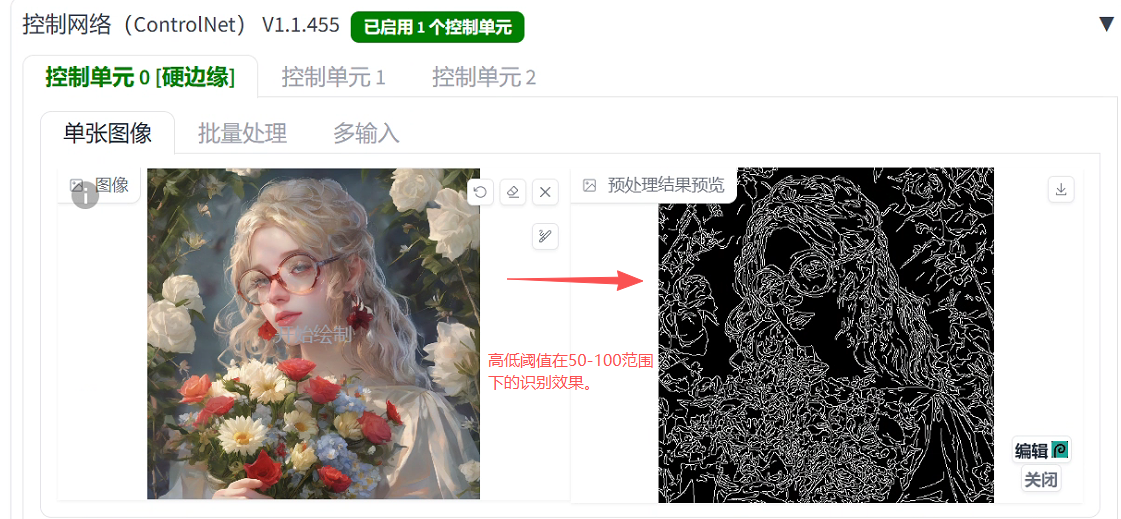
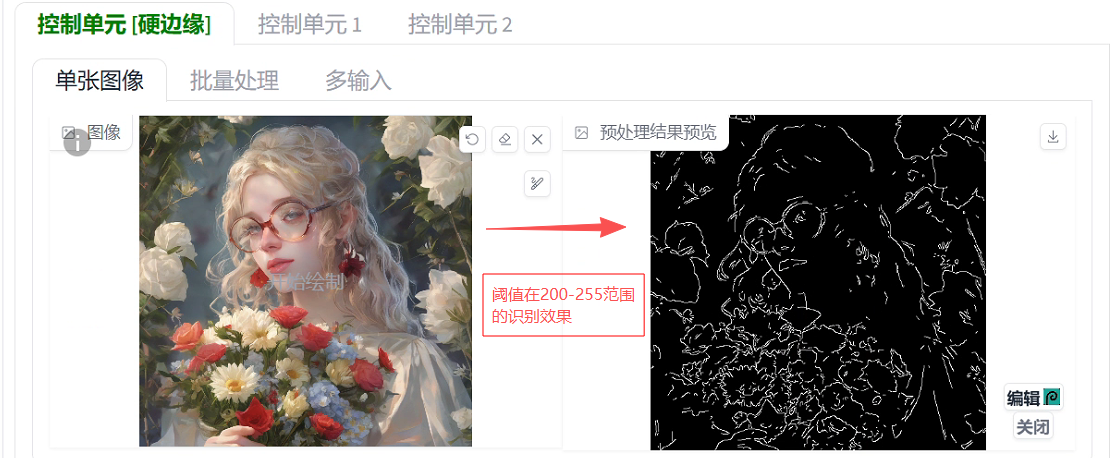
如上图的sd webui界面所示,当使用canny 边缘检测模型时,我们可以手动设置高低阈值选项,来调整线条识别结果。这个高低阈值实际就是线条的粗细范围。默认阈值范围是:100-200。
当高低阈值越低的时候,识别到的线条越多,但也会增加识别错误的可能性。需要根据实际情况调整。
阈值在100-200范围内,识别效果如下 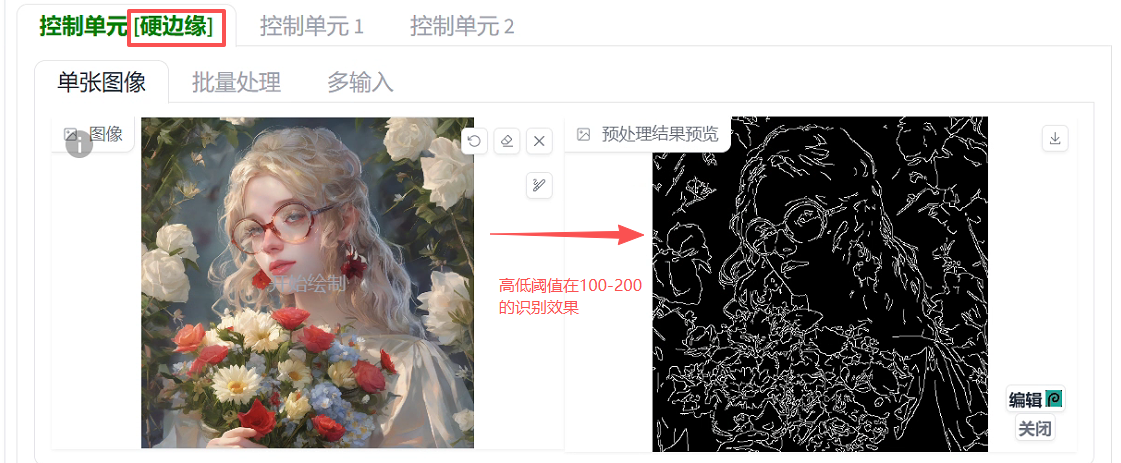 阈值在50-100范围内,识别效果如下,可以发现识别的线条多了许多
 阈值在200-255范围内,识别效果如下,可以发现识别的线条少了许多
应用场景
- 线稿上色
- 轮廓控制
- 保持特定形状
LineArt 艺术线稿模型
LineArt 是一种基于简单艺术线稿的模型。它能够根据原图,生成对应的艺术线稿图像。 如图所示,一个是原图,一个是LineArt 艺术线稿结果。 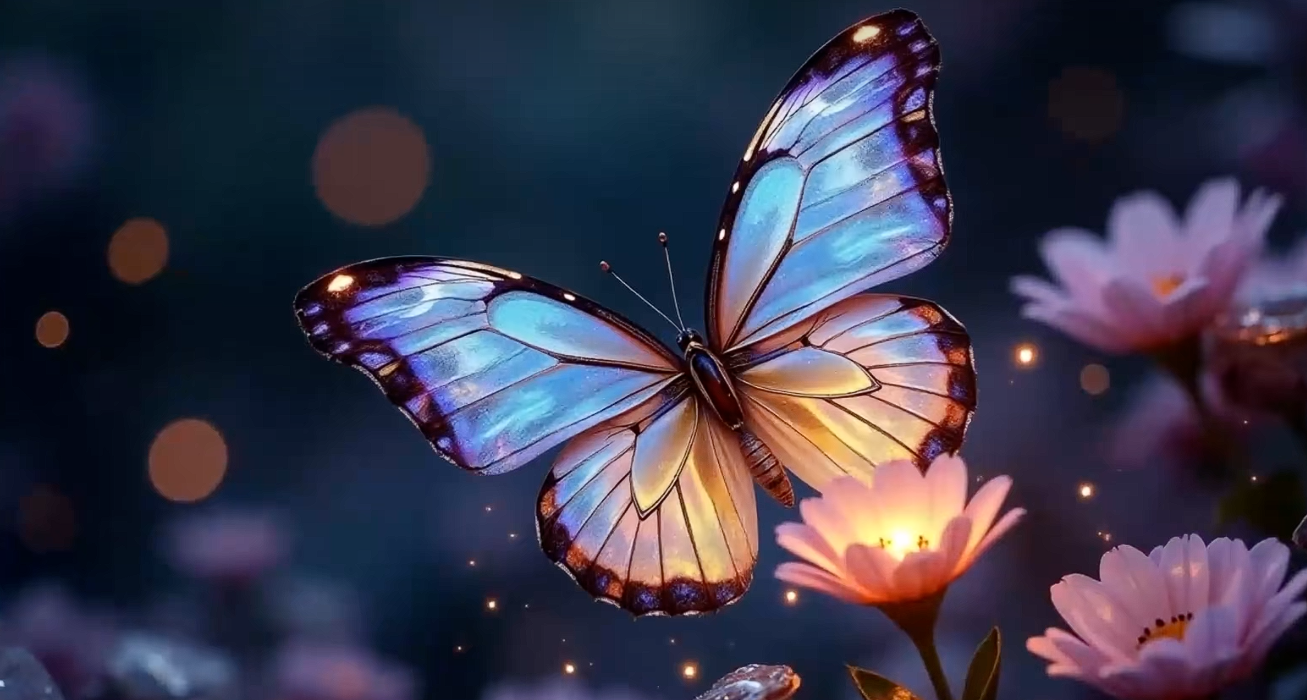
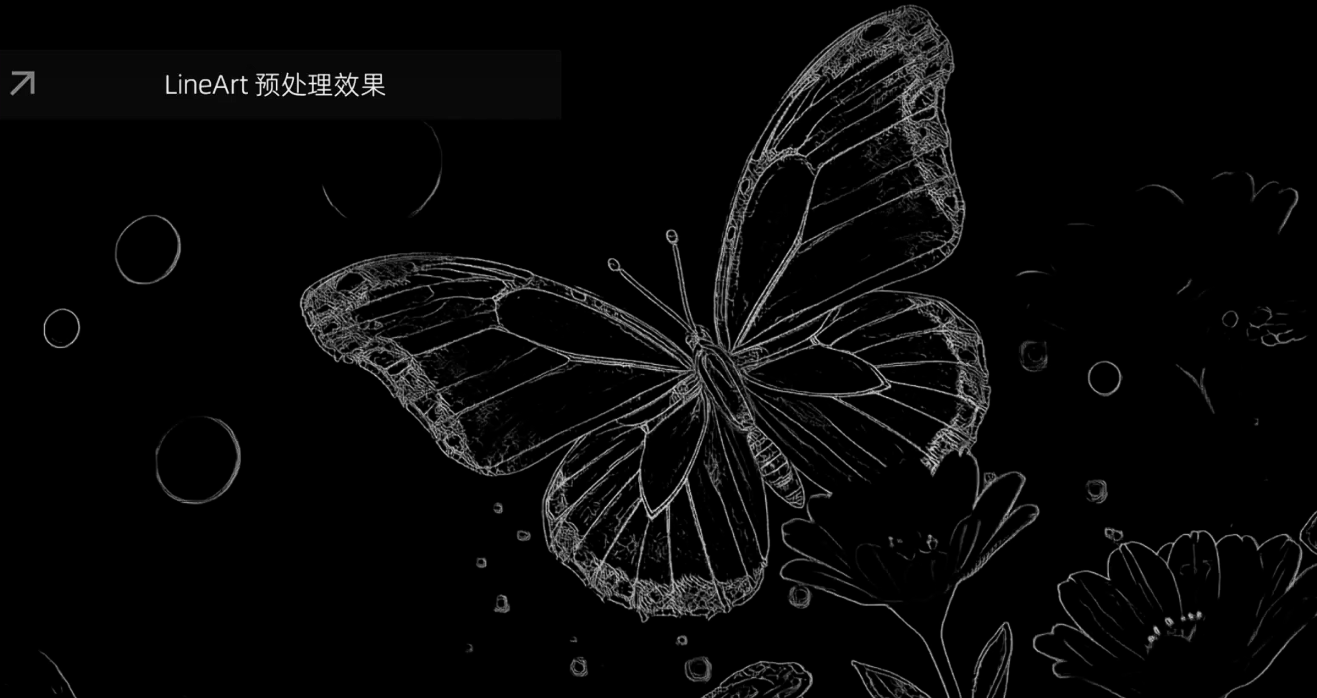
如图为LineArt 艺术线稿识别结果 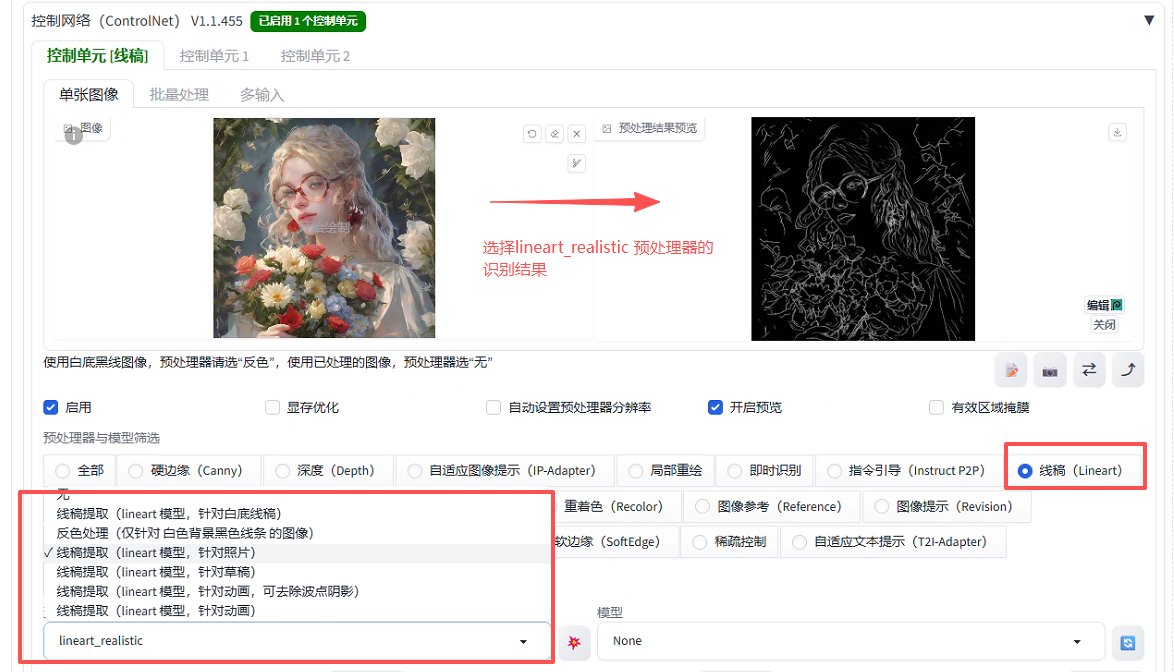
LineArt相关的预处理器
- lineart_realistic 预处理器适合处理真实风格的图像。
- lineart_anime_denoise 预处理器适合处理动漫风格的图像。
如图所示,这是这两个预处理器,分别处理照片和动漫图像的识别结果。 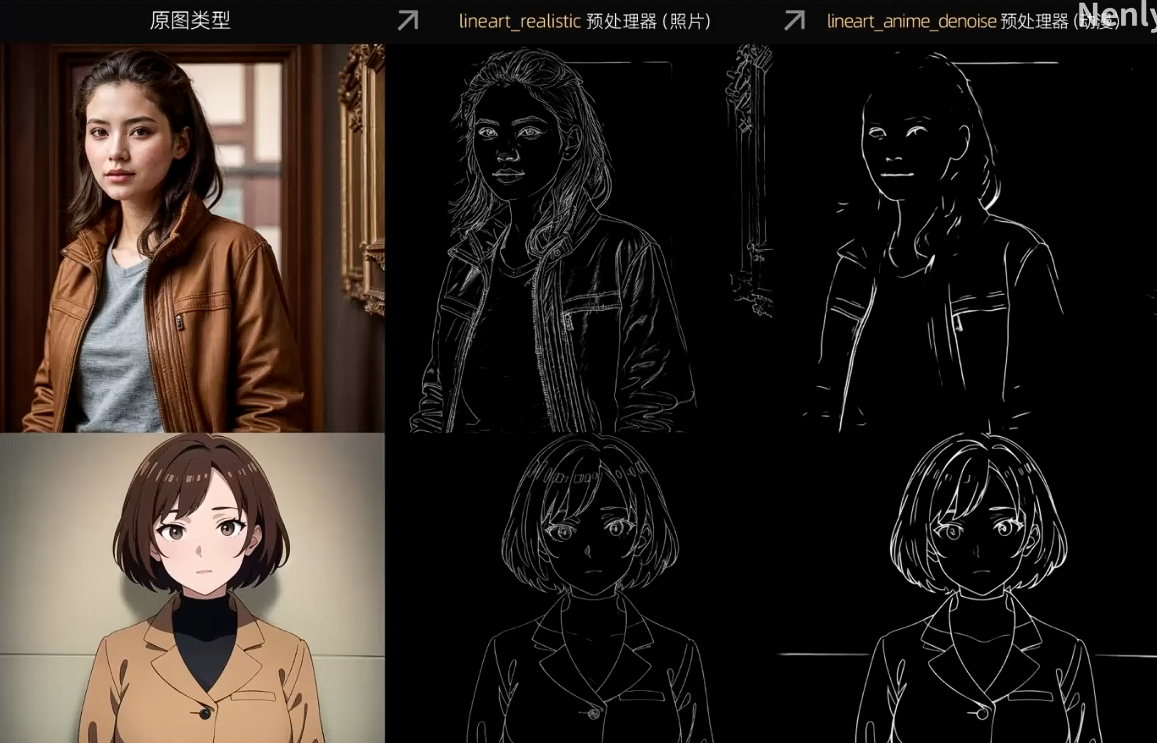
应用场景
- 艺术线稿上色
- 艺术线稿风格转绘
- 艺术线稿保持特定形状
SoftEdge 软边缘模型(大线条识别)
SoftEdge 是一种基于软边缘检测的模型。它能够根据原图,生成对应软边缘检测图像。
如图是通过SoftEdge 软边缘模型,将原图进行识别的结果。 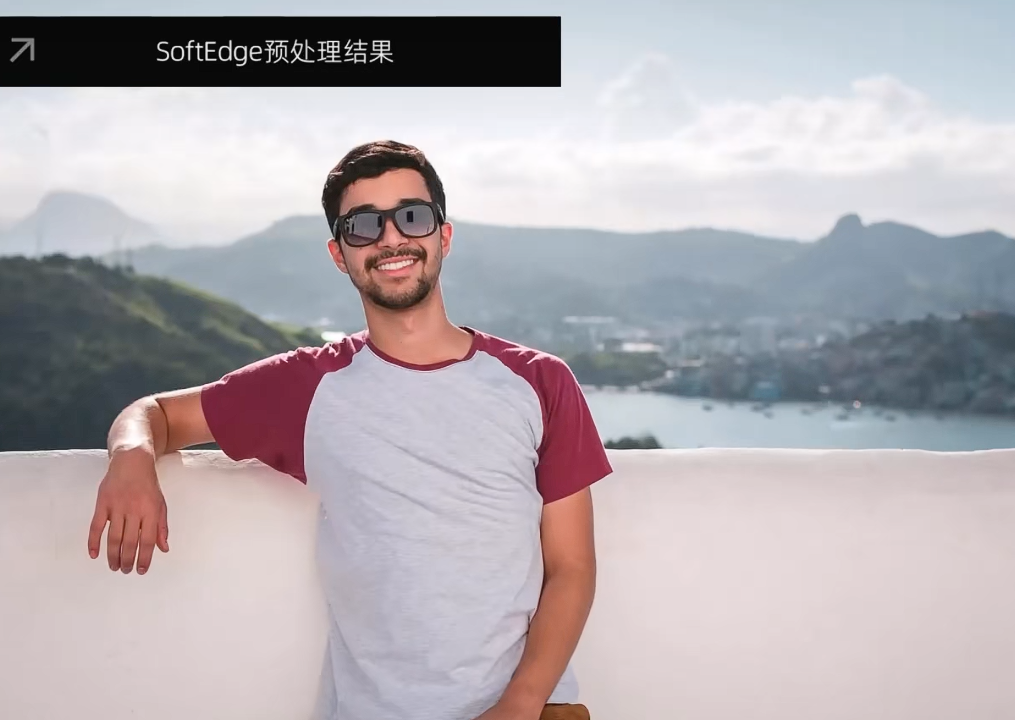
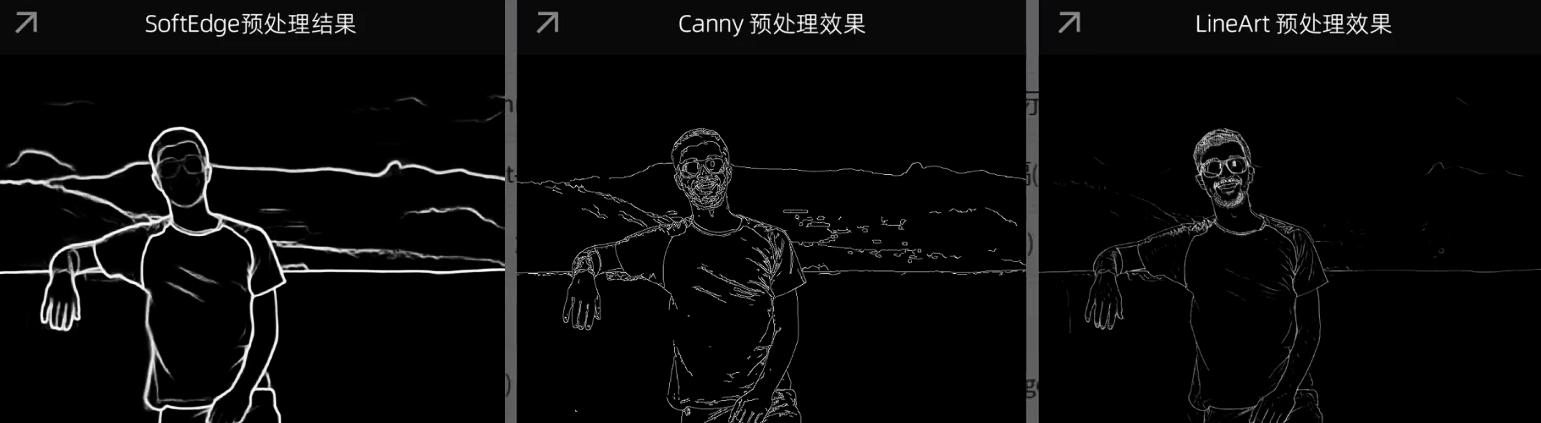
可以看到SoftEdge 模型相比较Canny和Lineart模型,能够识别到图像中的大致轮廓,对于细节部分却识别不那么准确。
下图是同一个提示词下的重新生成的结果对比。 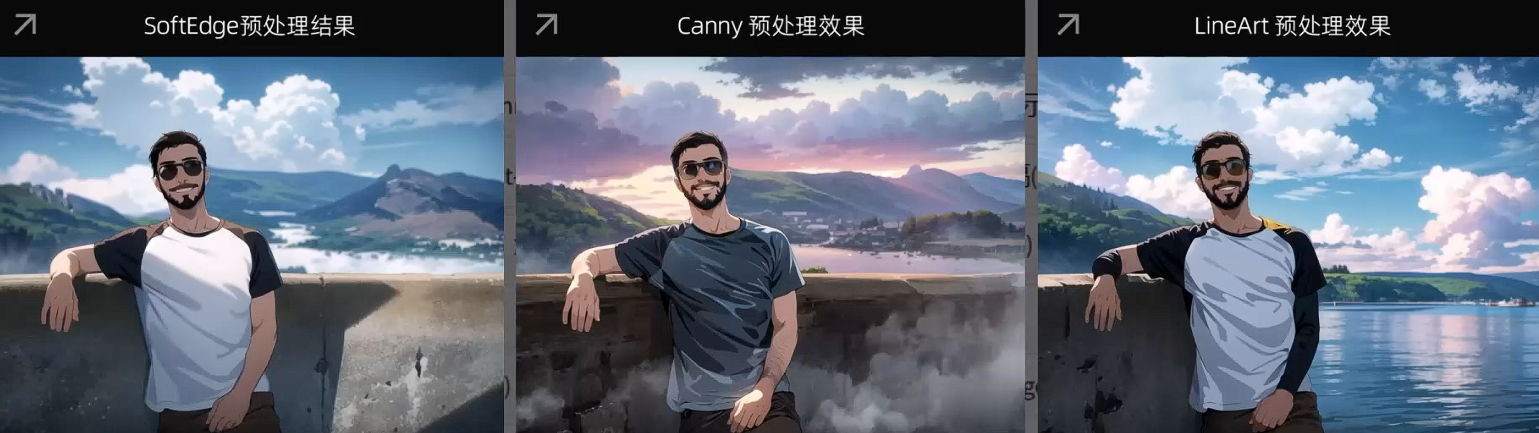
应用场景
由于SoftEdge 模型对于大线条的识别更好,因此生成的新图,在构图和布局上和原图更像。
Depth 深度图图像。
如图所示,通过Depth 深度图模型,将左边原图的深度图生成出来。 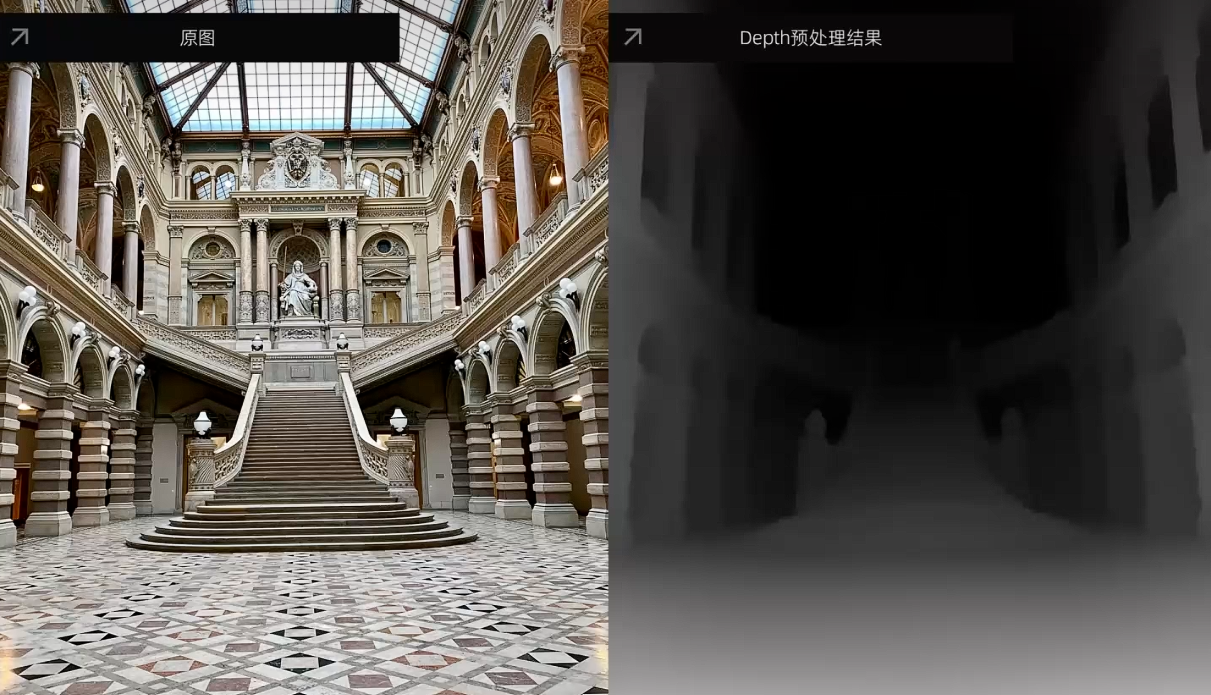
不同的Depth预处理器下,显示的深度图结果不同。 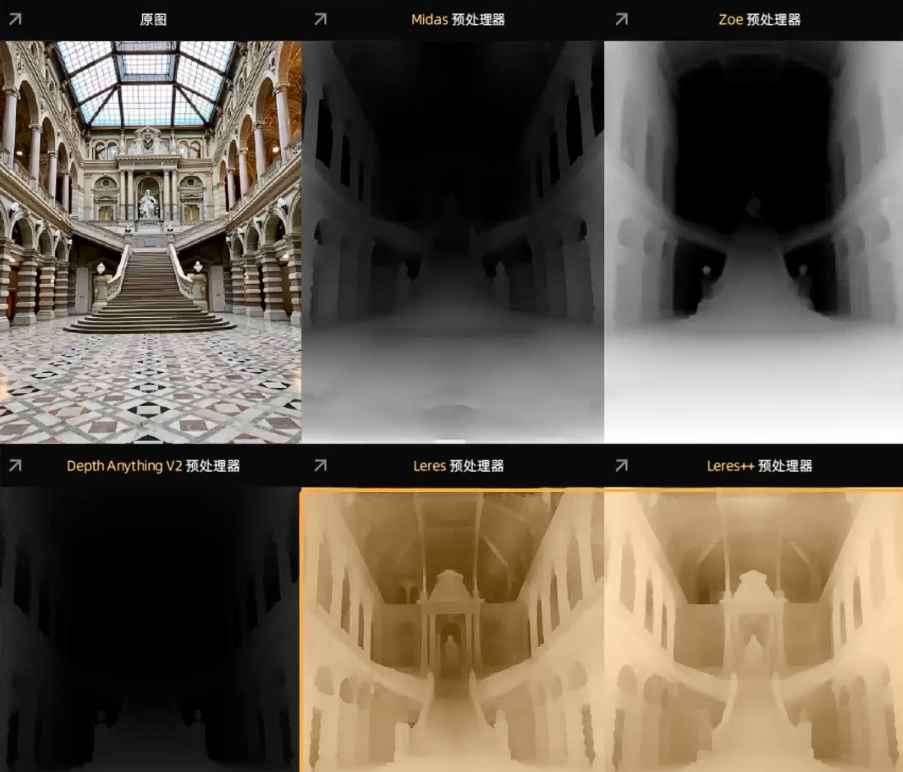
OpenPose 姿势模型
OpenPose 是一种基于姿势检测的模型。它能够根据原图,生成对应姿势检测图像。
如图所示,是使用OpenPose 姿势模型,将原图转化为新图。
不同的OpenPose预处理器下,有着不同的使用场景。如图所示 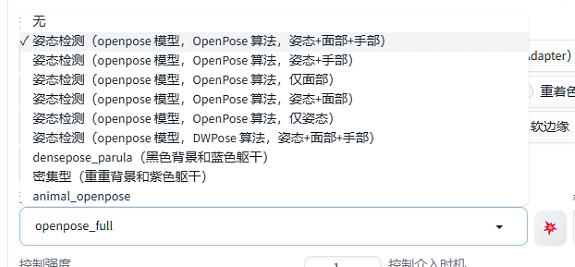
Scribble 涂鸦模型(涂鸦风格的线条)
Scribble 是一种基于涂鸦检测的模型。它能够根据原图,生成对应涂鸦检测图像。
如图是不同类型的Scribble预处理器下,识别的结果 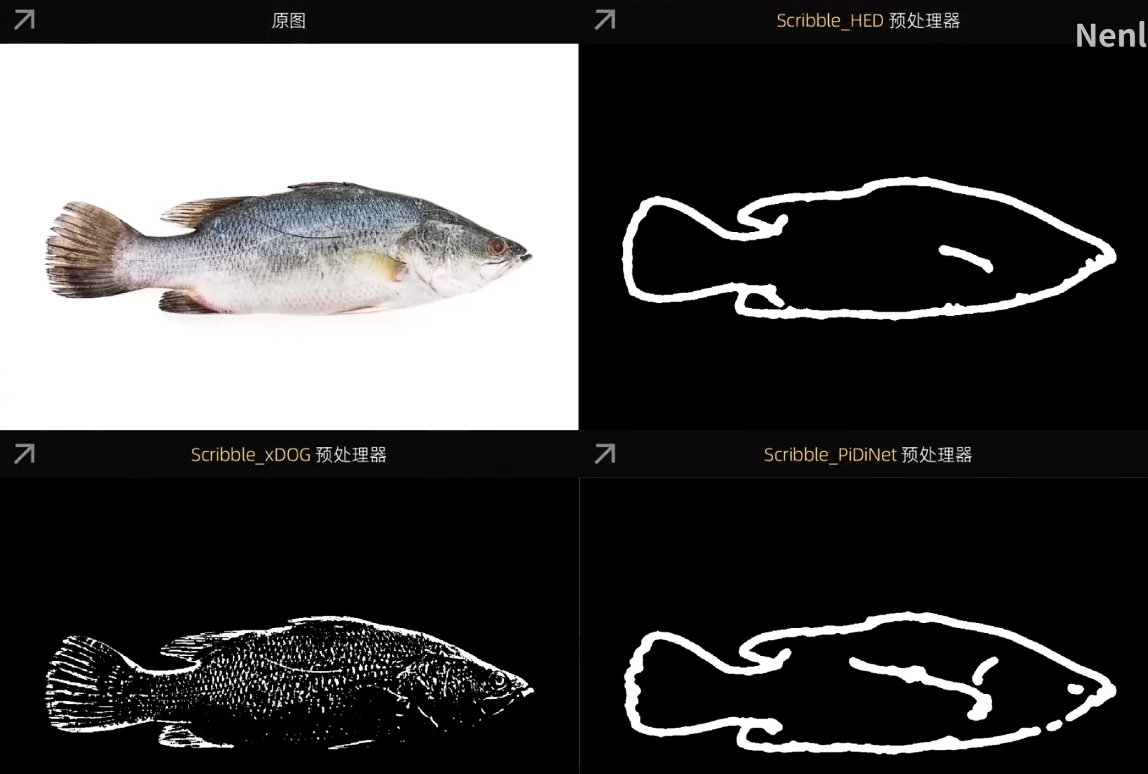
Segmentation 分割模型(图像构图布局)
Segmentation 是一种基于图像分割的模型。它能够根据原图,将图像分割为不同区域,分别控制。
如图是将原图通过Segmentation 分割模型进行分析的结果。 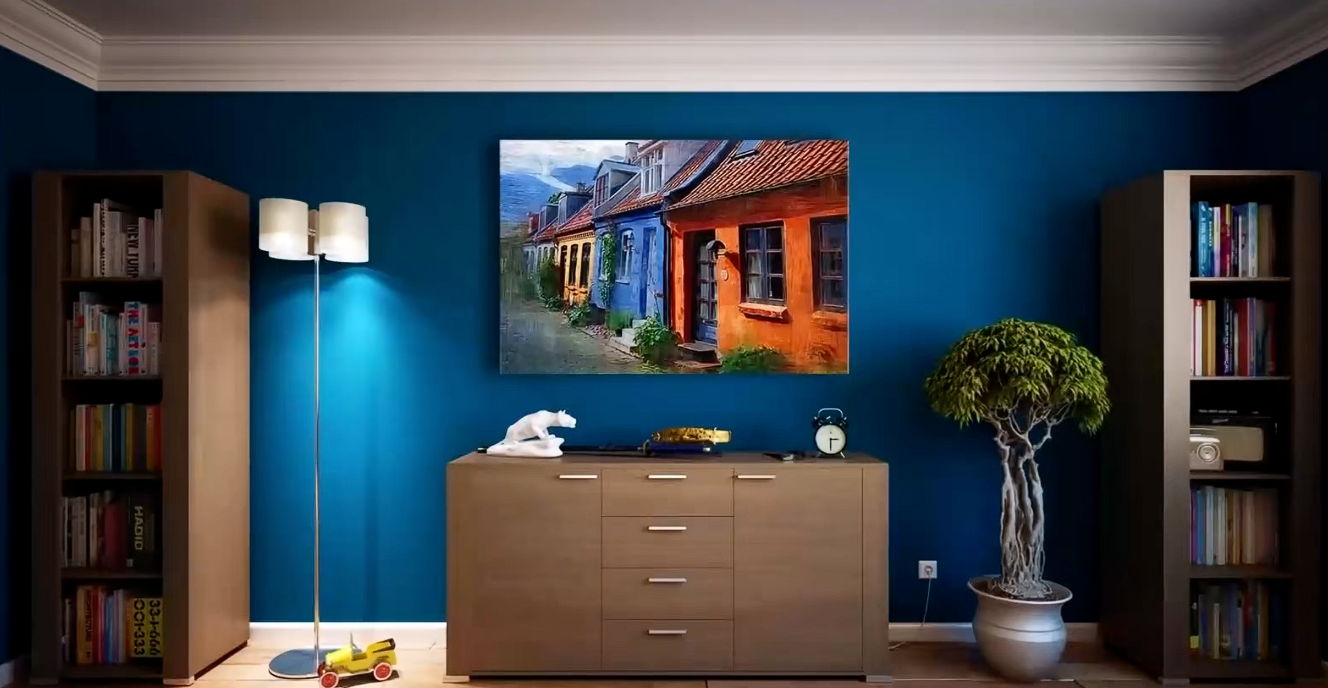
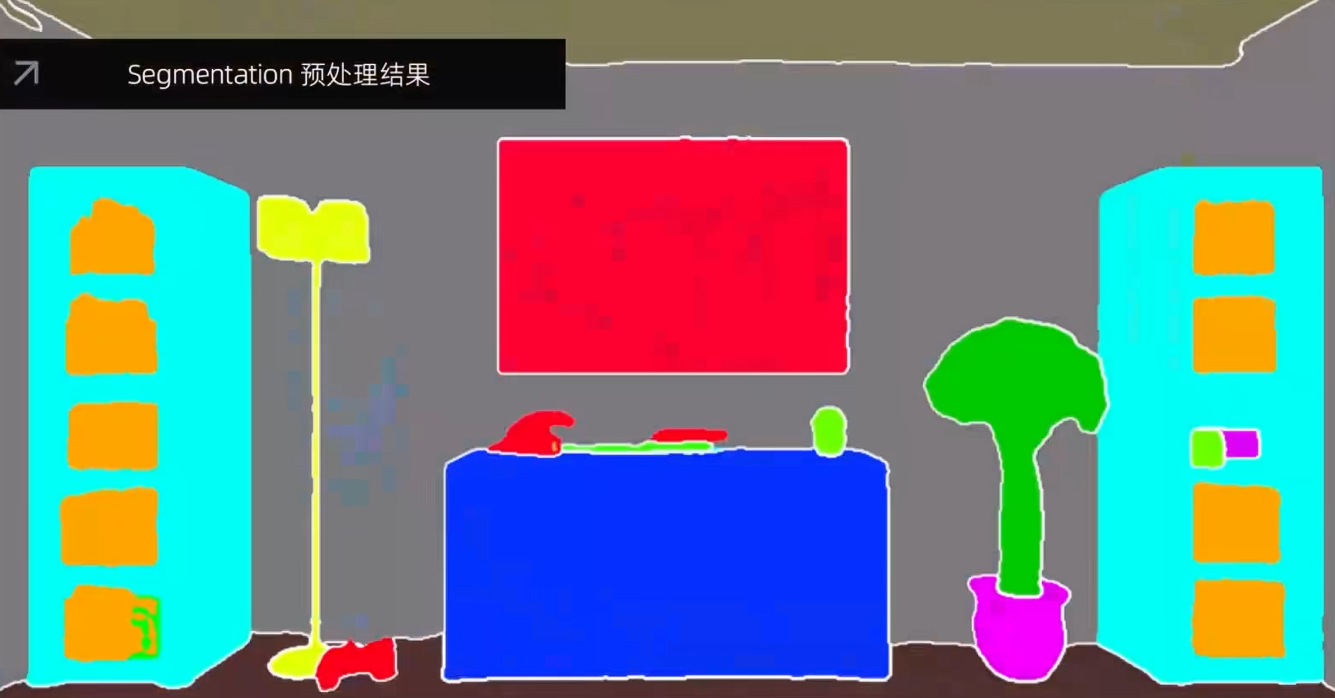
同样不同的Segmentation预处理器下,生成的分割结果也不同。 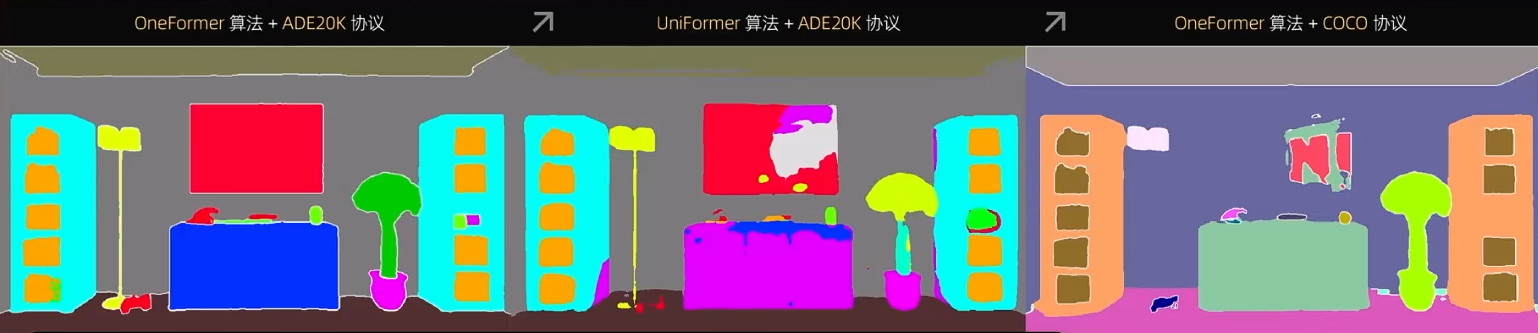
Segmentation中的颜色
Segmentation 中的颜色,是根据不同的颜色通道,来分割图像的。不同的颜色代表不同的事物。
应用场景
通过Segmentation 分割模型。新图也会与原图在整体的布局,构图上的设计保持一致。 如图所示 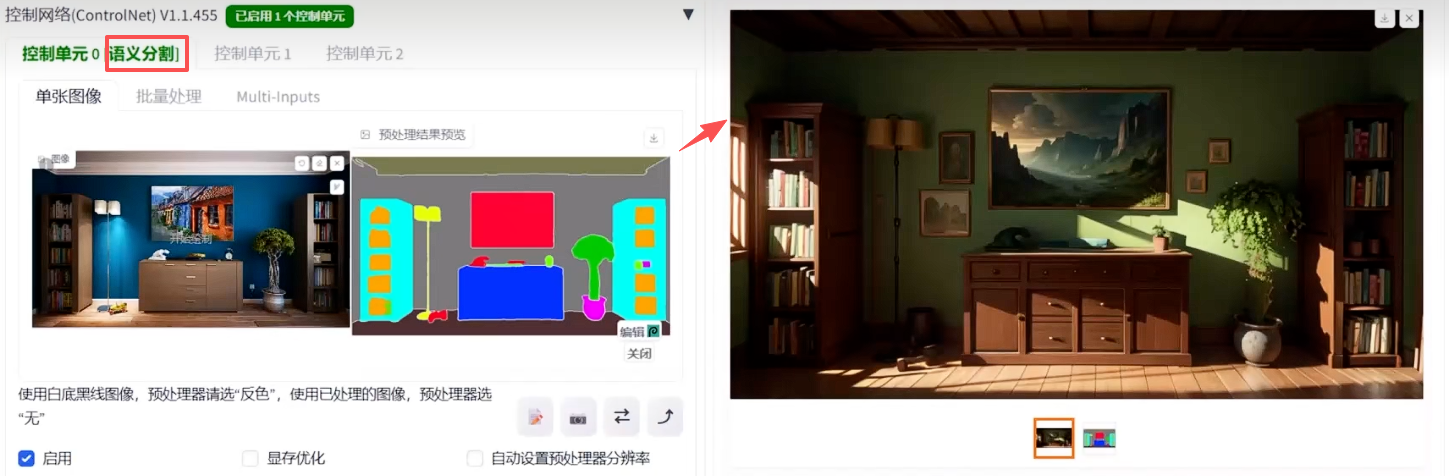
Tile 分块控制模型 (分块处理,高清修复,图像放大)
通过Tile 分块控制模型,我们可以将原图分割为多个区域,然后分别对每个区域进行控制。
Tile 分块控制模型会将原图进行分块处理,然后分别对每个区域进行控制。 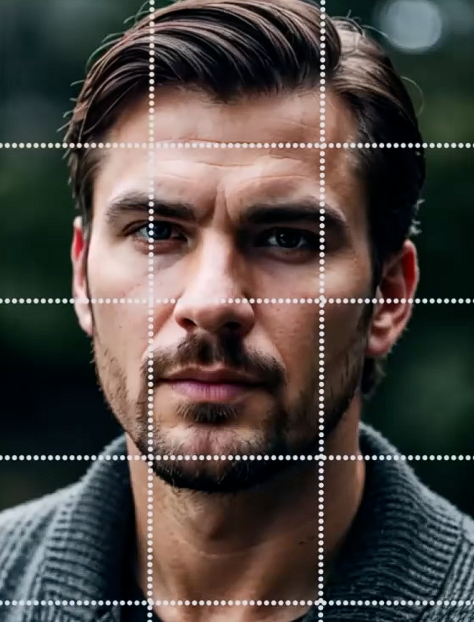
预处理器效果
不同的Tile 分块控制模型预处理器下,生成的结果也不同。如图所示。 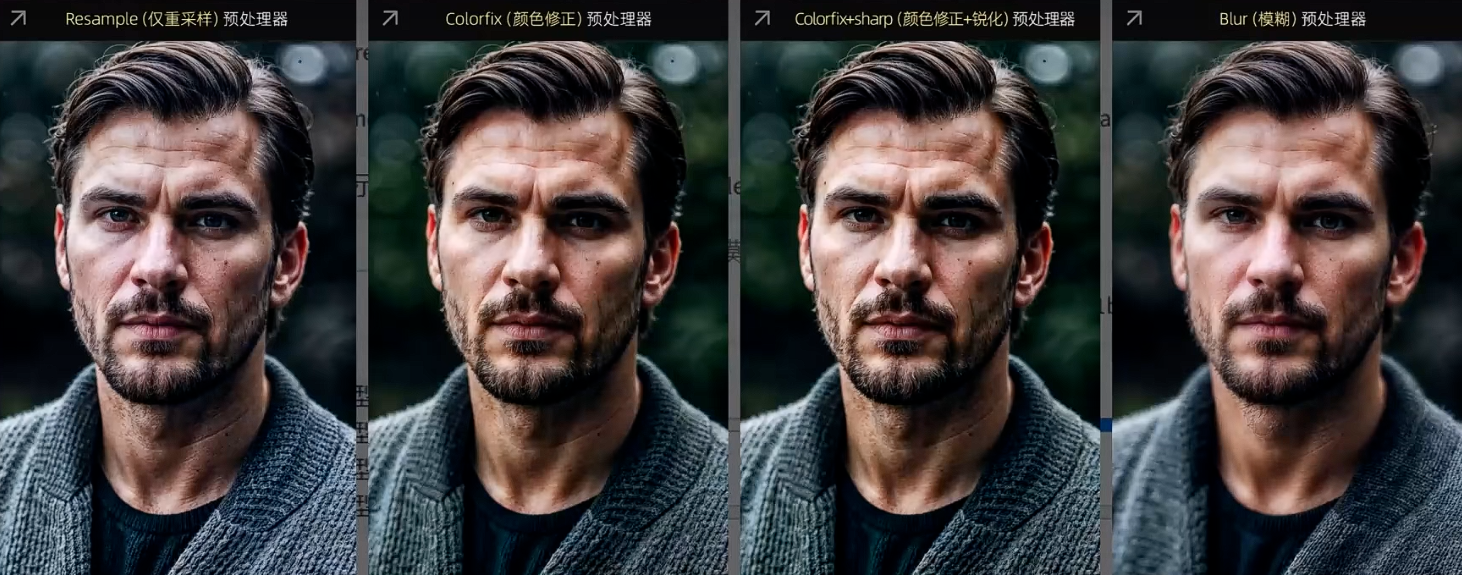
应用场景
当我们进行图像放大的时候,由于图像放大脚本的原理,是将图像分割为多个区域,然后分别对每个区域进行放大。
当降噪强度(重绘幅度)设置大的时候,会导致每块的图像区域放大混乱,从而导致最终的放大效果不好。
如图所示 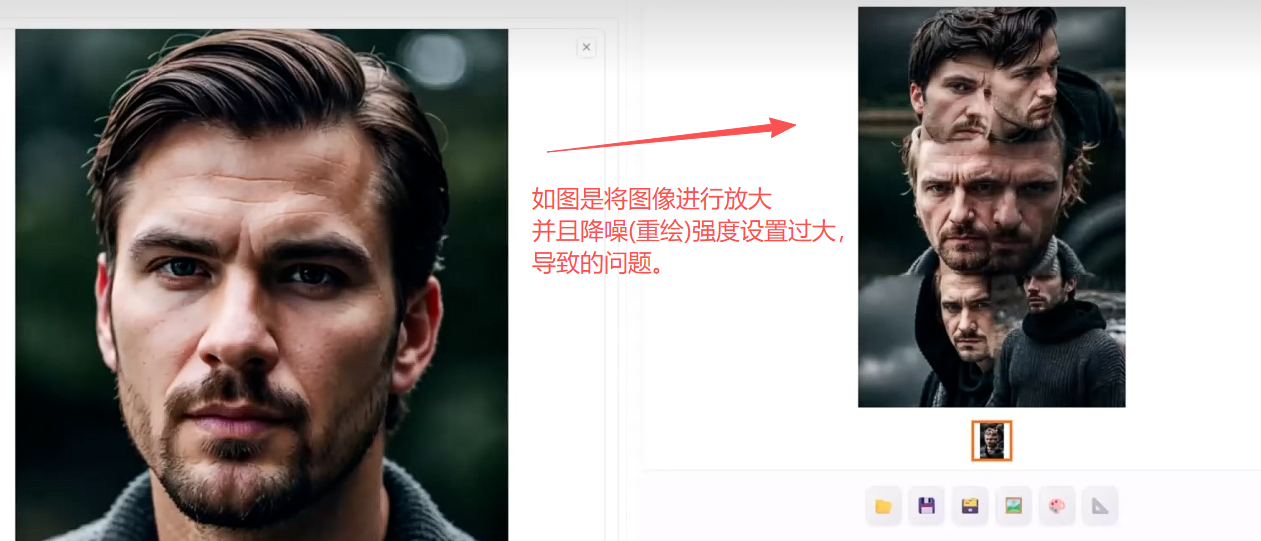
但是当使用Tile 分块控制模型的时候,就可以避免这个问题。
如图是再使用Tile 分块控制模型后,再次进行图像放大,并且是不同重绘强度下的放大效果。 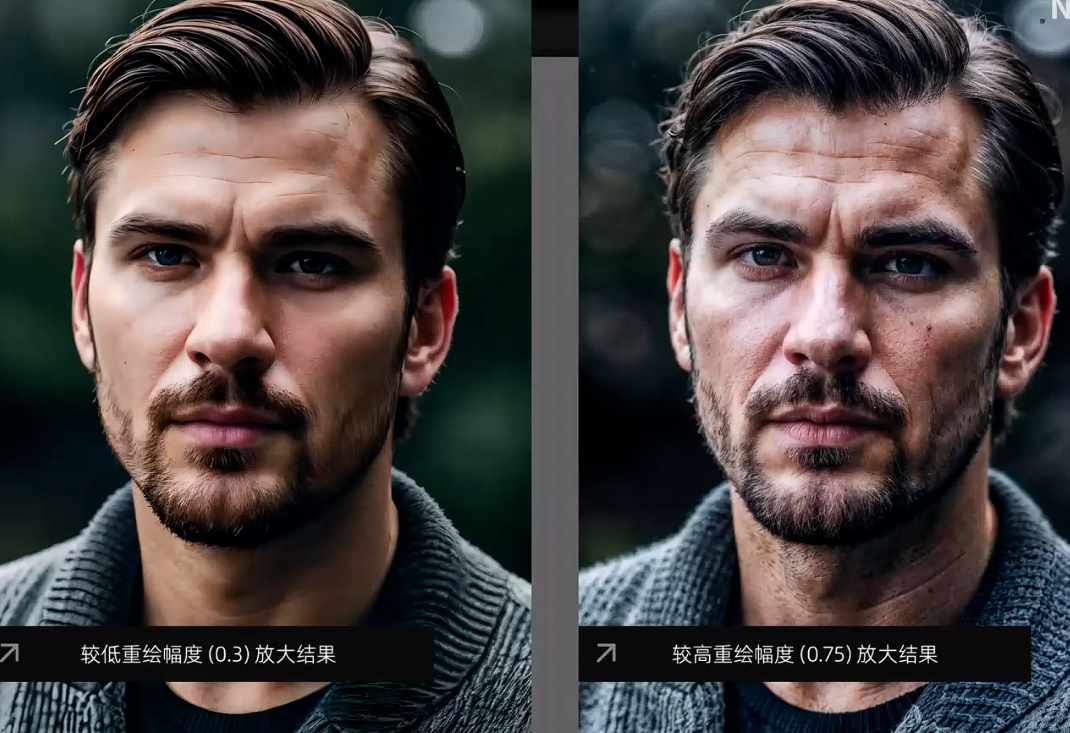
Recolor 重着色模型(重新上色)
Recolor 是一种基于图像着色的模型。它能够根据原图,生成对应着色图像。
如图是将黑白色原图,搭配对应的提示词再进行重新着色的结果。 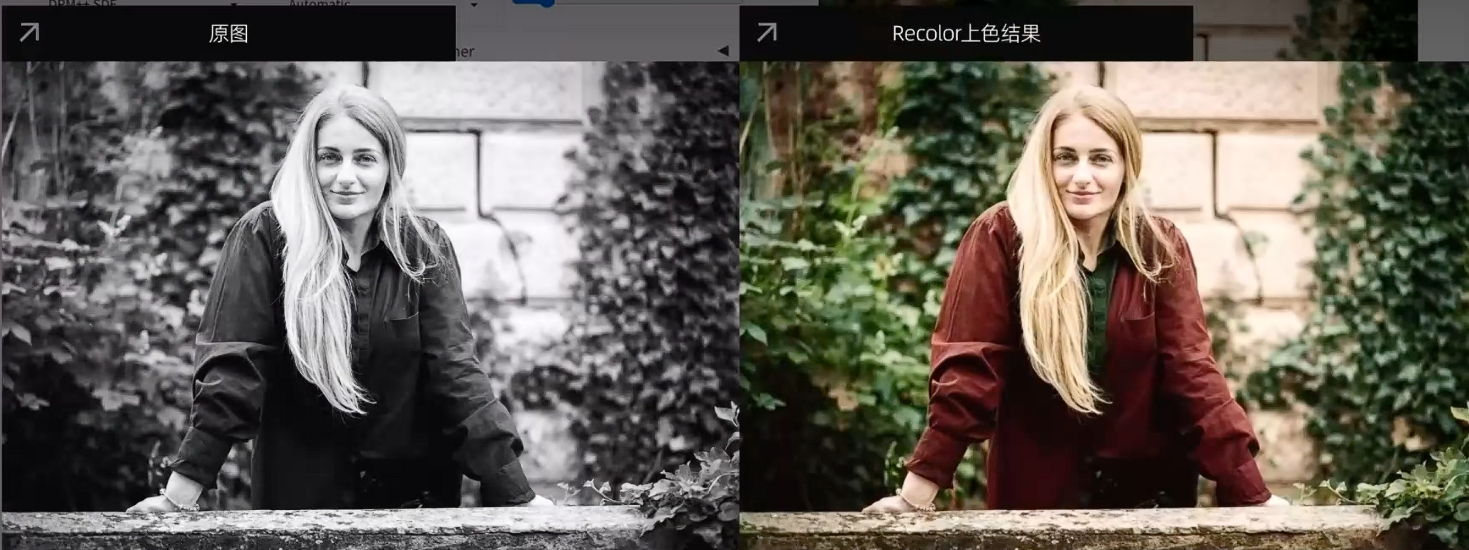
应用场景
- 艺术线稿上色
- 艺术线稿风格转绘
- 艺术线稿保持特定形状
也可以将原图先转化为黑白图,然后再进行重新着色。如图所示 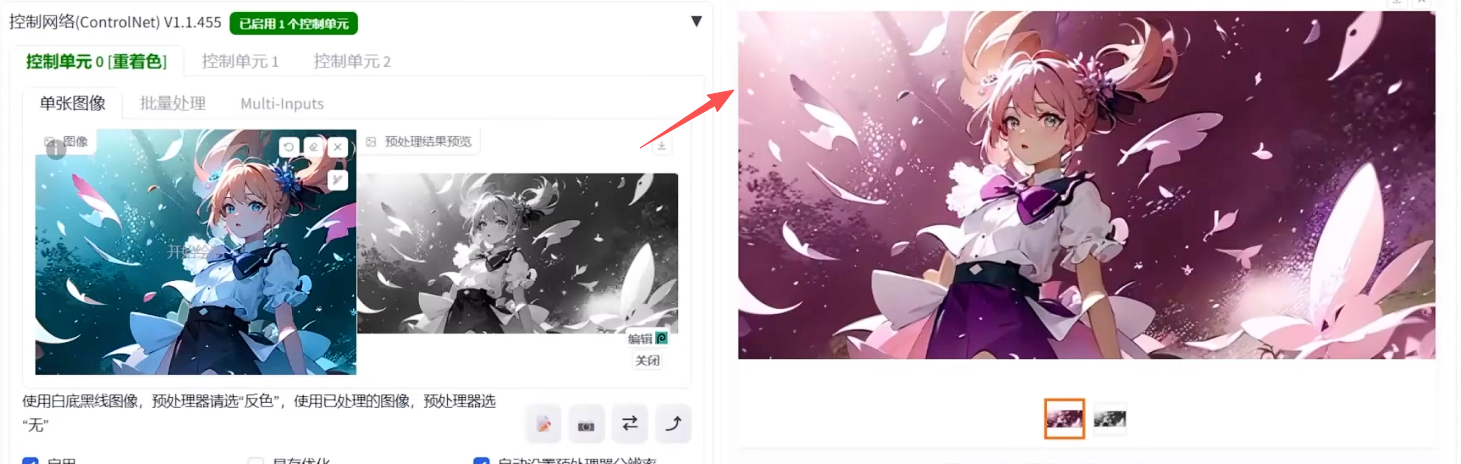
Inpainting 局部重绘模型
虽然sd webui 本身有提供局部重绘的功能。但是这是需要再搭配使用对应的局部重绘模型的基础上,才能实现的。
而使用ControlNet 下的Inpainting 模型,就可以无需再搭配使用对应的局部重绘模型,直接实现局部重绘的功能。
任意一个模型本体 + Inpainting 模型 = 重绘模型
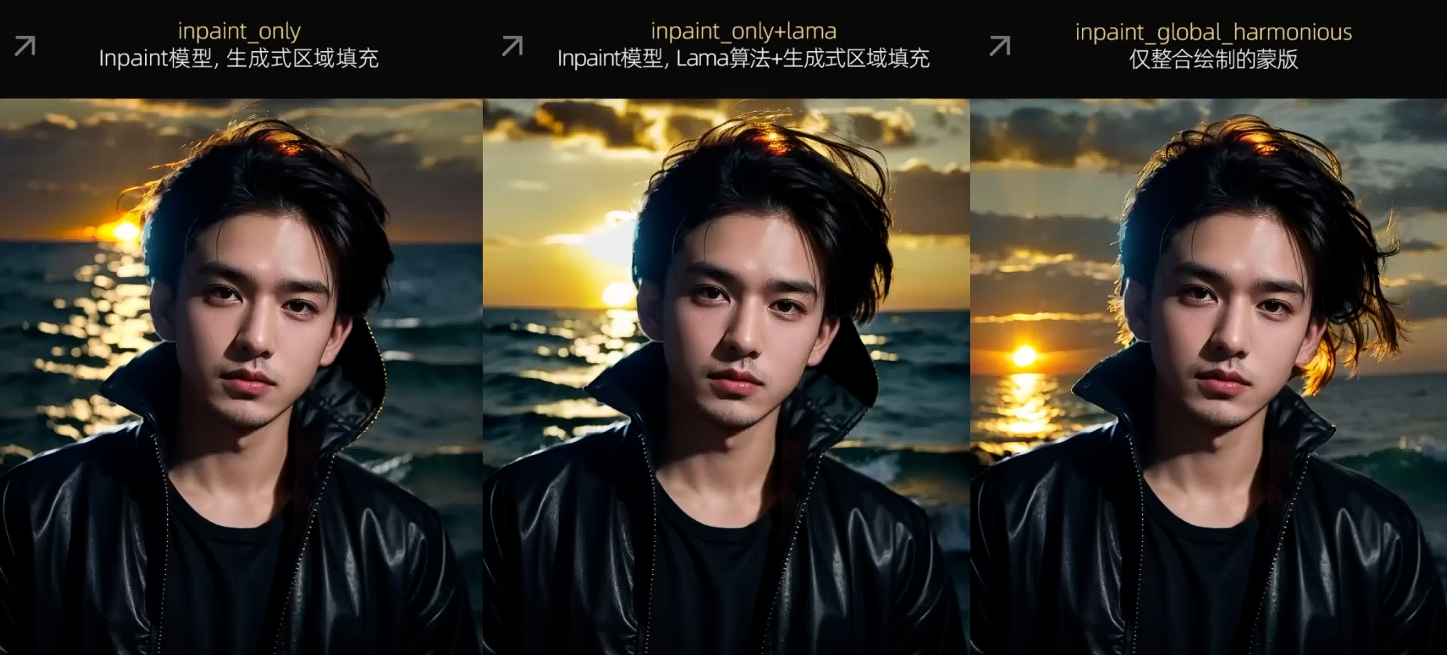
不同预处理器下的效果
sd webui 的 ControlNet 搭配使用
在sd webui 中,我们最多可以使用3个ControlNet 模型进行互相搭配使用。
如图所示 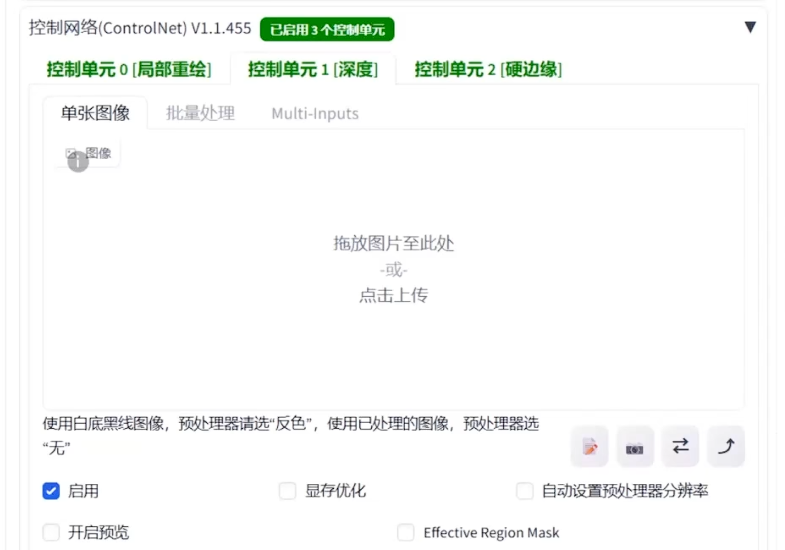
通过搭配不同的ControlNet 模型,我们可以实现更加复杂的效果。大多情况下使用2个ControlNet 模型就够了。
注意:多个ControlNet 模型搭配使用的话,不要选择类型相近的模型,否则会效果不好。