[toc]
ComfyUI笔记3
下面就介绍一些常用的,高级的工作流。这些工作流更复杂,但是功能更强大。也常常用于生产环境。
我的当前显卡设备是 NVIDIA RTX 5060TI 16GB。
图像拼接(合成图像)工作流
图像拼接(合成图像)工作流的主要功能就是将多个图像拼接(合成)为一个图像。
合成图像(遮罩)节点
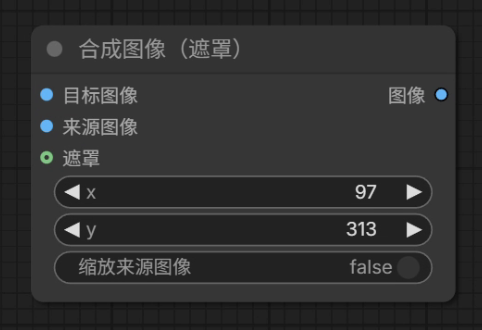
该节点是ComfyUI官方节点。用于将多个图像拼接(合成)为一个图像。支持将源图像叠加到目标图像的指定坐标位置,并可选择调整大小和遮罩。
参数
- 目标图像:源图像将被合成到此图像上。它作为背景。
- 来源图像:要合成到目标图像上的源图像。此图像可选择调整大小以匹配目标图像的尺寸。
- x:源图像左上角在目标图像中的 x 坐标。
- y:源图像左上角在目标图像中的 y 坐标。
- 缩放来源图像:指示是否应将源图像调整为与目标图像尺寸匹配。
- 遮罩:可选参数,用于指定源图像的哪些部分应合成到目标图像上。这允许更复杂的合成操作,例如混合或部分叠加。
示例工作流
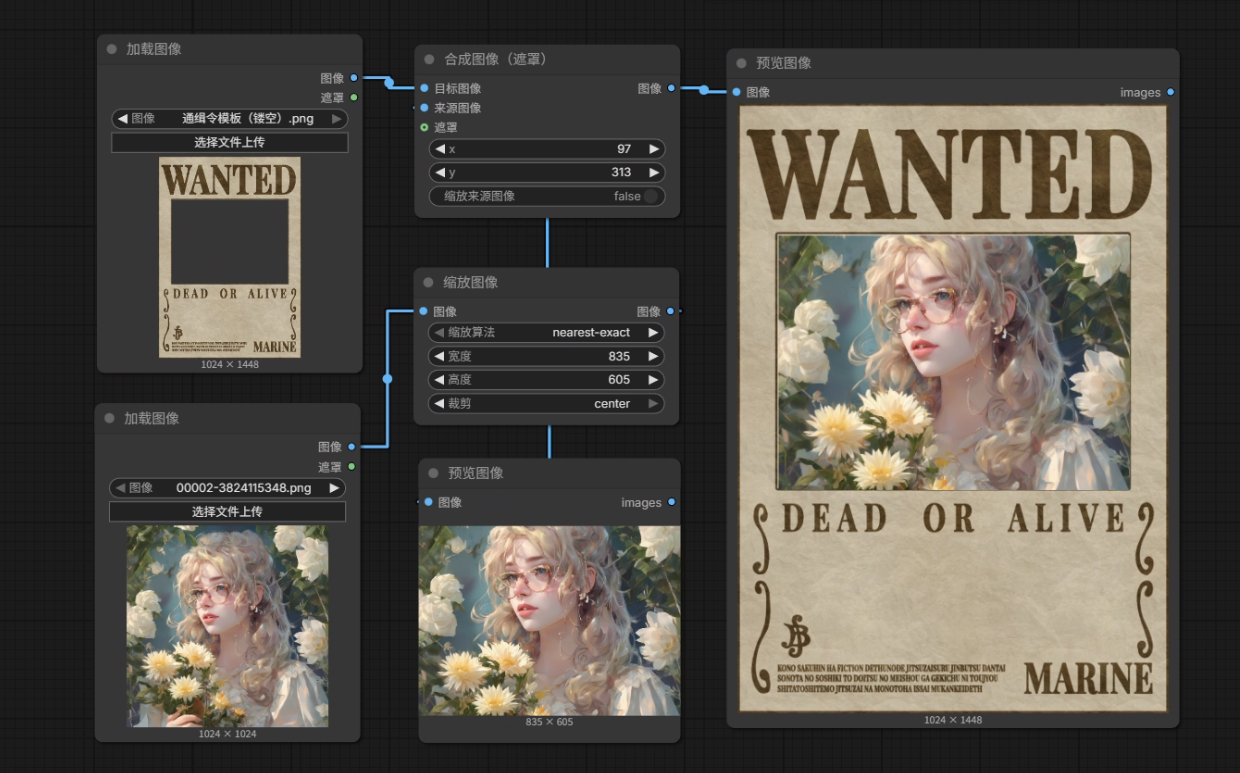
该示例工作流中先将原图进行缩放和裁剪,再将处理后的原图像叠加到目标图像的指定坐标位置。最后生成一个合成后的图像。
文字覆盖(文字添加)工作流
当我们想要实现在一个图片上添加文字时,我们可以使用文字覆盖工作流。
想要实现这个文字覆盖效果,目前comfyUI官方节点效果不太好。因此目前推荐按照第三方节点包来实现这个功能。
第三方节点包 ComfyUI_Comfyroll_CustomNodes
介绍
推荐使用第三方节点包:ComfyUI_Comfyroll_CustomNodes。该节点包中有一个 Text Overlay(文字覆盖)节点。
ComfyUI_Comfyroll_CustomNodes 节点包链接地址 https://github.com/Suzie1/ComfyUI_Comfyroll_CustomNodes
该节点包中的文字覆盖节点相比其他文字覆盖节点,最大优势是可以直接输入原图,并且能直接在原图上写字,一步到位,不用额外节点。
安装
安装方式参考ComfyUI笔记。
CR Overlay Text 节点
CR Overlay Text 节点是 ComfyUI_Comfyroll_CustomNodes 节点包中的一个节点。
该节点能直接在原图上写字,一步到位,不用额外节点。
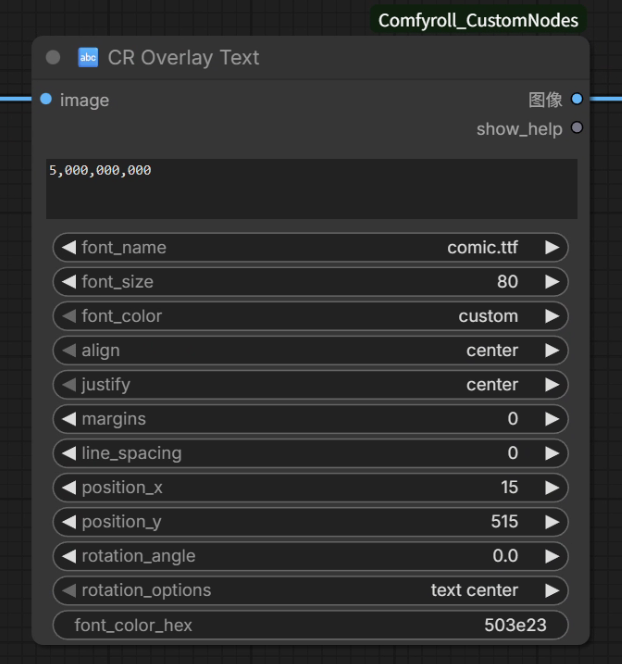
参数
- image:输入的图像。
- 文本框:你需要输入的文字。
- font_name:要使用的字体文件名字。
- align:文字对齐方式。垂直对齐
- justify:文字对齐方式。水平对齐
- margin:文字与图像的间距。一般填 0
- line_spacing:行间距,多行文字才生效,单行文字填 0 即可
- position_x: 文字左上角 X 坐标(水平),0 = 图片最左边
- position_y: 文字左上角 Y 坐标(垂直),0 = 图片最顶端
- rotation_angle: 文字旋转角度
- rotation_options: 旋转的中心点
- font_color_hex: 字体颜色十六进制代码,(注意节点不带 #号,直接填
503e23)
示例工作流
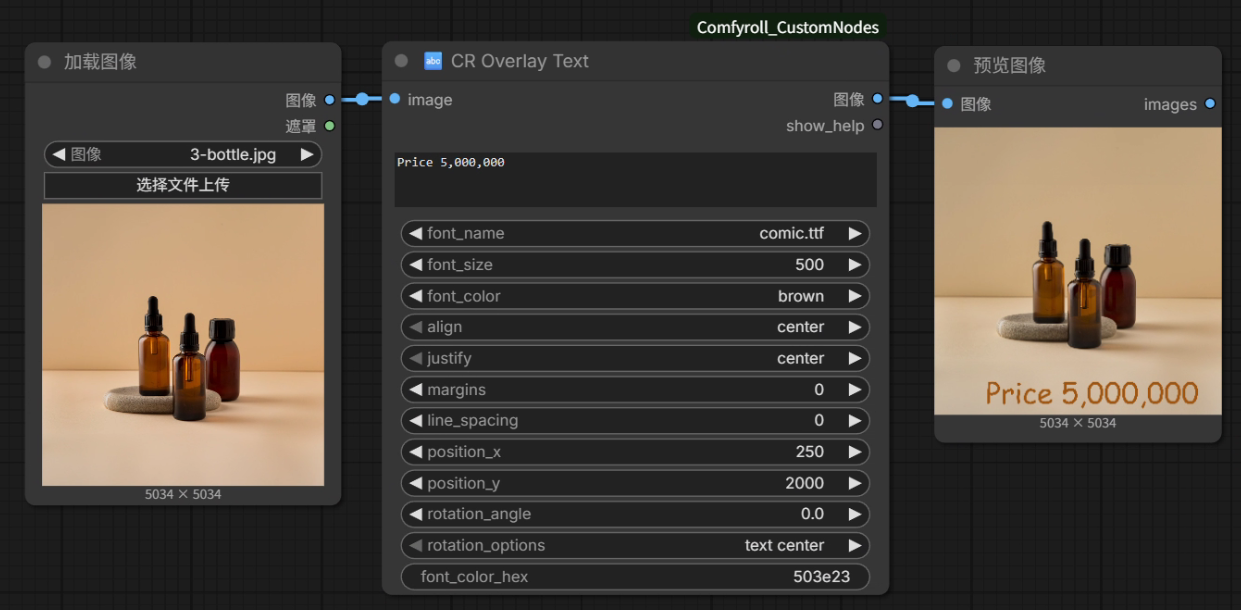
该示例工作流中,使用了CR Overlay Text 节点。在原图上实现文字覆盖效果。
Qwen-Image 文生图工作流
模型介绍
Qwen-Image 是阿里通义实验室开源的 20B 级 MMDiT 架构原生高清文生图大模型,FP8 是官方推荐的平衡画质、显存、速度的量化版本,区别于原版 BF16 大显存版本。
Qwen-Image 模型的最佳图像分辨率是1328x1328。
核心优势
- 中文语义超强理解:原生海量中文图文训练,无需强制英文提示词,国风、中式场景、书法、牌匾文字精准还原。
- 文字渲染行业顶尖:海报、LOGO、标语、中英混排文字清晰可辨,不会扭曲、错位,电商或新媒体海报刚需
- 人像真实度拉满:大幅消除 AI 塑料脸,皮肤肌理、发丝、五官比例自然,很少出现畸形手脚,适配写真、模特、人物扩图(半身转全身)
Qwen-Image 模型如果要生成带有中文的图片,需要对在提示词中对中文文字加上引号,例如:"中文图片"。
模型文件搭配
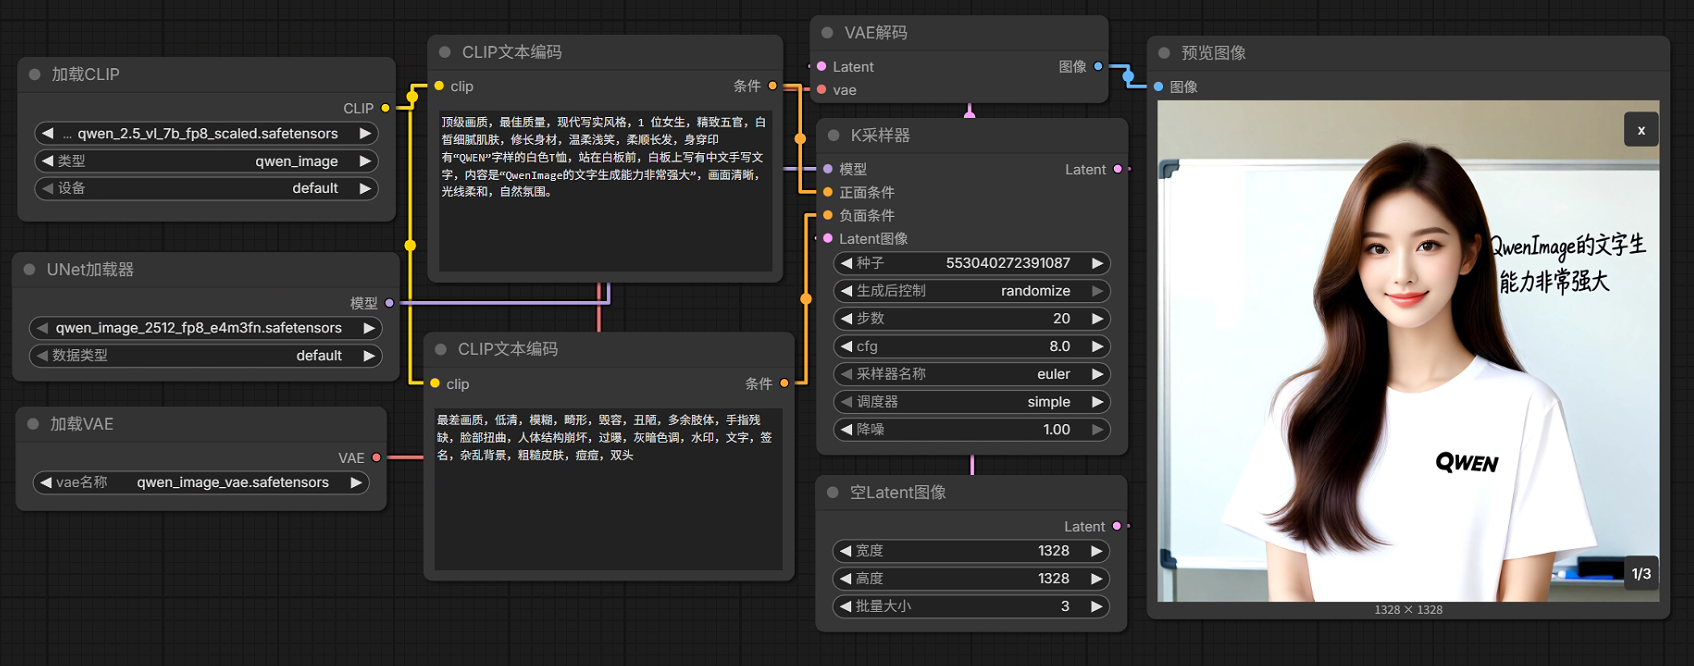
- CLIP 文本模型:qwen_2.5_vl_7b_fp8_scaled.safetensors
- UNet 扩散模型:qwen_image_2512_fp8_e4m3fn.safetensor。
- VAE编码解码模型:qwen_image_vae.safetensors(专属的VAE模型)。
中文人物图片
中文海报
如图是中文海报的工作流示例 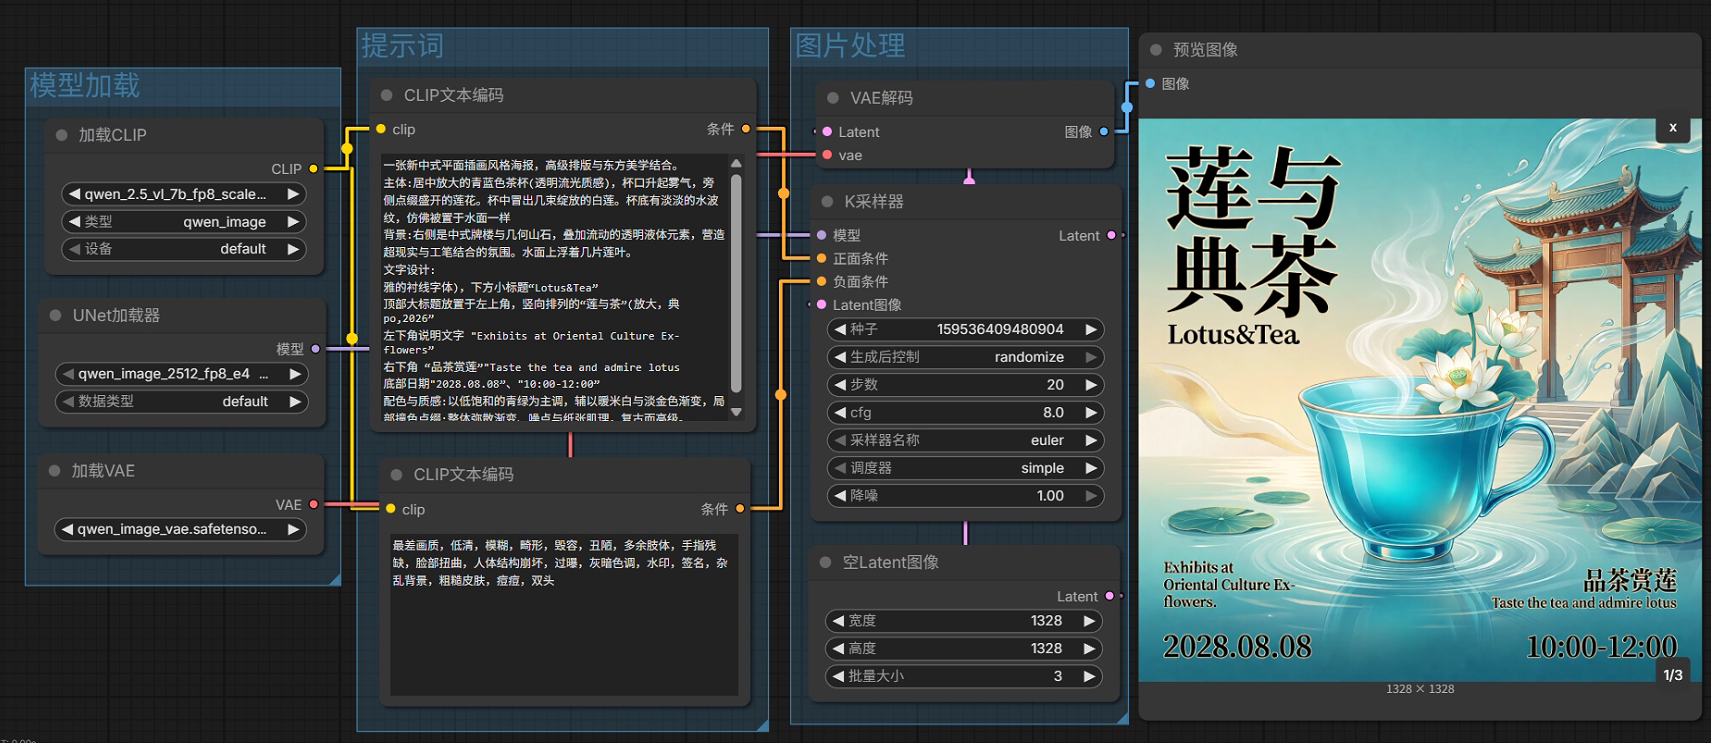
中文Logo
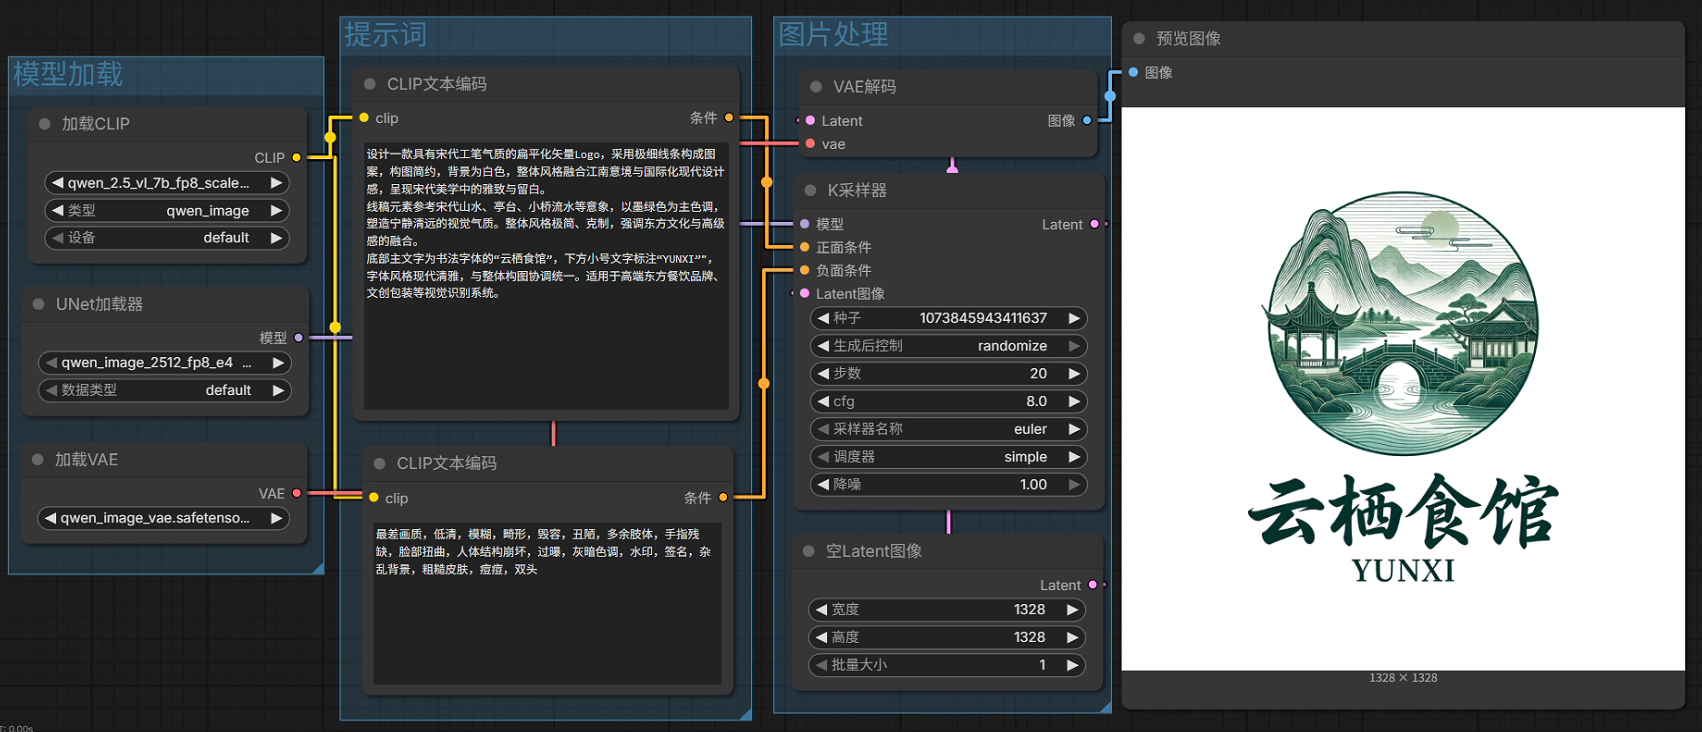
Qwen-Image-Edit 图生图工作流
模型介绍
Qwen-Image-Edit 模型是在 Qwen-Image 模型的基础上,额外做了大量图像编辑专项训练,专门做图生图和图像编辑的衍生专用版。
模型文件搭配
完整使用Qwen-Image-Edit模型需要用到的模型文件如下:
- CLIP 文本模型:qwen_2.5_vl_7b_fp8_scaled.safetensors
- UNet 扩散模型:qwen_image_edit_2509_fp8_e4m3fn.safetensor
- VAE编码解码模型:qwen_image_vae.safetensors 专属的VAE模型,只能用于Qwen-Image模型。
- lora 模型(可选使用):qwen-image-edit-2509-lightning-4steps-v1.0-bf16.safetensors,该模型是qwen-Image-Edit模型对应的lora加速模型,推荐采样步数是4步,用于加速生成图像。
QwenImageEditPlus节点(适配QwenImageEdit模型的条件编码节点)
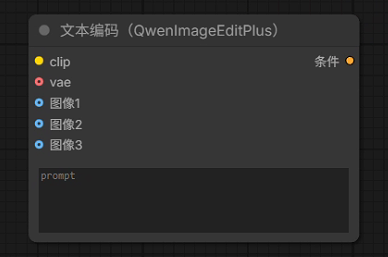
这个节点是专门适配千问通义 Qwen-Image-Edit 模型的条件编码节点,支持同时输入可选图像和文本提示词,并为图像生成或编辑输出条件数据。
输入输出
- 输入:文本提示词、CLIP模型、图像(可选)、VAE模型(可选)
- 输出:包含图像和文本提示词的条件向量编码,用于后续的图像生成。
注意:该节点会把原图通过 VAE 编码器压缩为初始潜在图像,作为初始图生图的基础。后续采样器基于这个初始潜在图像的基础上进行去噪修改,而非从头生成,从而保证生成的图像主体结构不变。
图像编辑添加装饰
如图通过qwen-image-edit模型对原图进行了编辑处理。 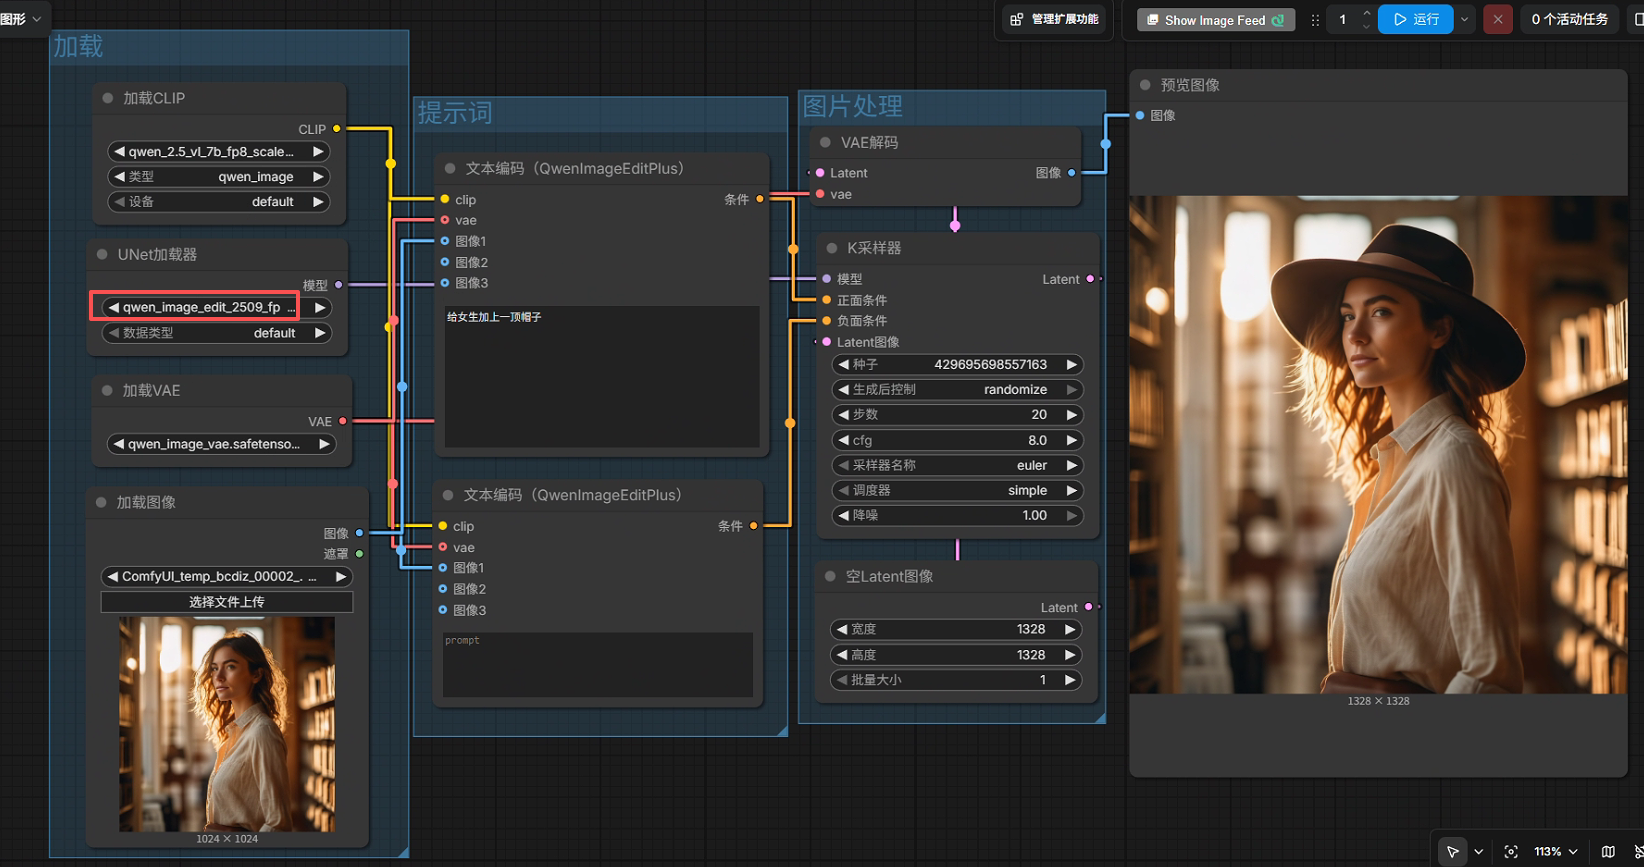
工作流说明
注意:图中Unet节点加载的是qwen_image_edit模型文件。而不是qwen_image模型文件。
角色三视图
可以用Qwen-Image-Edit模型来生成角色三视图。
如图所示工作流 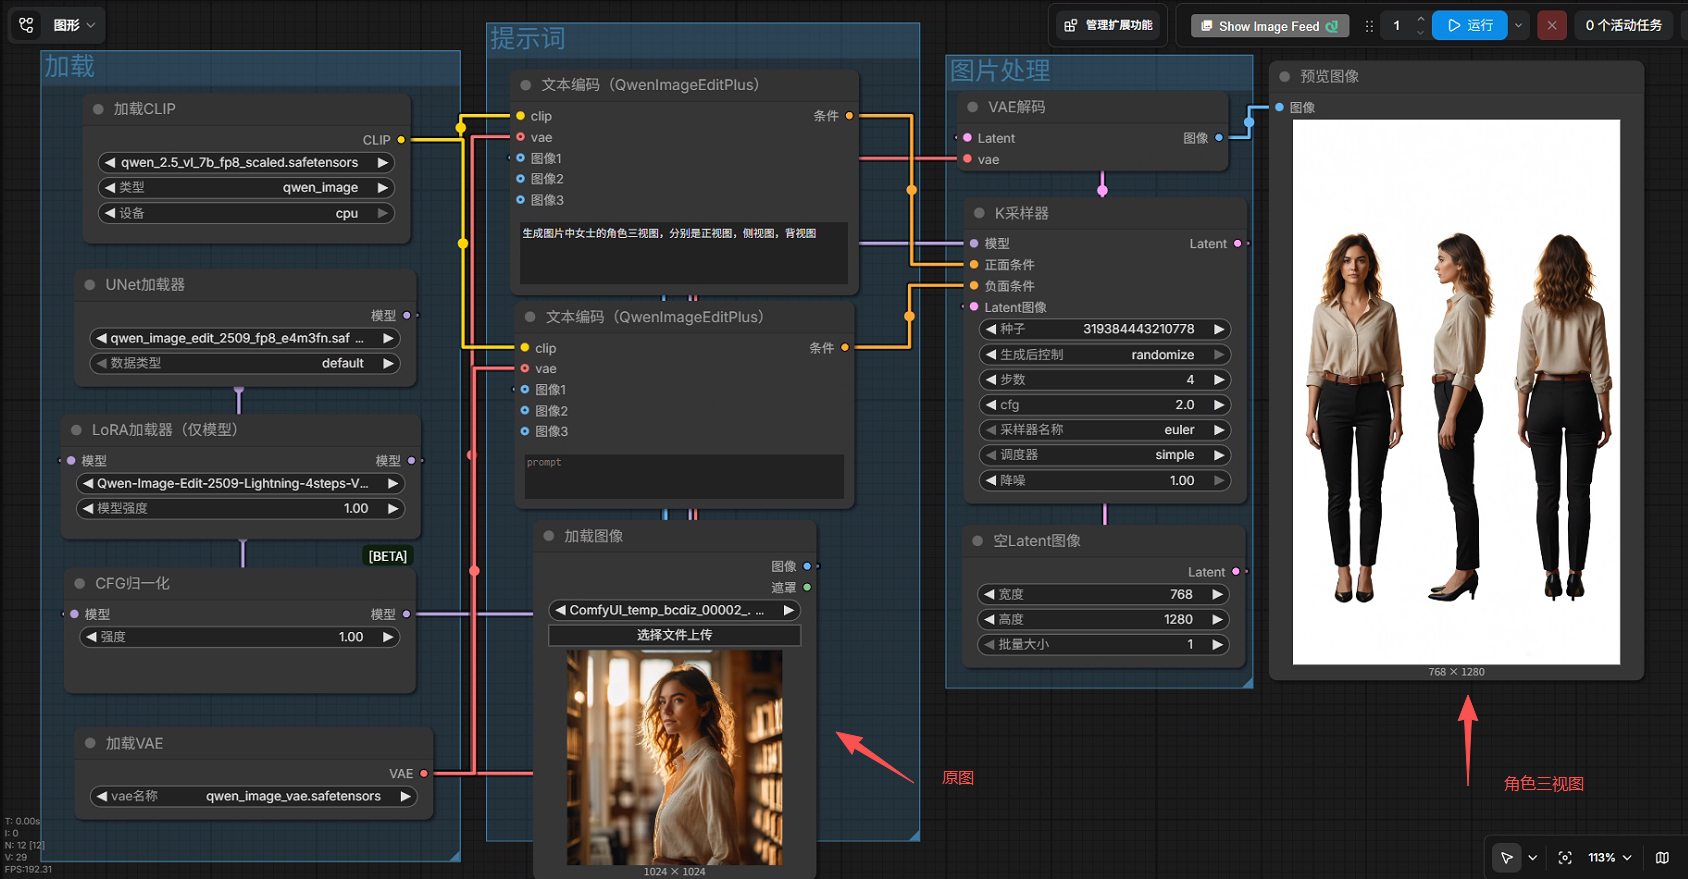
工作流说明
- 三视图的图像分辨率建议按照16:9的比例。否则会导致图像变形。图中分辨率是1280x768。
- 提示词直接说明"生成XXX的角色三视图,分别是正视图,侧视图,背视图"即可。
- 工作流中使用了 Lora加速模型节点 + CFG 归一化节点。这两个节点用于加速图像生成。具体相关介绍请看其他笔记。
图像人物换衣服
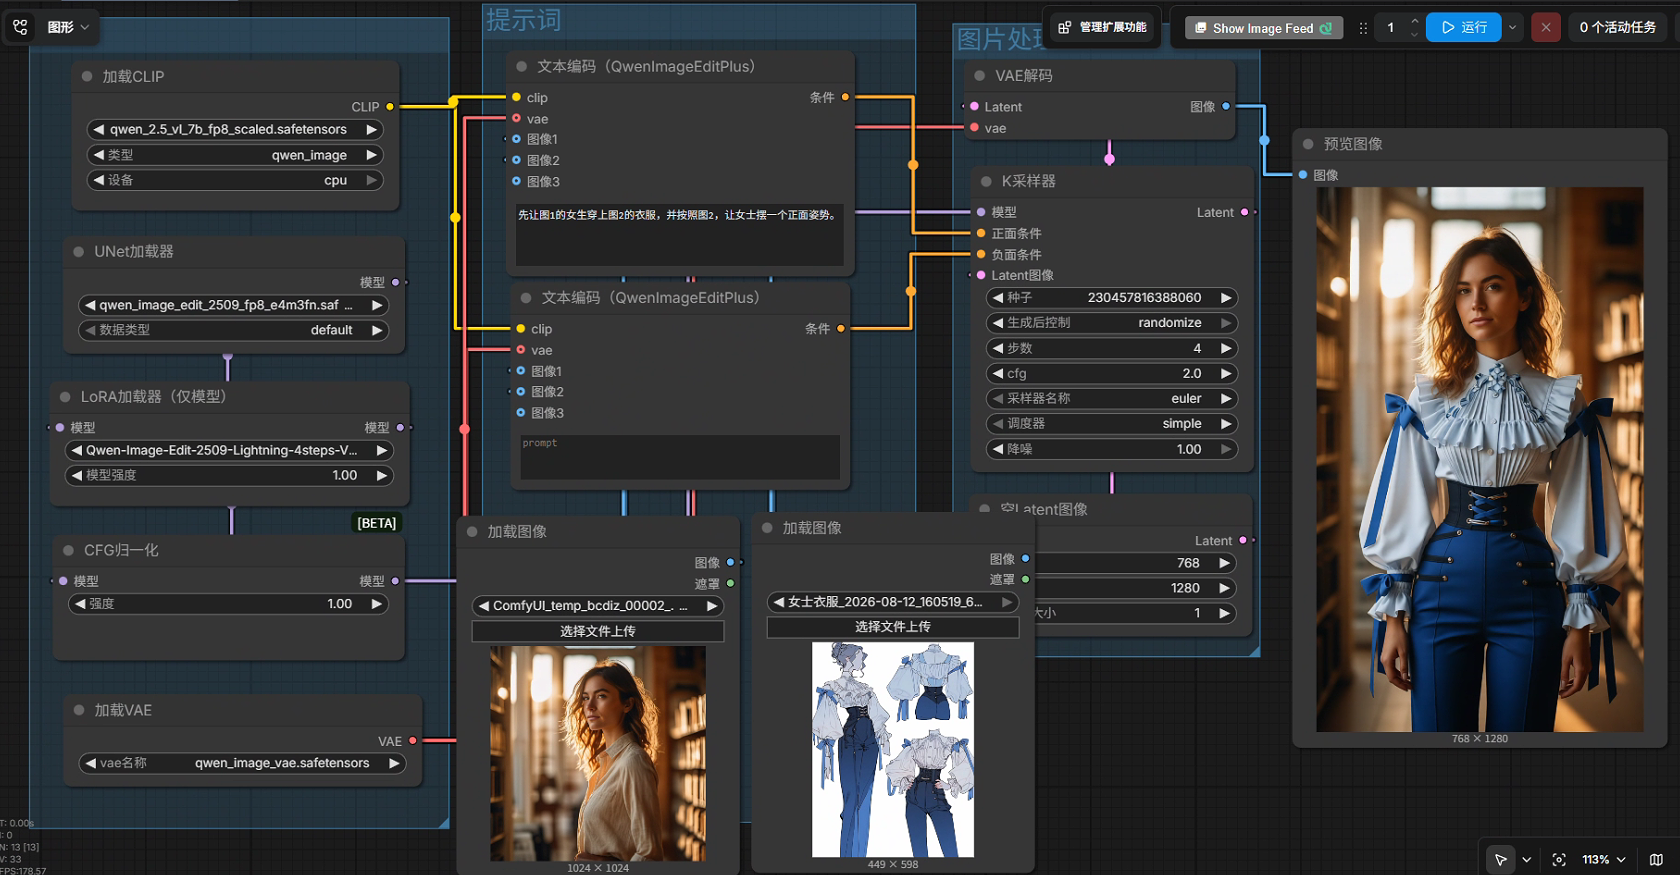
图片中的加载CLIP节点的设备参数应该是default。
图像二次元风格转绘
该工作流将真实图像转换为二次元风格的图像。 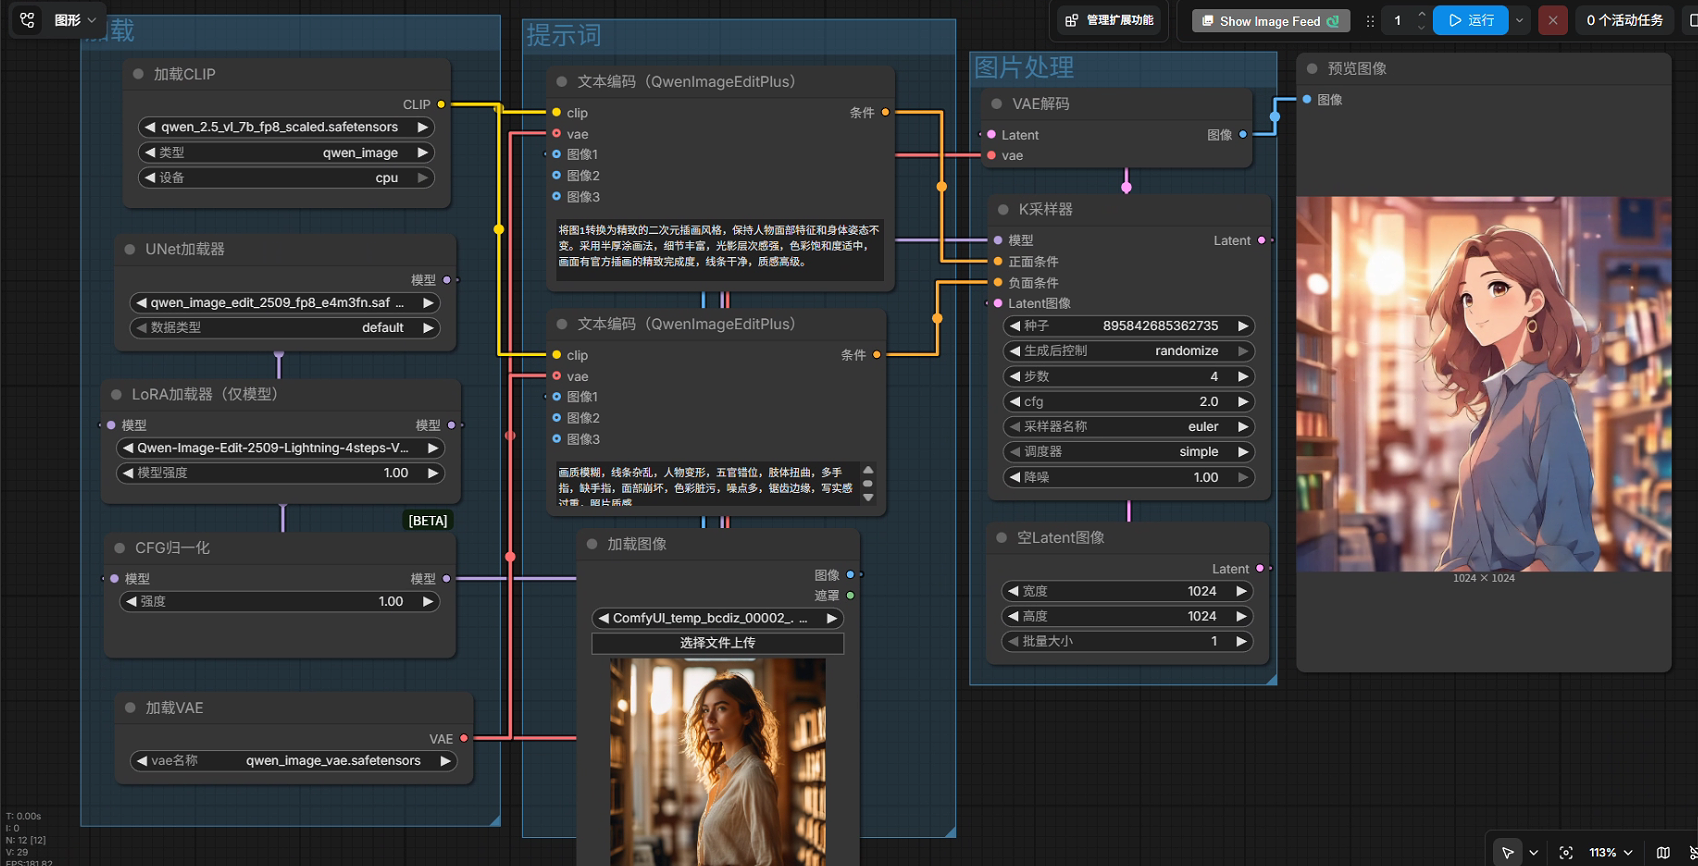
图片中的加载CLIP节点的设备参数应该是default。
提示词说明
下面是二次元精致插画风的提示词
### 正面提示词
将人物转换为精致的二次元插画风格,保持人物面部特征和身体姿态不变。采用半厚涂画法,细节丰富,光影层次感强,色彩饱和度适中,画面有官方插画的精致完成度,线条干净,质感高级。

### 负面提示词
画质模糊,线条杂乱,人物变形,五官错位,肢体扭曲,多手指,缺手指,面部崩坏,色彩脏污,噪点多,锯齿边缘,写实感过重,照片质感
图像真实风格转绘
该工作流将真实图像转换为真实风格的图像。 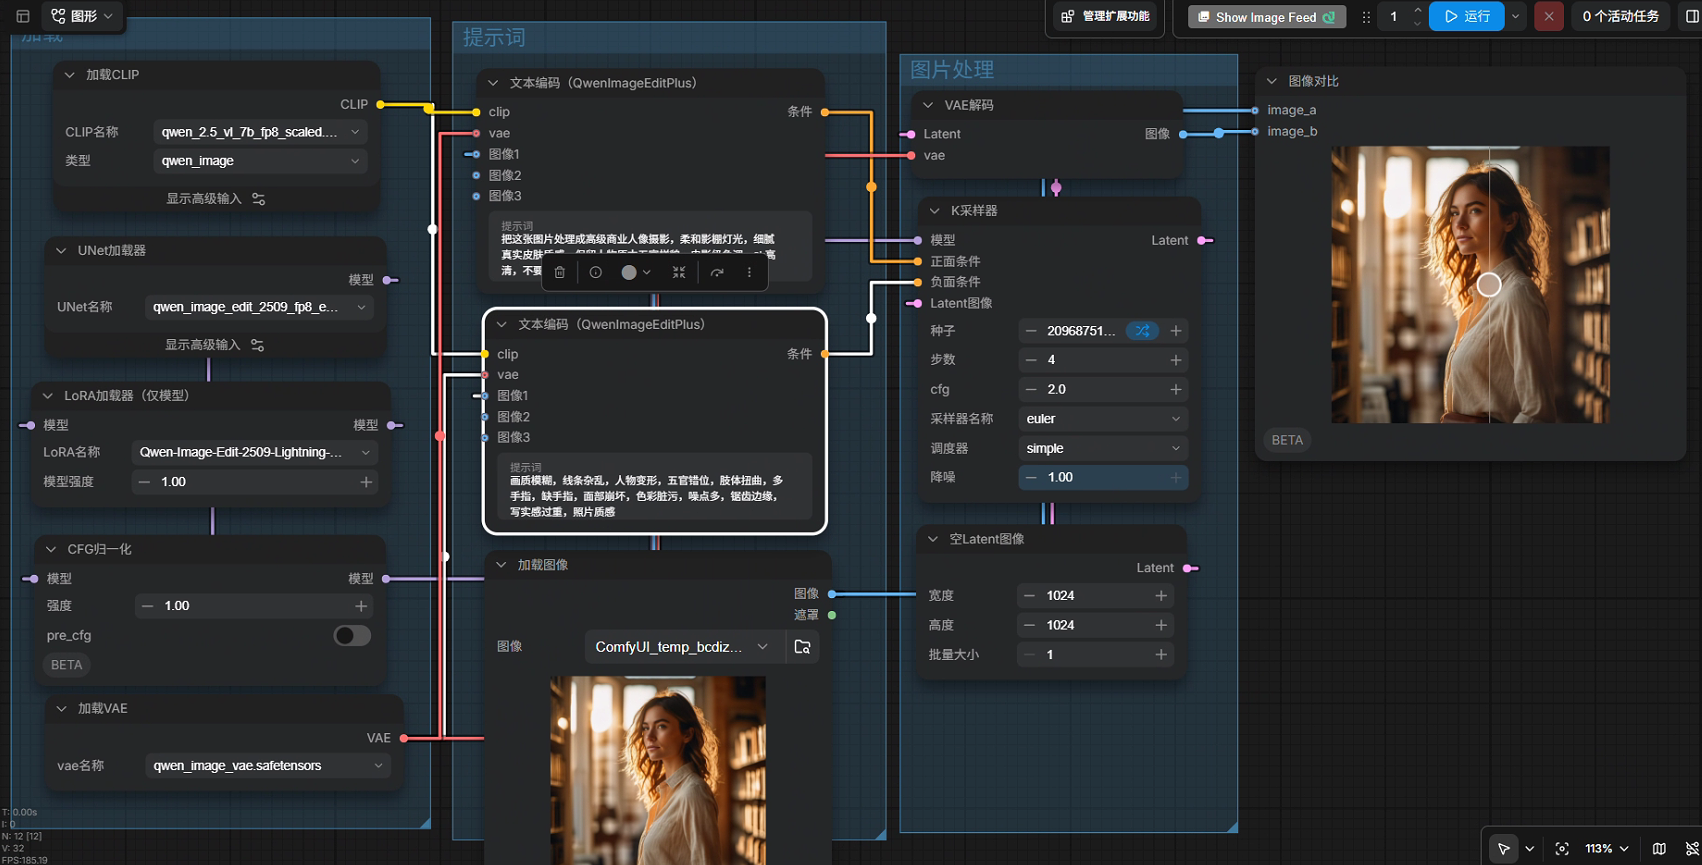
该工作流中使用了图像对比节点。该节点介绍请看其他笔记。
提示词说明
下面是真实风格的提示词
### 正面提示词
把这张图片处理成高级商业人像摄影,柔和影棚灯光,细腻真实皮肤质感,保留人物原本五官样貌,电影级色调,8k高清,不要改变人物姿态与脸型

### 负面提示词
画质模糊,线条杂乱,人物变形,五官错位,肢体扭曲,多手指,缺手指,面部崩坏,色彩脏污,噪点多,锯齿边缘,写实感过重,照片质感
海贼王通缉令工作流
该工作流的主要功能就是根据输入的图像,先将其重绘为海贼王的风格,再将其添加到海贼王通缉令图像的指定坐标位置。最后生成一个合成后的图像。
如图是示例工作流。该工作流分为两个部分。
- 第一部分:将输入的图像进行重绘,将其转换为海贼王的风格。
- 第二部分:将重绘后的图像根据指定坐标位置,添加到海贼王通缉令图像中。先添加图像,然后添加文本。
第一部分 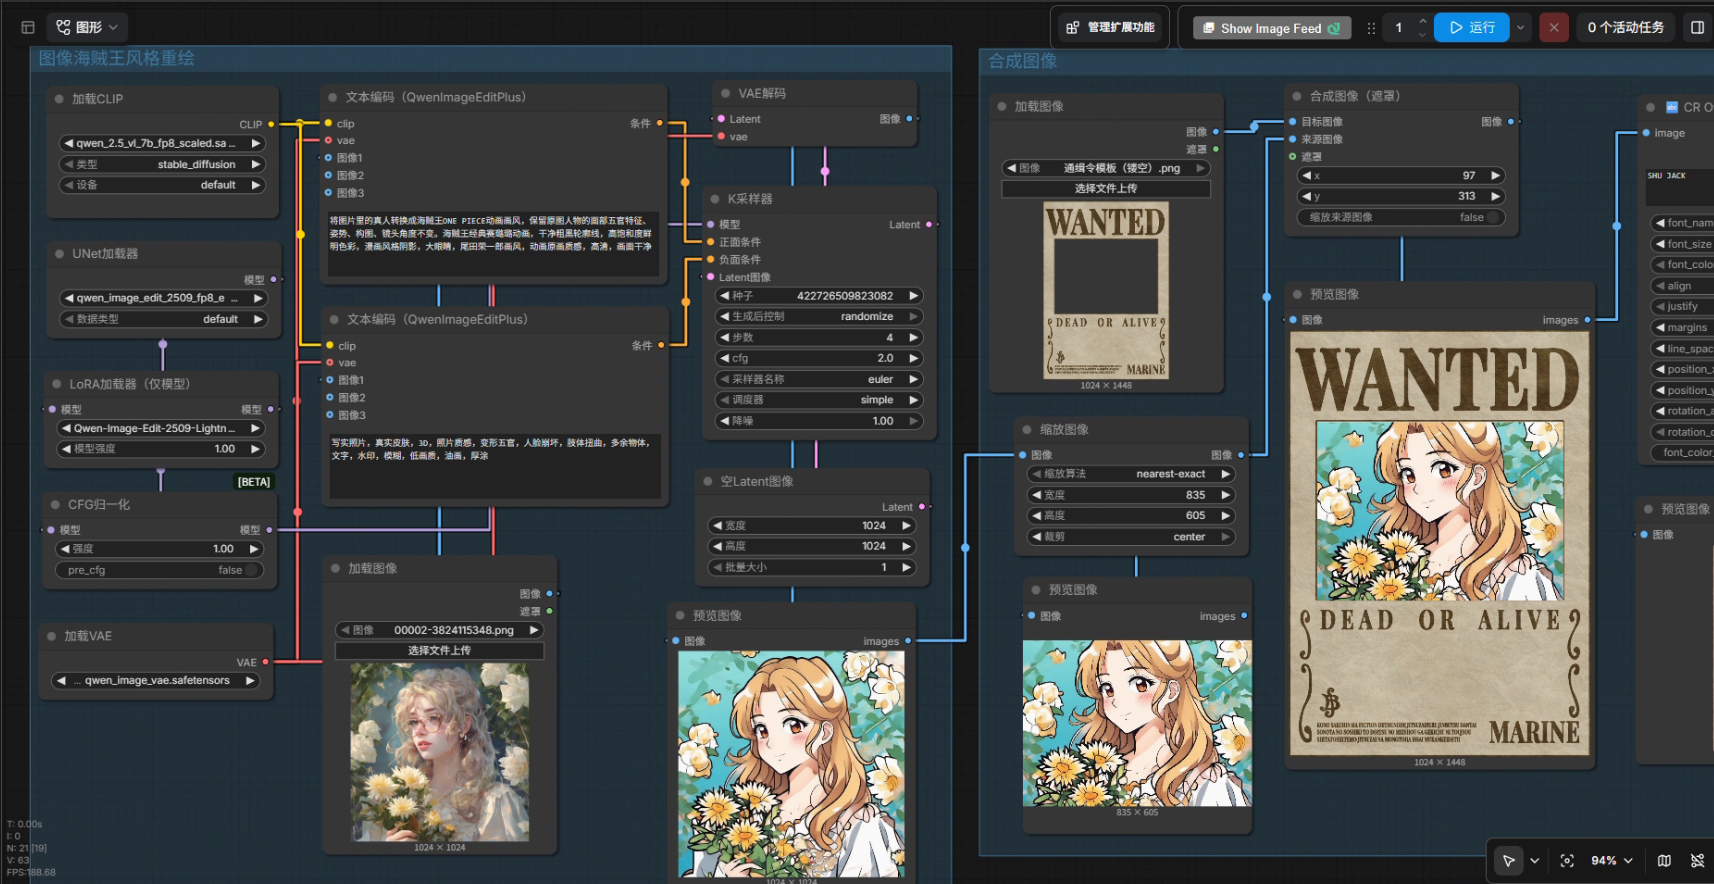
第二部分 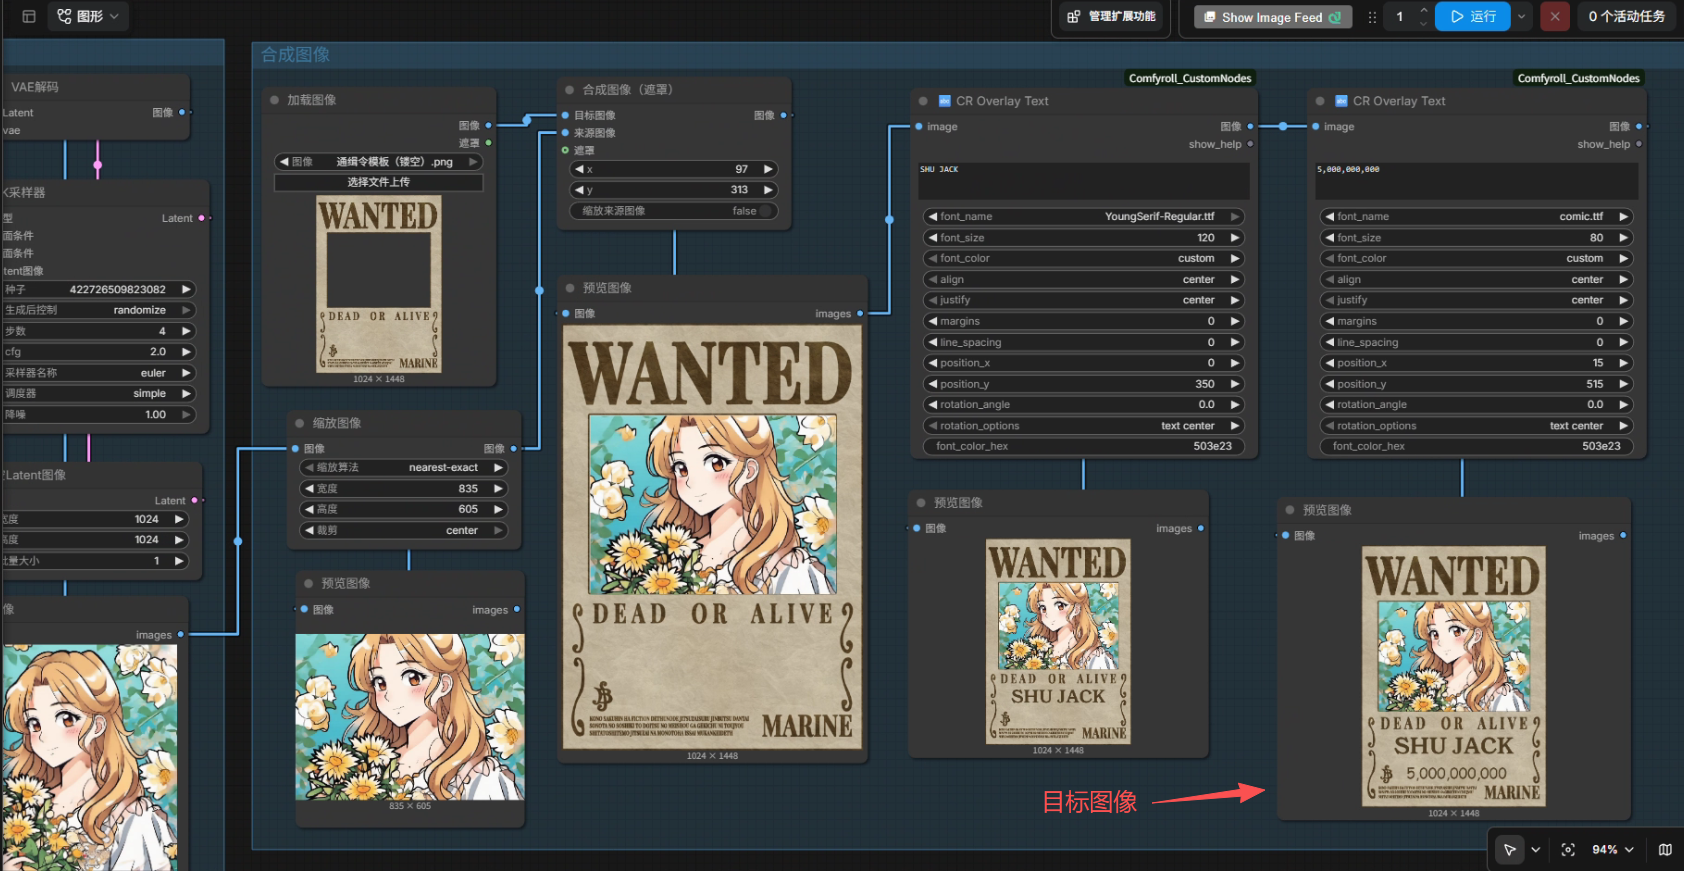
工作流中用到了文字覆盖节点和合成图像节点。节点介绍请看笔记其他部分。
Qwen3-VL 提示词反推工作流
所谓的提示词反推工作流,是指根据输入的图像,视频等媒体文件,通过模型,反推生成对应的文本提示词。
核心原理
提示词反推的核心原理是用具备视觉理解能力的大语言模型(VL模型)读取图片或视频,然后输出通顺的自然语言描述,而非零散关键词。
模型介绍
目前 视觉语言(vlm)模型 Qwen3-VL 的中文理解能力最强,直接输出中文描述,完美适配 Qwen-Image-Edit 等国产模型,支持批量处理。
Qwen3-VL 模型下载地址(需外网访问) https://huggingface.co/Comfy-Org/Qwen3-VL/tree/main/text_encoders
示例工作流
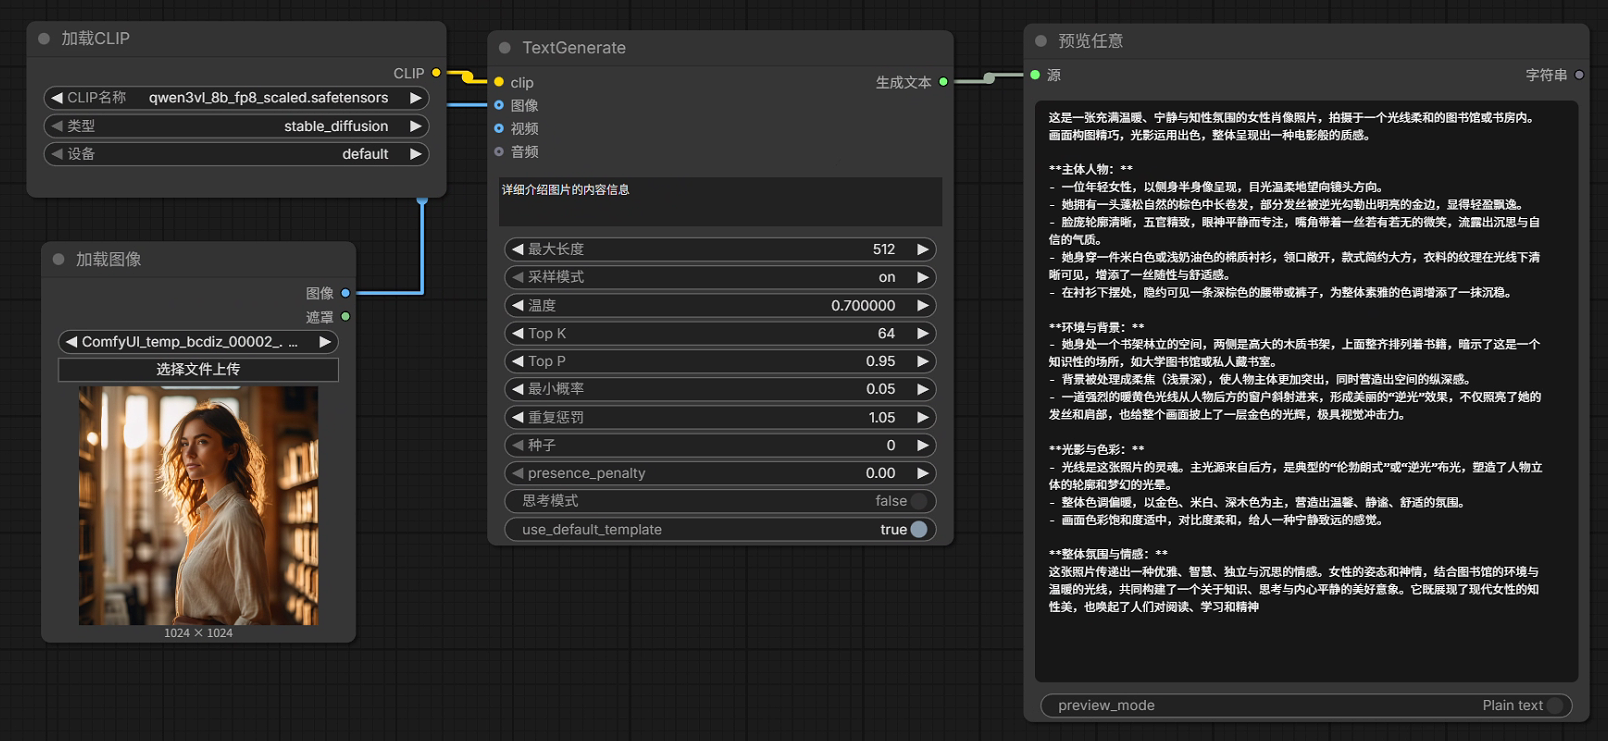
如图是根据一个图片进行提示词反推。图中的CLIP模型是 qwen3vl_8b_fp8_scaled.safetensors 模型。
该工作流耗时约70秒。因此建议工作流验证阶段不建议使用。等到工作流完全搭建好后,再使用提示词反推。
工作流说明
- 图中使用了 PreviewAny 预览任意节点,来预览输入数据的文本表示形式。具体介绍请看其他笔记。
- 图中使用了 TextGenerator 节点,来生成文本提示词。具体介绍请看其他笔记。
wan2.2 文生视频 14B工作流
该工作流采用高低噪声双采样视频生成方案。
高低噪声双采样视频生成方案说明
工作流程说明
- 先初始化一个充满噪点的视频。什么画面都看不见。
- 第一次采样:让高噪声模型对视频噪点进行采样处理。主要任务:把整个视频的框架定下来。人物长什么样、场景是什么、镜头怎么动、物体怎么运动,全部由它决定。最后输出一个视频草稿。
- 第二次采样:让低噪声模型再次对视频噪点进行采样处理。主要任务:把视频草稿的画面变清晰,补上皮肤、衣服、环境细节等。最后输出一个清晰的视频。
相当于用高噪声模型先速写一个视频草稿,再用低噪声模型对视频草稿进行细化,完善视频内容。
采样步数设置说明
官方建议如下:
- 视频质量最高时:总采样步数一共为20步。即第一次采样是10步,第二次采样也是10步。
- 视频质量中等时:总采样步数一共为16步。即第一次采样是8步,第二次采样也是8步。
- 工作流使用了4步LoRA加速模型时:总采样步数一共为4步。即第一次采样是2步,第二次采样也是2步。
优缺点
高低噪声双采样视频生成方案相比其他的视频生成方案:
- 优点:视频质量上限更高。视频帧间一致性更好,抑制闪烁、肢体崩坏能力强。
- 缺点:硬件门槛高,配置复杂,高低噪声双模型显存开销翻倍。
使用模型介绍
- 高噪声文生视频模型:
wan2.2_t2v_high_noise_14B_fp8_scaled.safetensors - 高噪声文生视频加速4步 LoRA 模型:
wan2.2_t2v_lightx2v_4steps_lora_v1.1_high_noise.safetensors - 低噪声文生视频模型:
wan2.2_t2v_low_noise_14B_fp8_scaled.safetensors - 低噪声文生视频加速4步 LoRA 模型:
wan2.2_t2v_lightx2v_4steps_lora_v1.1_low_noise.safetensors - CLIP模型:
umt5_xxl_fp8_e4m3fn_scaled.safetensorsWan 专属的文本编码器。底层是谷歌的T5 语言模型,用于文本提示词的编码。 - VAE模型:
wan_2.1_vae.safetensorsWan 专属视频 VAE 模型。
注意:加速LoRA模型不能交叉混用,高噪声模型只能搭配 高噪声LoRA,低噪声模型只能搭配 低噪声 LoRA,交叉使用直接画面崩坏。
空Latent视频(Hunyuan)节点
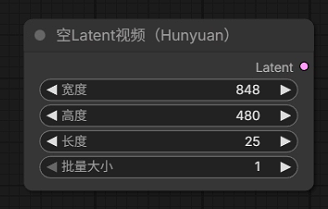
该节点是可以适配 Wan2.2 和 HunyuanVideo 这两个视频模型的空 Latent 视频节点。
之所以该节点命名为 Hunyuan,是因为该节点一开始是为 HunyuanVideo 模型设计的。后来 Wan2.2 模型的官方主动做兼容,因此该节点也可以适配 Wan2.2 模型。
输入输出
- 宽度/高度:视频的宽度/高度。
- 长度:视频的长度。是以帧为单位。
- 输出:生成潜在视频样本,用于后续的视频处理和视频生成。
注意:视频长度是以帧为单位。假设视频是5秒,每秒16帧。那么视频长度应该设置为(5 * 16)+ 1 帧,一共81帧。+1是因为需要额外再补一帧空白帧。
4步Lora加速工作流
如图所示,是高低噪声双采样视频生成方案的工作流。并使用了4步LoRA加速模型。5060ti16G显卡,耗时约130秒。 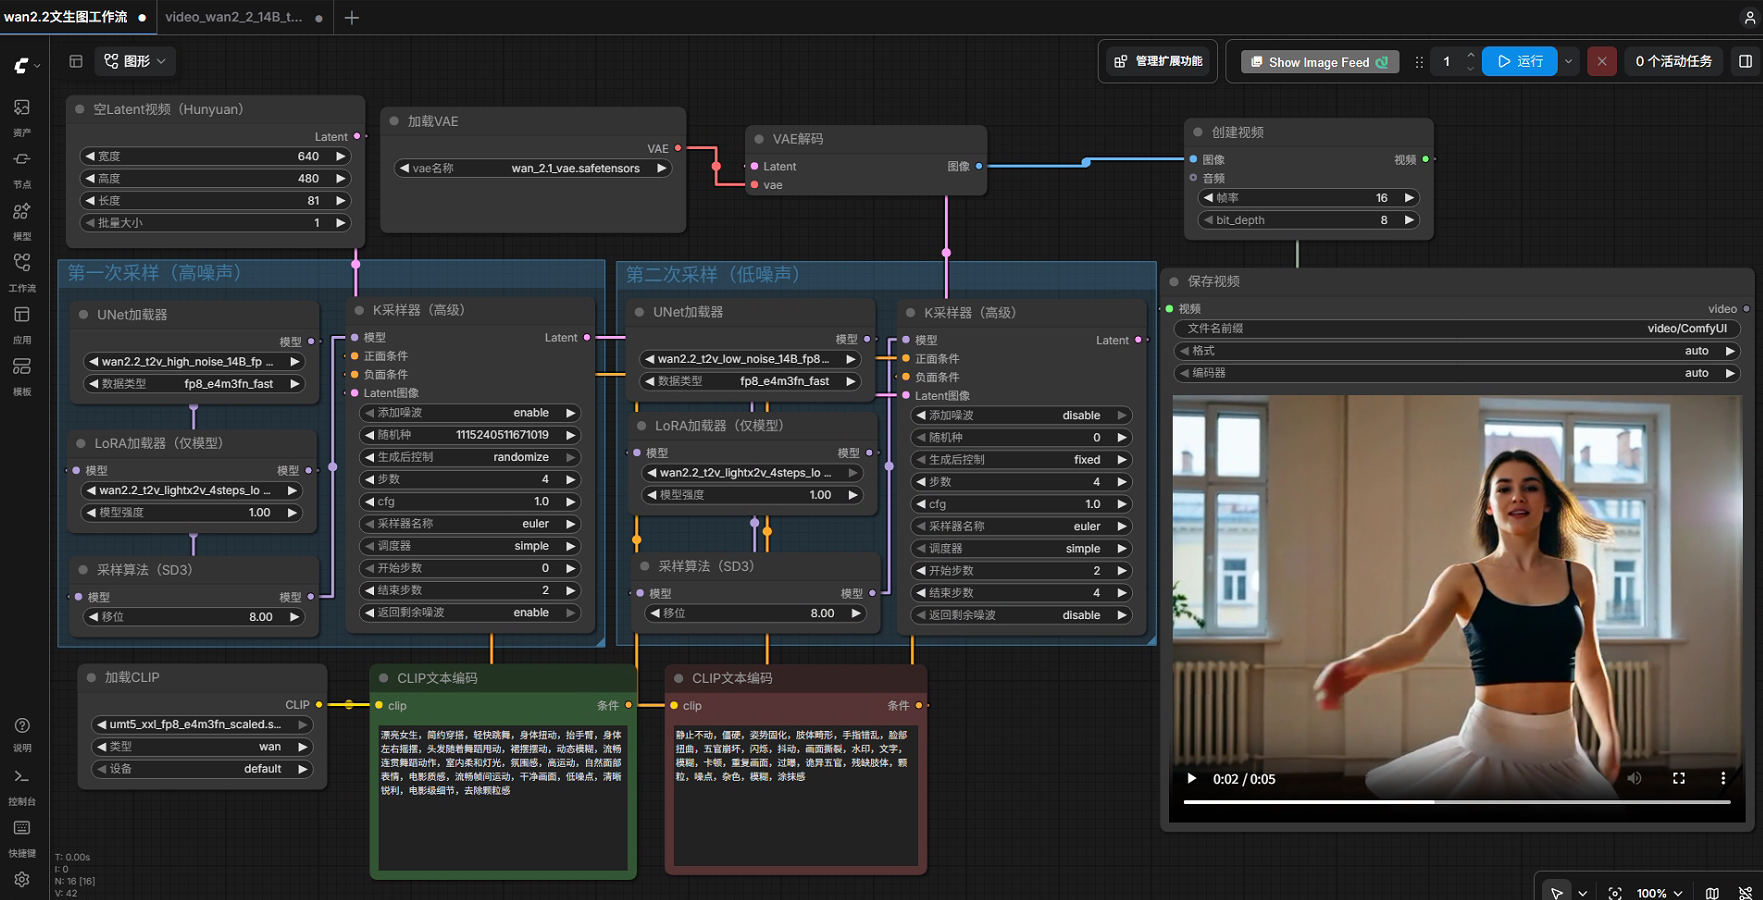
工作流注意说明
- 图中该视频的分辨率是640x480。如果要更高的分辨率,那么生成时间会增加。
- 工作流中使用了K采样器高级节点,并且是通过二次采样的。
- 第一次采样的采样器的数据会作为第二次采样的输入。因此需要开启 添加噪波和返回剩余噪波 选项。
- 第二次采样的采样器输入的数据是从第一次采样中获取的。因此需要关闭 添加噪波和返回剩余噪波 选项。
- 第二次采样器的种子值也需要固定,不固定会导致两个采样器的种子值不一致。
- 由于工作流中使用了4步LoRA加速模型,表示总的采样步数一共为4步。即第一次采样是2步,第二次采样也是2步。因此第一个采样器的开始结束步数为0-2,第二个采样器的开始结束步数为2-4。
- 由于工作流中使用了Lora加速模型,因此CFG值相比不使用Lora加速模型的情况下需要调低,具体数值需要经过多次测试。图中的CFG值设置为1 效果好。
- 工作流中的创建视频节点设置的是16帧/秒。如果想要生成5秒的视频,那么空Latent视频节点的视频长度应该设置为(5 * 16)+ 1 帧,一共81帧。+1是因为需要额外再补一帧空白帧。这两个节点需要搭配使用。
- 加载CLIP模型节点,由于使用的是Wan 专属的文本编码器。因此类型参数需要选择
wan。
wan2.2 图生视频 14B工作流
该工作流采用高低噪声双采样视频生成方案。该工作流是在文生视频工作流的基础上,进行了修改。
使用模型介绍
- 高噪声图生视频模型:
wan2.2_i2v_high_noise_14B_fp8_scaled.safetensors - 高噪声图生视频加速4步 LoRA 模型:
wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors - 低噪声图生视频模型:
wan2.2_i2v_low_noise_14B_fp8_scaled.safetensors - 低噪声图生视频加速4步 LoRA 模型:
wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors - CLIP模型:
umt5_xxl_fp8_e4m3fn_scaled.safetensorsWan 专属的文本编码器。底层是谷歌的T5 语言模型,用于文本提示词的编码。 - VAE模型:
wan_2.1_vae.safetensorsWan 专属视频 VAE 模型。
注意:加速LoRA模型不能交叉混用,高噪声模型只能搭配 高噪声LoRA,低噪声模型只能搭配 低噪声 LoRA,交叉使用直接画面崩坏。
图像到视频(wan) 节点
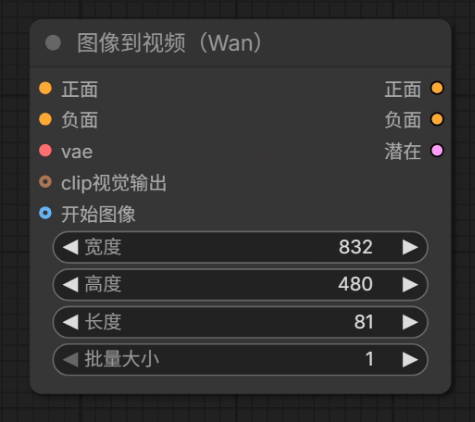
图像到视频(wan) 节点会为视频生成创建一个空的潜在空间,并可以结合起始图像和 CLIP 视觉输出,以引导视频生成过程。
该节点会根据提供的图像和视觉数据,将输入正负面提示词进行二次修改。
参数
- 输入
- 正负面条件:正负面提示词。
- vae:用于将图像编码到潜在空间的 VAE 模型
- clip视觉输出:可选的CLIP视觉模型对象。可额外引导视频生成。
- 开始图像: 可选的起始图像,用于初始化视频生成。
- 宽度/高度:视频的宽度/高度。
- 长度:视频的长度。是以帧为单位。默认值为81帧。
- 输出
- 正负面条件:整合图像和视觉数据的修改后的正负面提示词。
- 生成潜在视频样本,用于后续的视频处理和视频生成。
4步Lora加速工作流
如图工作流。并使用了4步LoRA加速模型。5060ti16G显卡,耗时约220秒。
可以看到通过图片+提示词,来生成的一个5秒的视频。 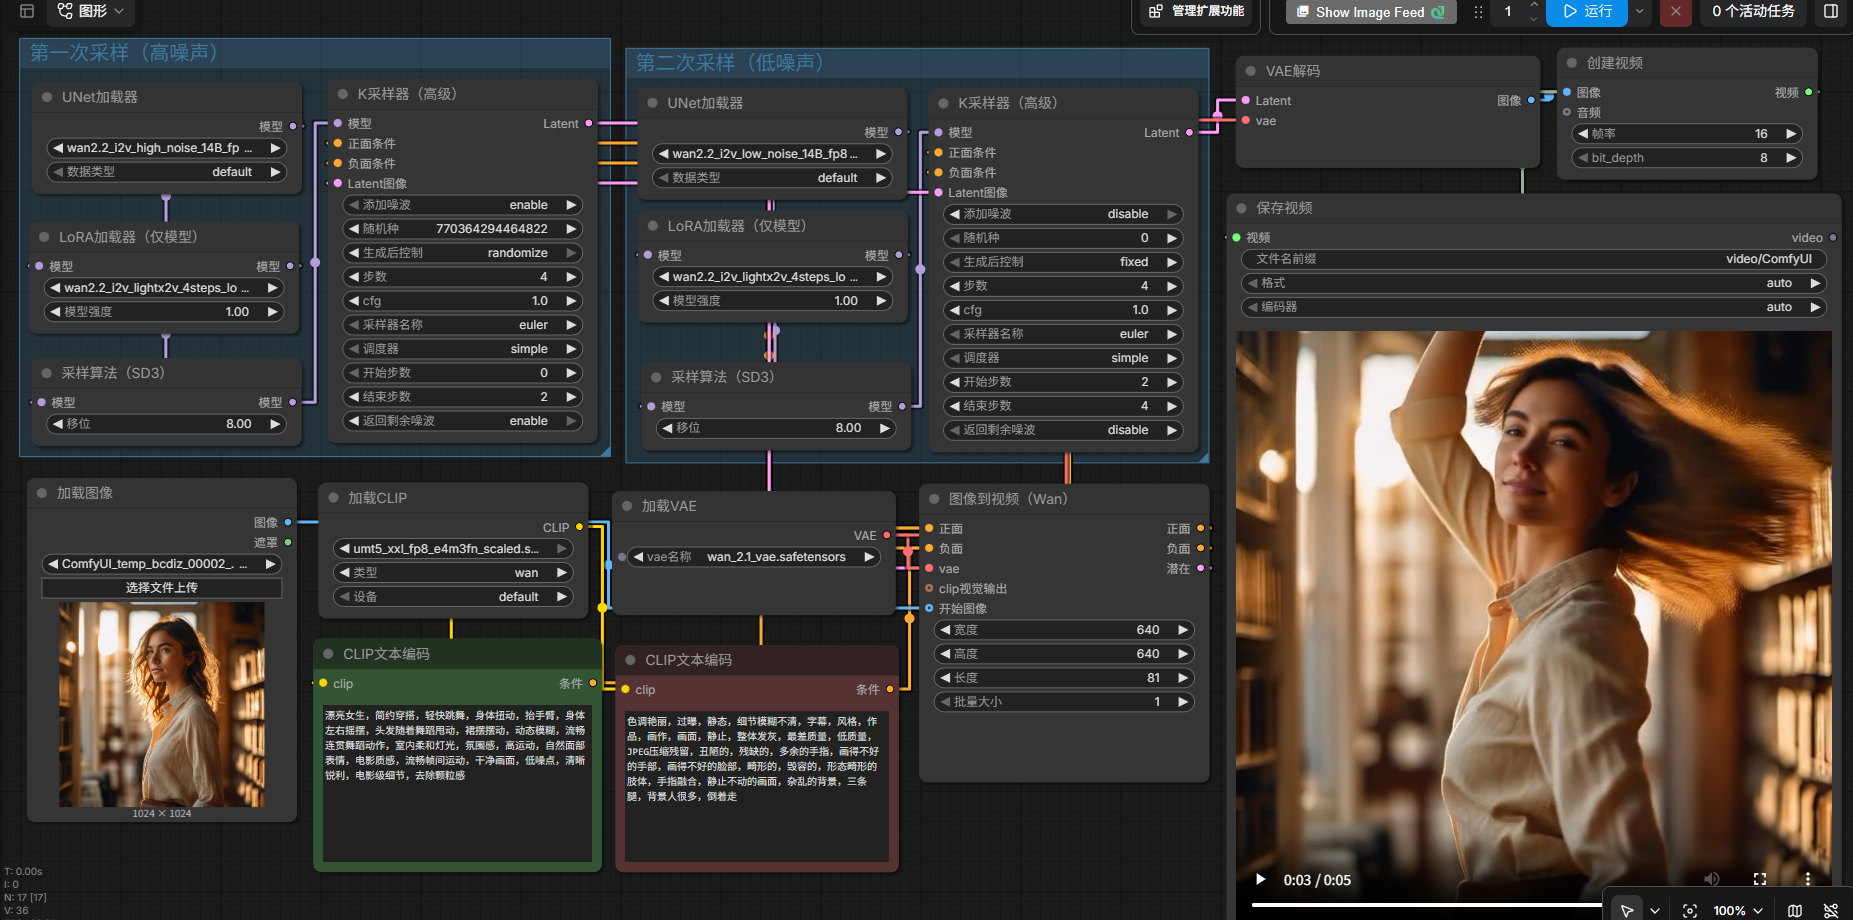
工作流注意说明
- 工作流中添加了图像到视频(wan) 节点,用于加载图片作为视频的起始帧。
- 其他可以参考wan2.2文生视频工作流。
wan2.2 首尾帧图生视频 14B工作流
该工作流是在图生视频工作流的基础上,添加了首尾帧的图像。用于引导视频生成。
使用模型介绍
使用模型参考图生视频工作流。
Wan 首尾帧视频 节点
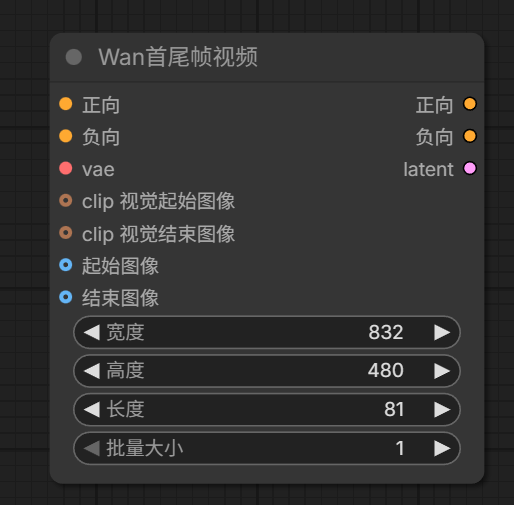
Wan 首尾帧视频 节点通过结合起始帧、结束帧与文本提示词来创建视频条件。
它通过编码首帧和末帧、应用遮罩引导生成过程,并在可用时融入 CLIP 视觉特征,为视频生成生成潜在表示。
参数
- 输入
- 正负面条件:正负面提示词。
- vae:用于将图像编码到潜在空间的 VAE 模型
- clip视觉起始图像:可选的CLIP视觉模型对象。从起始图像提取的 CLIP 视觉特征
- clip视觉结束图像:可选的CLIP视觉模型对象。从结束图像提取的 CLIP 视觉特征
- 起始图像: 可选视频序列的起始帧图像。
- 结束图像: 可选视频序列的结束帧图像。
- 宽度/高度:视频的宽度/高度。
- 长度:视频的长度。是以帧为单位。默认值为81帧。
- 输出
- 正负面条件:整合图像和视觉数据的修改后的正负面提示词。
- 生成潜在视频样本,用于后续的视频处理和视频生成。
调整尺寸并填充图像 节点
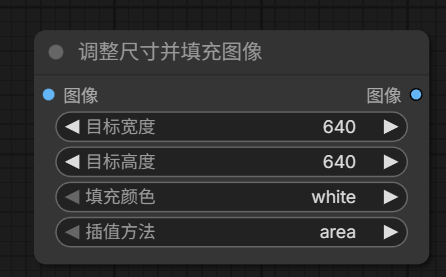
该节点用于将图像调整至指定尺寸范围内,同时保持原始宽高比。它会按比例缩小图像以适配目标宽度和高度,然后在边缘添加填充以填补剩余空间。
填充颜色和插值方法可自定义,以控制填充区域的外观和缩放质量。
参数
- 输入
- 图像:要调整尺寸的图像。
- 宽度/高度:输出图像的宽度/高度。
- 填充颜色:用于填充缩放后图像周围区域的背景颜色。默认值为white。
- 插值方法:用于调整图像大小的插值方法(默认值:"area")。
- 输出
- 调整大小并填充后的输出图像
注意:在通过首尾帧图像生成视频时,需要确保首尾帧图像的宽度/高度一致。否则会导致视频生成异常。
4步Lora加速工作流
如图工作流。5060ti16G显卡,耗时约210秒。
可以看到通过图片+提示词,来生成的包含首尾帧的5秒视频。 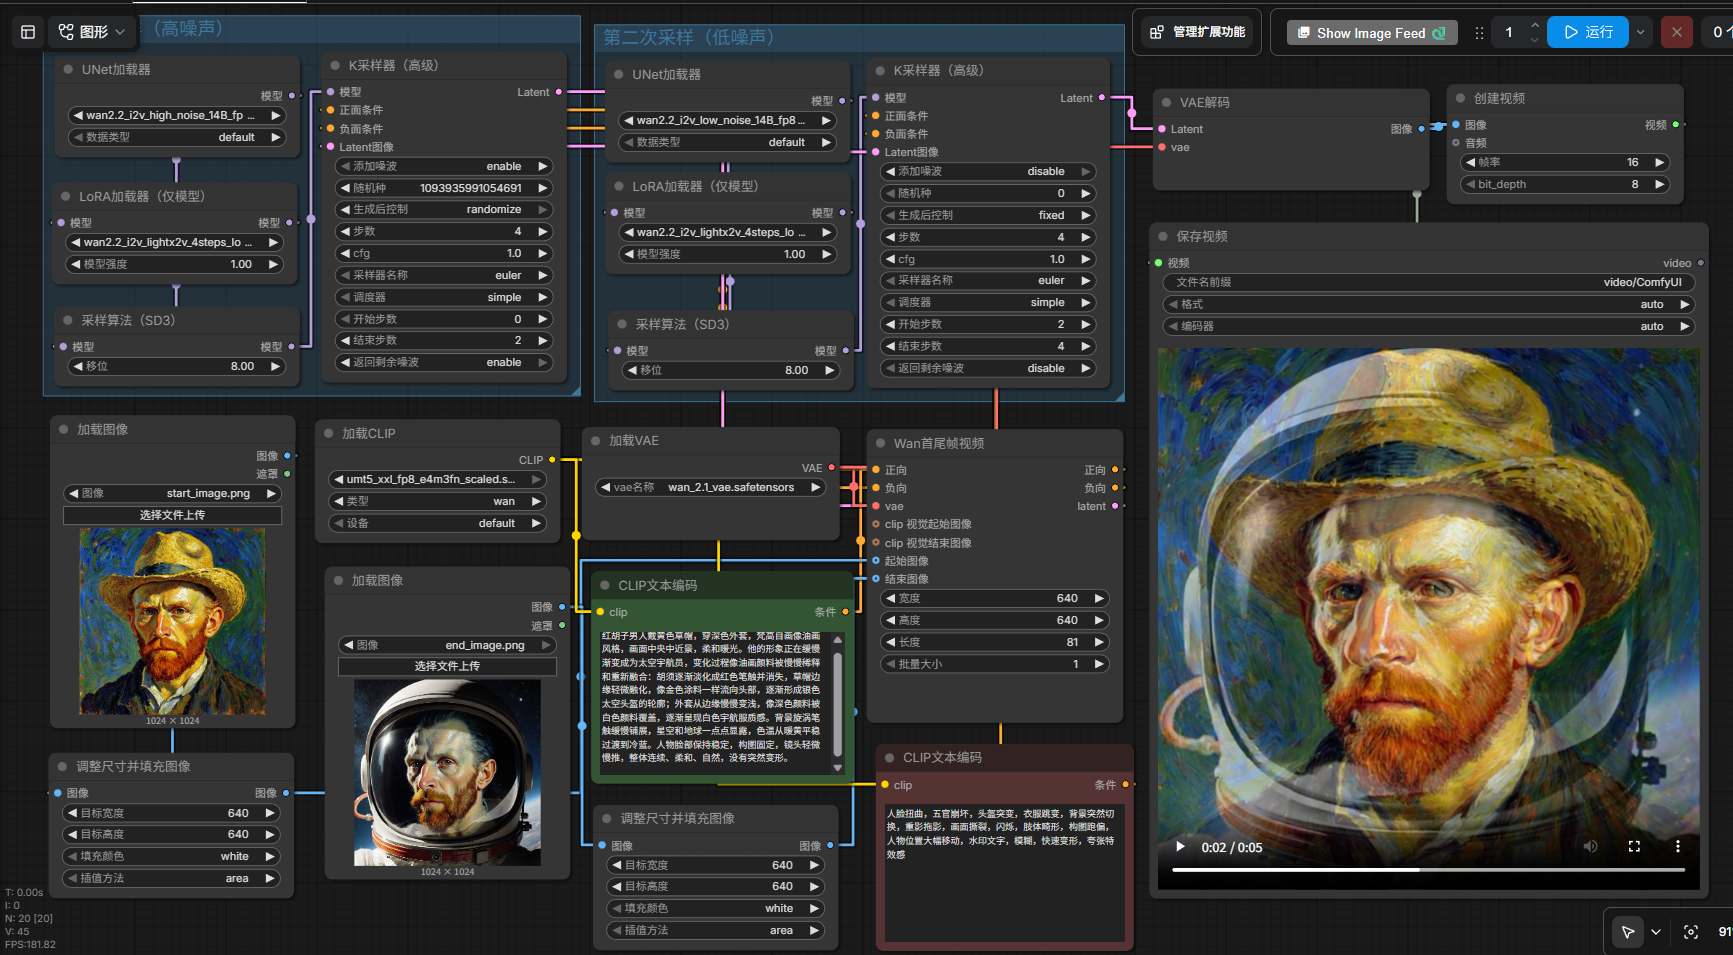
工作流注意说明
- 工作流添加了Wan 首尾帧视频 节点,用于加载首尾帧图像。
- 工作流还添加了 调整尺寸并填充图像 节点,用于调整首尾帧图像的尺寸,使它们的宽度/高度一致。否则会导致视频生成异常。
- 其他可以参考wan2.2图生视频工作流。