[toc]
ComfyUI笔记2
我的当前显卡设备是 NVIDIA RTX 5060TI 16GB。
常用官方节点
| 分类 | 功能 | 常见节点 |
|---|---|---|
| 模型加载 | 加载各种模型 | Checkpoint Loader、CLIP Loader、UNet Loader、VAE Loader、LoRA Loader |
| 文本处理 | 处理提示词 | CLIP Text Encode |
| 图像生成 | 生成图像 | KSampler、Empty Latent Image |
| 图像处理 | 处理图像 | VAE Encode、VAE Decode、Load Image、Preview Image |
| 控制网络 | 控制生成过程 | ControlNet Loader、ControlNet Apply |
模型加载节点
Checkpoint 加载器节点(Checkpoint 模型加载)
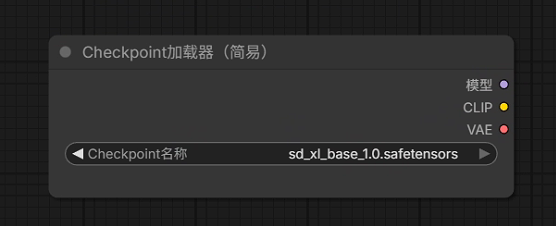
Checkpoint加载器节点是一个模型加载器节点,用于一次性加载完整的Checkpoint模型(包含 UNet+CLIP+VAE)。这个节点会自动检测并加载models/checkpoints文件夹下的所有模型文件。
一个Checkpoint模型文件通常包含了UNet、CLIP、VAE 三个部分的组件。即一个checkpoint模型文件就是完整的图像生成模型。
输入输出
- 输入:选择对应的 checkpoint 模型文件(通常是
.safetensors格式)。 - 输出:
- VAE:VAE 模型对象,供给 VAE 编码/解码节点使用
- CLIP:CLIP 文本模型对象,供给文本编码器节点使用
- 模型:模型对象,用于图像去噪生成的主要扩散模型,是AI绘画的核心组件。
注意事项
- 模型兼容性:确保所选的模型与你的工作流的其他节点兼容,不同的模型(如SD1.5、SDXL、Flux等)需要配合相应的采样器和其他节点。
注意:Checkpoint加载器节点是一个集成节点,该节点适合快速搭建基础工作流。如果需要分别加载UNet、CLIP、VAE 三个组件,就需要分别使用各个组件的加载器节点。
示例
UNet 加载器节点(UNet 模型加载)
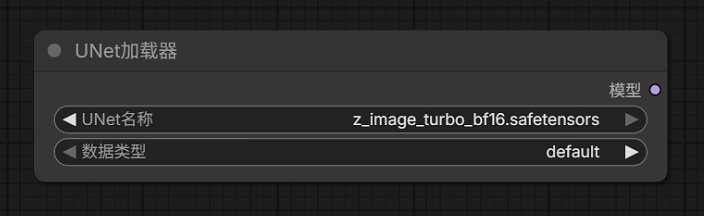
UNet 加载器节点只用于加载 UNet(卷积网络)模型。UNet模型是图像生成模型中的核心组件,负责整个图像生成的降噪计算。
该节点会自动检测并加载位于 models/diffusion_models 文件夹中的模型。
早期图像生成模型的内部是包含UNet+CLIP+VAE三个组件的。因此需要用checkpoint加载器节点一次性加载完整模型(包含UNet+CLIP+VAE三个组件模型)。
在新一代图像生成模型中(如Wan,Flux等),为了方便对模型优化和迭代,都将一个完整的图像生成模型文件(包含 UNet+CLIP+VAE 组件),拆分为三个独立的模型文件。
因此如果要使用新一代图像生成模型,需要分开加载这三个组件。其中UNet 加载器节点只加载 UNet 模型,不加载其他组件。
输入输出
- 输入:选择对应的 UNet 模型文件。(通常是
.safetensors格式)。 - 输出:可调用的 UNet 模型对象,供给其他节点使用。
示例
注意:确保所选的UNet 模型与你的工作流的其他节点兼容,不同的模型(如SD1.5、SDXL、Flux、Wan等)需要配合相应的UNet 模型。错配的UNet 会图像生成失败。
VAE (变分自编码器)加载器节点(VAE 模型加载)
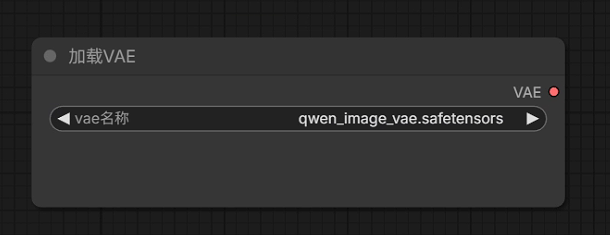
核心功能:只加载 VAE(变分自编码器) 模型文件,为图像编码/解码提供模型基础,本身不直接处理潜在图像。
该节点会检测并加载位于 models/vae 文件夹下的模型。
输入输出
- 输入:选择对应的 VAE 模型文件。
- 输出:可调用的 VAE 模型对象,可以供给VAE 编码节点和VAE 解码节点使用。
注意:确保所选的VAE 模型与你的工作流的其他节点兼容,不同的模型(如SD1.5、SDXL、Flux等)需要配合相应的VAE 模型。错配的 VAE 会导致画面发灰、偏色、模糊。
CLIP 加载器节点 (加载CLIP 文本编码器模型)
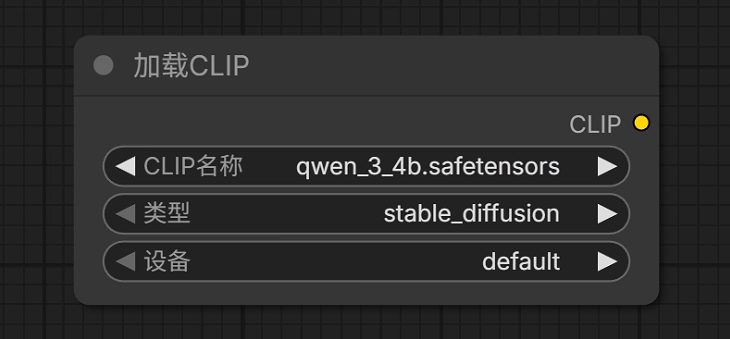
该节点主要用于单独加载 CLIP 文本编码器模型。为文本编码提供模型基础,本身不直接处理提示词。
该节点会检测并加载位于 models/text_encoders 和 models/clip 文件夹下的模型。
支持的模型格式有: .ckpt,.pt,.bin,.pth,.safetensors等格式
输入输出
- 输入:选择对应的 CLIP 模型文件。
- 类型参数:指定要加载的 CLIP 模型类型。默认值为 stable_diffusion 模型,也可以选择 qwen_image,wan,sd3 等其他图像生成模型。
- 设备参数:默认用GPU,也可以选择用CPU。
- 输出:可调用的 CLIP 模型对象,供给文本编码器使用。
注意:不同的生成模型(例如 SD1.5/SDXL/Wan)必须搭配对应的 CLIP 文本模型,错配会导致提示词失效,提示词编码失败等问题。
LoRA 加载器节点(仅模型)
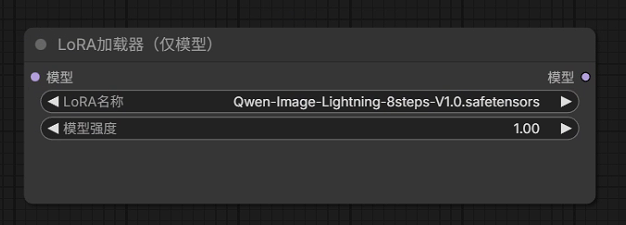
LoRA = 低秩微调轻量模型,用于修改给定的图像模型的风格、画风、构图、细节特征,而不用改动图像模型本身。
此节点专门用于加载LoRA模型,而无需CLIP模型。该节点会检测位于 models/loras 文件夹下的模型。
如果需要加载多个LoRA 模型,你可以直接将多个LoRA 加载器节点进行串联。
输入输出
- 输入:
- 获取图像模型对象。可以是checkpoint模型或UNet模型对象。
- 指定要加载的LoRA 模型文件。
- 输入 LoRA 模型强度参数。通常使用0~1之间, 取值越大, 模型调整的效果越明显。
- 输出:已被 LoRA模型 修改后的图像模型。
LoRA 模型作用
你可以简单把 LoRA 模型理解为滤镜,它通过对图像模型进行微调,从而可以让你的图片具有特定的风格、内容、细节等。
- 使画面具有特定的画风(如水墨画)
- 使人物具有某类人物的特征(如某些游戏角色)
- 使画面具有特定的细节
简而言之,LoRA 可以在不改动图像模型本体的前提下,动态叠加 LoRA 特征权重,从而精准复刻指定画风和角色特征,灵活控制影响强度,是固定画风/角色生成的关键节点。
LoRA 加载器节点
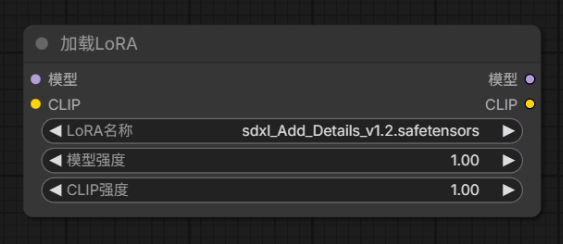
此节点专门用于加载LoRA模型和CLIP模型的组合。该节点会检测位于 models/loras 文件夹下的模型。
输入输出
- 输入:
- 模型:即主模型对象。
- CLIP 模型:即文本编码器模型对象。
- LoRA 模型:需要从
models/loras文件夹中选择的LoRA模型文件。 - 模型强度:模型强度参数。取值范围-100.0 到 100.0 ,日常使用0~1之间, 取值越大调整的效果越明显。
- CLIP 强度:CLIP 模型强度参数。取值范围-100.0 到 100.0 ,日常使用0~1之间, 取值越大调整的效果越明显。
- 输出:
- 输出被LoRA调整了的主模型对象
- 输出被LoRA调整了的CLIP模型对象
注意:如果需要加载多个LoRA 模型,你可以直接将多个LoRA 加载器节点进行串联。
UpscaleModelLoader 加载放大模型节点
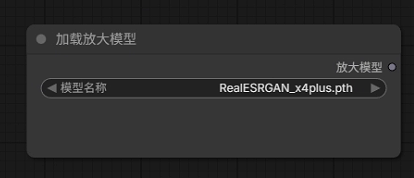
该节点用于从指定目录加载放大模型。此节点将检测位于 models/upscale_models 文件夹中的模型。
- 输入:指定要加载的放大模型文件。
- 输出:可调用的放大模型对象。
文本处理节点
CLIP 文本编码器节点(提示词处理)
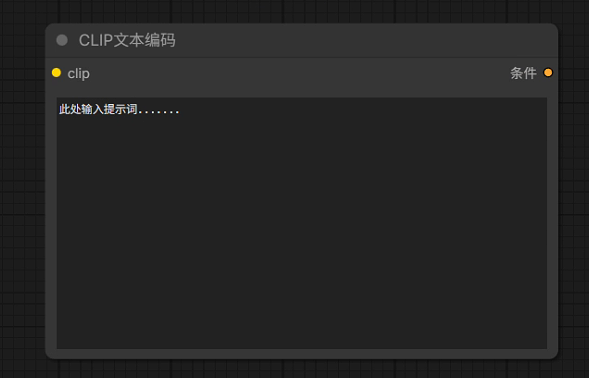
CLIP 文本编码器节点用于调用已加载的 CLIP 文本模型,将人类书写的自然语言提示词,转换为 AI 画图模型能识别的数字向量编码。
输入输出
- 输入:输入提示词文本。输入 CLIP 模型对象。可以从CLIP 加载器节点获取。
- 输出:
- 条件:此处的条件就是经过处理后的提示词向量。供给图像生成模型使用。
TextGenerator 文本生成节点
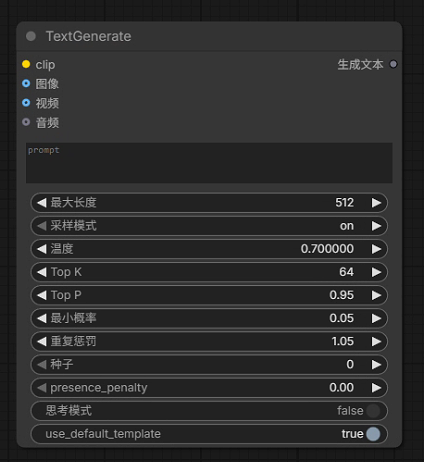
该节点可以通过输入文本提示词、图像、视频等,来生成对应的文本。主要用于提示词的推导。
输入输出
- 输入:文本提示词、CLIP模型、图像(可选)、视频(可选)等
- 输出:生成的文本。
注意:该节点只有高版本的ComfyUI才支持。低版本的ComfyUI不支持该节点。并且低版本的TextGenerator节点(只能输入CLIP和图像的版本)可能出现无法使用的情况(报错说无法读取图片)。
PreviewAny 预览任意节点
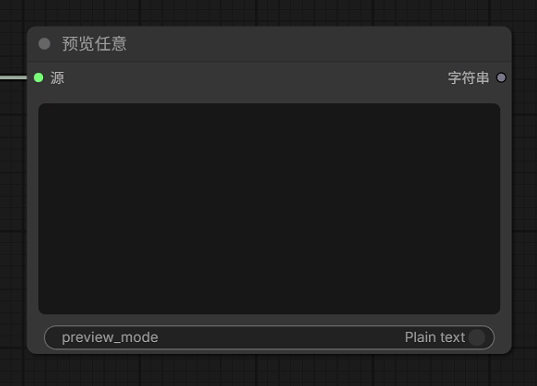
该节点以文本格式显示任意输入数据类型的预览。它接受任何数据类型作为输入,并将其转换为可读的字符串表示形式以供查看。
该节点会自动处理包括字符串、数字、布尔值和复杂对象在内的不同数据类型,尝试将其序列化为 JSON 格式。
输入输出
- 输入:任意数据类型
- 输出:转换为文本格式的输入数据。同时将文本作为字符串输出,以供下一个节点处理。
图像生成节点
空白Latent图像节点
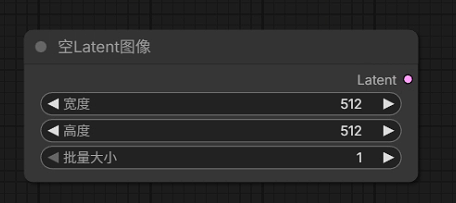
空白的潜在空间图像节点,用于生成或操作的空白潜在空间图像,类似空白画布。为进一步的图像合成或修改过程提供了基础。空白潜在图像是作为图像的初始基底。
相当于给 图像生成模型 准备好一张指定尺寸的 “空白画布”。纸上一开始全是随机噪点,后续图像生成模型就在这张纸上画画并不断迭代。
输入输出
- 输入:要生成的潜在图像的宽度、高度、批量生成数量(一次出几张图)
- 输出:空白潜在图像,格式是压缩后的潜空间(Latent)数据。就是初始噪点画布,送入采样器节点。
注意:Latent潜在空间图像是 AI 画图专用的压缩格式,尺寸只有真实图片的 1/8 左右,运算速度会快很多;AI 全程都在这个图像里作画。
示例
缩放Latent图像节点(放大/缩小 潜在图像)
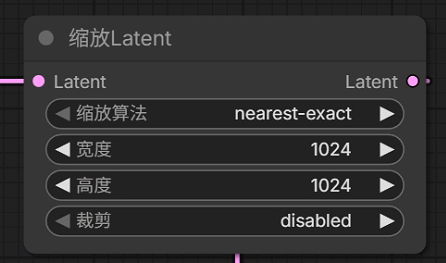
缩放Latent图像节点用于把原图的潜空间图像数据(Latent)放大/缩小到指定尺寸。它通过设置尺寸和缩放算法,来灵活调整潜在图像的尺寸。
输入输出
- 输入:
- 潜在图像数据。
- 目标尺寸(宽度、高度)
- 不同的缩放算法会影响缩放图像的质量和特性。
- 如何裁剪放大后的图像,影响输出的最终外观和尺寸。
- 输出:缩放后的潜在图像数据。
设置Latent噪波遮罩节点(添加遮罩到潜在图像,用于局部重绘)
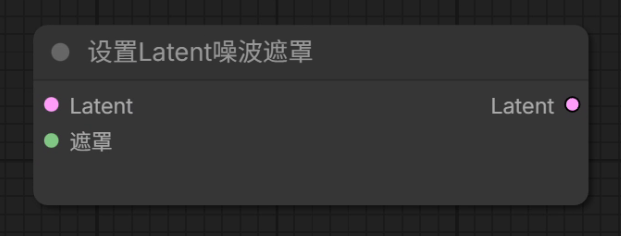
该节点主要用于对图像编码后的latent图像,在遮罩区域添加额外的噪声来进行局部的重绘。
输入输出
- 输入:
- 潜在图像数据Latent。
- 遮罩数据。
- 输出:合并后的潜在图像数据(Latent)数据。
局部重绘中采样器设置的denoise降噪强度,当设置的值越小时,生成的图像会保持和原图越高的相似度。
K Sampler节点(K采样器节点,生成图像)
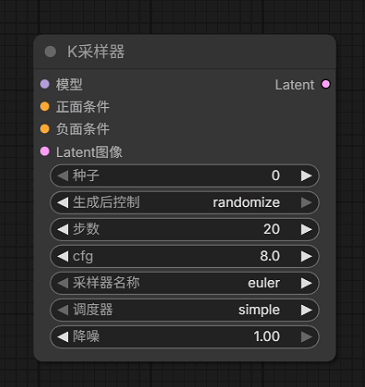
K采样器节点是图像生成中的核心节点,该节点主要作用就是采样。即在潜在图像上反复迭代降噪,一步步把噪点图像变成目标画面。
什么是采样?
采样就是在图像生成过程中给图像进行去噪的过程。
工作过程
- 首先,K采样器节点会获取到提供的模型对象和正、负两种条件,原始潜在图像。
- 然后,它会根据设定好的seed随机种子和denoise降噪强度,先给原始潜在图像加入一些噪声,然后根据提供的模型对象和正、负两种条件,去生成图像。
注意:K采样器节点是文生图中的核心节点。它需要同时接收模型(怎么画)、提示词(画什么)和尺寸(画多大)三个数据信息,才能生成图像。输出的是潜在图像。后续需要交给 VAE 解码成肉眼可见的正常图片
输入输出
- 输入:
- 模型对象,可以是checkpoint模型对象或UNet模型对象。
- 正面/负面条件(来自 CLIP 文本编码器输出的提示词)
- 空白潜在图像(空白Latent图像节点输出的空白潜在图像)
- 输出:降噪完成的潜空间图像(Latent),依然是 AI 内部格式,肉眼无法直接查看。后续需要交给 VAE 解码成肉眼可见的正常图片。
seed 随机种子
核心作用:决定初始噪点的排列规律,相当于画面的 “基因编号”。同一个种子 + 完全相同的其他参数,能 100% 复现同一张图。不同的随机种子,会导致不同的画面生成结果。
优化建议:
- 找灵感阶段:seed数值随机生成,批量出图,挑选出满意的构图和氛围。
- 微调图片阶段:先固定种子数值,只修改提示词/小参数,保证画面整体构图不变、只调整画面细节,这样效率最高。
注意:随机种子的取值范围是 0-4294967295。
steps 采样步数
核心作用:决定采样器在空白潜在图像上迭代的次数。简而言之就是 AI 迭代画面的次数。步数越少生成越快,步数越多细节越完整,但达到「收敛点」后再加步数,画质几乎不会提升,纯浪费时间。
不同模型对应采样步数的推荐值:
- SD-1.5模型:20~28 步
- SDXL模型:24~35步
- Z-Image-Turbo模型:8步
- Wan2.1模型:24~28步
cfg 提示词强度
核心作用:控制 AI “听不听提示词的话”。数值越低,AI 越自由发挥;数值越高,越严格贴合你写的提示词描述。
- 太低(❤️):提示词几乎失效,画面随机感强,内容容易跑偏。
- 太高(>10):画面僵硬、色彩过饱和、细节重复(俗称 “CFG 烧了”),反而会变糊、出现畸形元素。
不同模型对应CFG的推荐值:
- SD-1.5模型:建议5~7。首选6
- SDXL模型:建议5~8。首选7
- Z-Image-Turbo模型:3~5。首选4
- Wan2.1模型:6~7
注意:先按推荐cfg值来,觉得画面不符合描述就加 0.5~1,觉得画面僵硬不自然就减 0.5~1。
denoise 降噪强度 / 重绘强度
核心作用:denoise 降噪强度,有的场景下叫重绘强度。作用是对参考图的改动幅度,0 = 完全和原图一致,1 = 完全重新生成。
注意:仅图生图场景生效,纯文生图相当于是 1(完全重绘)。降噪强度的取值范围是 0-1。
适用场景:
- 0.1~0.3:微改动,只优化画质、光影、色彩,构图主体几乎不变(比如照片修复、提清晰度)。
- 0.3~0.5:轻度重绘,保留主体构图,更换画风、细化细节(比如照片转动漫)。
- 0.5~0.7:中度重绘,主体大致保留,细节和背景大幅修改。
- 0.7~0.9:重度重绘,只保留大致轮廓,几乎重新创作。
- 0.9 以上:接近纯文生图,参考图只剩极浅的影子。
优化技巧:想保留原图结构就往低调,想大改就往高调;想完全重新创作就往1。
K Sampler Advanced 节点(K采样器高级节点,生成视频)
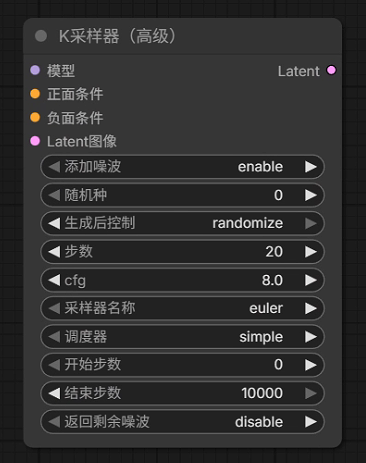
K采样器高级节点 可以通过提供高级配置和技术来增强采样过程。在KSampler 的功能基础上,提供了更多的选项和功能。
参数
- 输入
- 模型对象,可以是checkpoint模型对象或UNet模型对象。
- 正面/负面条件(来自 CLIP 文本编码器输出的提示词)
- 空白潜在图像: 提供采样过程中使用的初始潜在图像。
- 添加噪波: 决定是否在采样过程中添加噪声,从而影响生成的多样性和质量。
- 随机种子:设置噪声生成的种子,用于决定初始噪点的排列规律。从而确保采样过程的可重复性。
- 步数:定义采样过程中执行的步数,影响输出的细节和质量。
- cfg:控制条件因子,影响采样的方向和空间。
- 采样器名称:选择要使用的特定采样器,允许自定义采样技术。
- 调度器:选择用于控制采样过程的调度器,影响样本的进展和质量。
- 开始步数:确定采样过程的起始步骤,允许控制采样的进展。
- 结束步数:设置采样过程的结束步骤,定义采样的范围。
- 返回剩余噪波:指示是否返回带有残留噪声的样本,影响最终输出的外观。
- 输出:生成一个潜在Lantent 数据,提供给后续节点使用。
采样算法节点(对模型采样算法优化)
如图是Flux模型的专属采样算法节点。 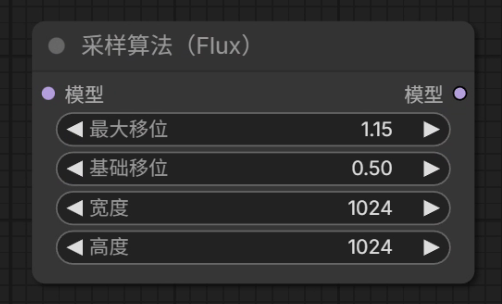
为什么需要采样算法节点?
在早期的图像生成模型(例如传统 SD 模型)全都是标准离散扩散架构,因此这些模型内部都使用都是同一套的标准采样算法。并且在K采样器节点中,也内置了这一套标准采样算法。
这导致在使用这些模型的时候,不需要单独使用采样算法节点,只需要使用K采样器节点,并在其中设置采样算法即可。
但是在新一代的图像生成模型(Wan / Qwen / Flux / Z-Image-Turbo)中,各个模型使用了各自不同的专属采样算法。而K采样器节点中,没有内置这些采样算法。
如果只使用K采样器节点的话,就相当于使用了默认的采样算法,这会导致生成结果的效果不是最优的。
因此在使用这些模型的时候,除了需要使用K采样器节点,还需要单独使用专属的采样算法节点。这样就可以确保生成结果的效果最优。
注意:不同架构的模型(传统 SD、Wan 视频、Qwen、Flux),采样算法的底层逻辑完全不一样,必须用对应的采样算法节点。如果搭配错误,要么报错,要么画面直接崩坏。
采样算法节点的作用
采样算法节点主要是通过改造模型本身,完全不碰图片数据。通过告诉画图模型,需要用哪一种采样算法来生成图像。
- 输入:模型对象。
- 输出:模型对象。
例如将采样算法节点的输入端连接到UNet Loader节点。然后将该节点的输出端与K采样器节点连接起来。这样模型和采样算法的参数就会被传递给K采样器节点。
示例图
CFG 归一化节点
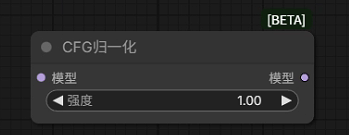
CFG 归一化节点的核心作用
当采样器的CFG 数值高、采样步数少时。这会导致图像生成时的正面条件和负面条件的权重差异很大,从而导致如下问题:
- 色彩过饱和、对比度爆炸、局部过曝
- 画面发灰、出现脏色块、细节生硬
- 结构崩坏、线条撕裂(低步数场景尤其明显)
而为了解决这个问题,我们需要在工作流中添加 CFG 归一化节点。
使用 CFG 归一化节点,会对 CFG 数值进行归一化处理,让CFG数值在采样器每次采样时,保持稳定。
如果把 CFG 引导比作开车打方向:
- 多步采样 = 慢慢开,小幅度多次打方向,车很稳;
- 少步加速 = 高速急打方向,很容易失控跑偏;
- CFG 归一化 = 车身稳定系统,不改变你打方向的意图,只把过度的拉扯修正到安全范围,让车高速也能走直线。
CFG 归一化节点的使用场景① 搭配 LoRA 加速模型时
几乎所有的工作流中使用Lora加速模型的时候,都会搭配CFG归一化节点。
由于添加了 LoRA 加速模型,因此需要修改采样器的采样步数(采样器采样步数需要与Lora加速模型的推荐步数一致)。这样会导致一种情况:CFG 数值高、采样步数少。
而 CFG 数值高、采样步数少时,会导致图像产生下面的负面表现:
- 色彩过曝、颜色炸裂、色块漂移、渐变断层
- 人像五官扭曲、边缘生硬、塑料质感、对比度失控
因此,为了保持图像生成的质量,我们需要在工作流中添加 CFG 归一化节点,来让CFG数值在采样器每次采样时,保持稳定。从而避免图像生成时的负面表现。
CFG 归一化节点的使用场景② 单独使用
CFG 归一化节点也可以单独使用。以下场景中建议单独使用。
- 采样器的CFG值过高时,画面过饱和生硬的情况下。可以使用CFG归一化节点。
- 多ControlNet叠加的场景中,可以使用CFG归一化节点。
- 图像出现色彩断层、整体发灰的情况时,归一化节点可以改善色彩层次,减少灰蒙感。
CFG 归一化节点的连接顺序
模型节点 --> Lora加速模型节点 --> 采样算法节点(可选) --> CFG 归一化节点 --> 提示词节点 --> 采样器节点
CFG 归一化节点应该在 Lora加速模型节点和提示词节点之间。
CFG 归一化节点的强度参数
该节点只有一个强度参数。默认值是1.0,取值范围是0-100。
取值建议如下:
0:完全关闭归一化,等价原生 CFG0.8~0.98:轻微归一化,适合二次元、插画、风格化创作,保留画面饱和度1.0:标准强度,写实人像、电商海报、Qwen 图生图编辑推荐(官方默认)1.2~2.0:强归一化,高 CFG(7~12)、Turbo 1~4 步极速出图,抑制严重色彩炸裂>3:过度归一化,提示词控制力大幅下降,画面模糊、语义跑偏,不推荐
使用建议
当CFG归一化节点需要搭配Lora加速模型节点时,建议采样器的CFG值设置为1.5~2.5。不太建议过高。
图像处理节点
预览图像节点(显示生成的图像)
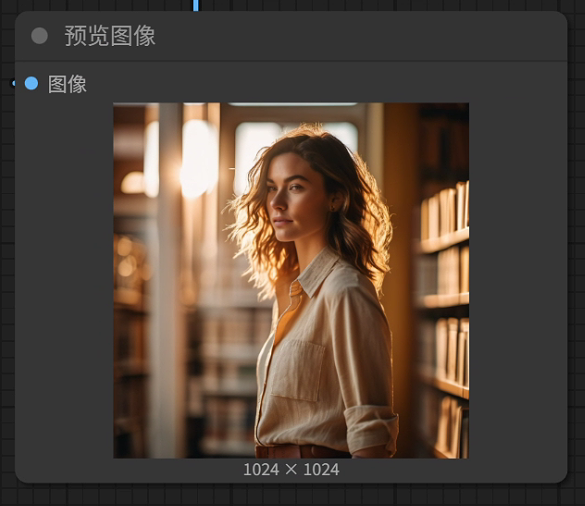
预览图像节点获取图像数据,并将其呈现出来。
加载图像节点(加载外部图像,添加图像遮罩)
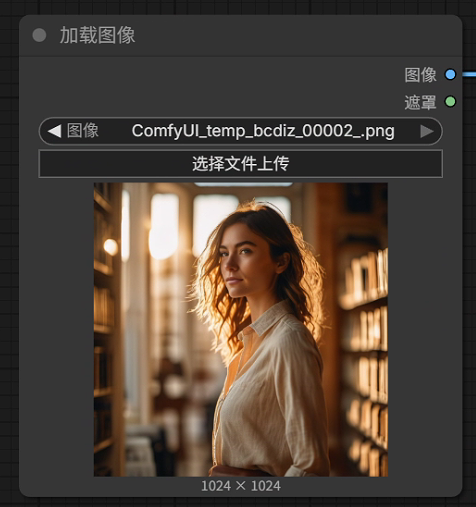
该节点用于加载外部图像,例如从文件系统中加载一张图片。
- 输入:该节点需要接收图像文件路径。
- 输出:输出图像数据。以及为图像提供的遮罩输出(可选),在图像包含用于透明度的场景中非常有用。
注意:该节点常用于图生图场景中,作为参考图。
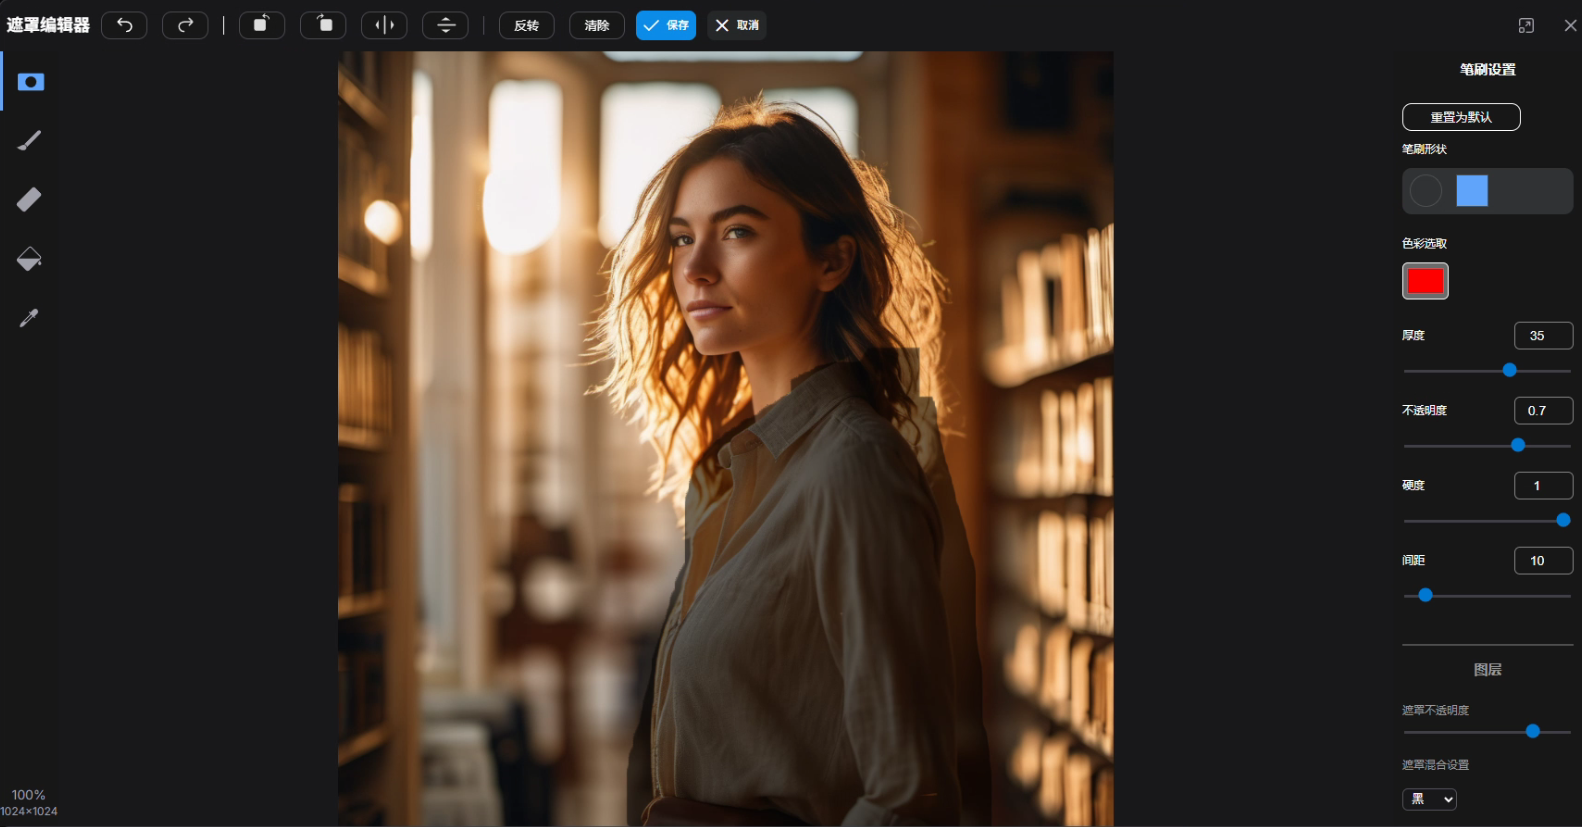
如何给图像添加遮罩?
① 右键点击该节点,在菜单中选择"打开遮罩编辑器"。
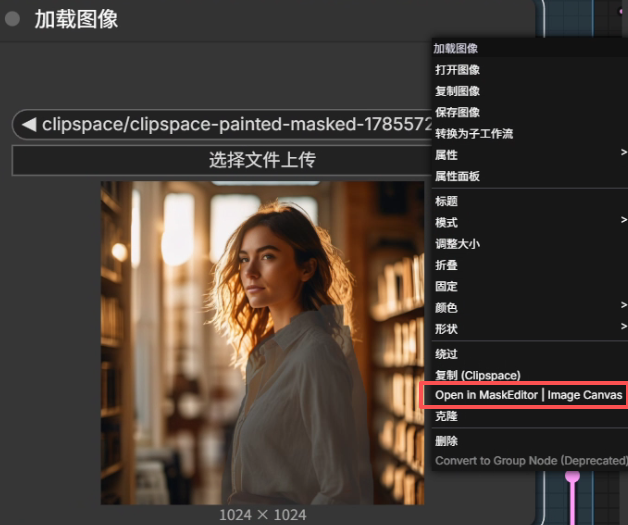
② 在遮罩编辑器上,就可以给图像添加遮罩了。然后点击保存按钮即可。
VAE编码节点(将正常图片转换为潜在图像)
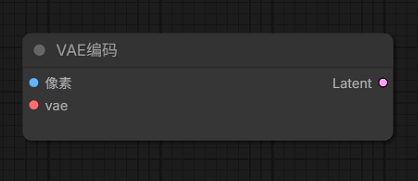
核心功能:调用VAE模型,把正常 RGB 图片编码成潜空间图像(Latent)。通常用于图生图场景中。
输入输出
- 输入
- 像素:是指正常 RGB 图像数据。
- VAE:要使用的VAE模型对象。可以从VAE 加载器节点获取。
- 输出:潜在图像(Latent)数据,格式是压缩后的潜空间数据, AI 内部格式,肉眼无法直接查看。
VAE编码(局部重绘)节点 (专门用于局部重绘场景)
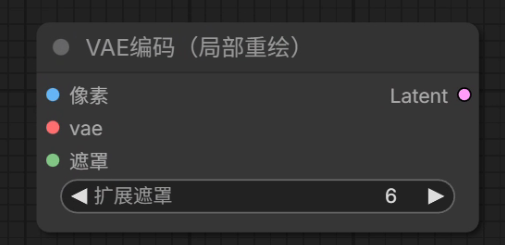
VAE编码(局部重绘)节点用于将图像转换为潜空间图像,并且额外提供遮罩提供给模型。从而让采样器知道该对遮罩部分进行去噪(重新生成)。
该节点适合用于对于局部重绘替换成与原始图像完全不相关的内容。
输入输出
- 输入
- 像素:是指正常 RGB 图像数据。
- VAE:要使用的VAE模型对象。可以从VAE 加载器节点获取。
- 遮罩:是指图像的遮罩数据,用于指定需要重绘的区域。
- 输出:附加了遮罩的潜在图像(Latent)数据。
注意:使用此节点时,请勿将采样器中的denoise降噪强度设置过低,否则将出现重绘后图像蒙版区域为灰白色块情况。
VAE解码节点(将潜在图像转换为正常图片)
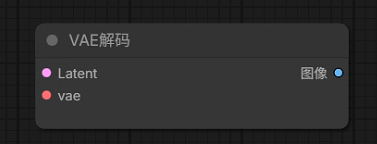
核心功能:调用VAE模型,把潜空间图像数据,解码还原成我们肉眼可以查看的正常 RGB 图片。
输入输出
- 输入
- 潜在图像(Latent)数据,格式是压缩后的潜空间数据, AI 内部格式,肉眼无法直接查看。
- VAE:要使用的VAE模型对象。可以从VAE 加载器节点获取。
- 输出:正常 RGB 图片。肉眼可以直接查看。
图像对比节点(对比两张图像的差异)
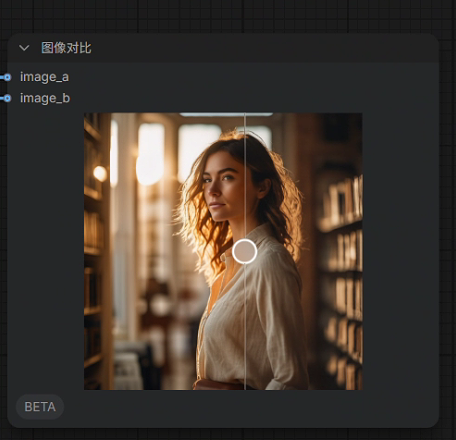
图像对比节点提供一个可视化界面,通过可拖动的滑块并排比较两张图像。
参数
- image_a是要比较的第一张图像。
- image_b是要比较的第二张图像。
使用模型放大图像 节点
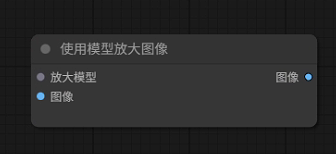
此节点它通过将图像以分块方式应用放大模型来高效管理放大过程。
- 输入:放大模型对象和需要放大的图像。
- 输出:放大后的图像。
注意:放大倍率是根据放大模型来的,该节点无法自定义放大倍率。例如用的是4倍放大模型,那么放大倍率就是4倍。
如果想要将放大后的图像调整到合适的尺寸,还需要搭配缩放图像节点。
视频相关节点
下面是一些通用的,视频相关的节点。
创建视频节点(通用的)
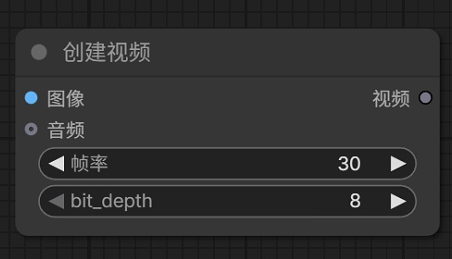
创建视频节点可根据图像序列生成视频文件。并可以通过每秒帧数指定播放速度,可选择为视频添加音频。
该节点是通用的视频生成节点。全部视频模型都可以用,不属于某个视频模型专属的节点。
参数
- 输入:
- 图像:要生成视频的图像序列。
- 帧数:视频播放速度的每秒帧数(默认值:30.0)。
- 音频:要添加到视频中的音频文件。可选参数。
- 输出
- 视频:输出一个生成的视频文件,包含输入图像和可选的音频。
简而言之,该节点可以将图像合成为视频,并以指定的帧率进行播放。
ControlNet 相关节点
加载ControlNet模型 节点
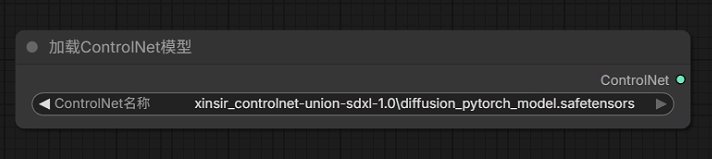
该节点会检测位于 models/controlnet 文件夹下的模型。
该节点设计用于从指定路径加载一个ControlNet模型。然后初始化ControlNet模型对象提供给其他节点使用。
- 输入:指定需要加载的ControlNet模型文件路径。
- 输出:输出ControlNet模型对象。提供给其他节点使用。
应用ControlNet 节点
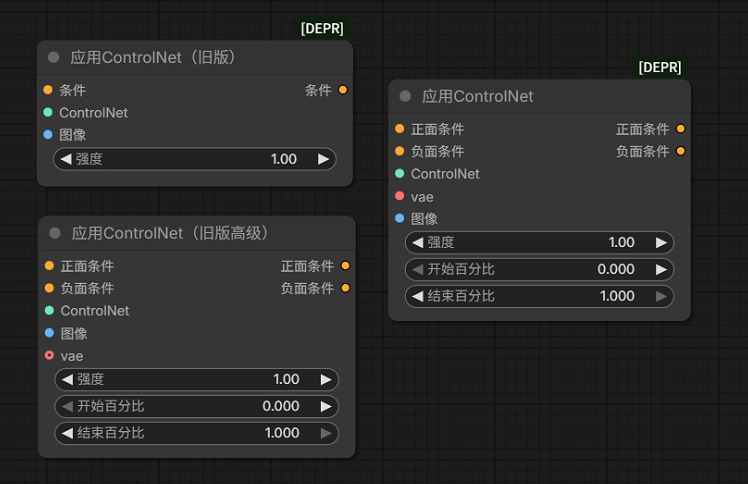
节点说明
如图所示,这三个节点都是用于应用ControlNet模型的。其中有两个节点即将过期,因此目前建议使用 应用ControlNet(旧版高级) 这个节点。
目前 ComfyUI 为了保证兼容性,在许多工作流中应该还可以看到 应用ControlNet(旧版) 节点,但是目前已经无法通过搜索或者节点列表看到 应用ControlNet(旧版) 节点,所以请使用 应用ControlNet(旧版高级) 这个节点。
节点作用
应用ControlNet(旧版高级) 这个节点的作用是 将 ControlNet 模型,控制图, 正负面条件 结合在一起,从而输出一个符合控制图的图像的正向条件/负向条件。
输入输出
输入
- 正向条件/负向条件:来自 CLIP文本编码器或者其它条件输入
- ControlNet:要使用的ControlNet模型对象。
- 图像:用于ControlNet应用的图片,注意此处的图片不是原图,而是需要经过预处理器处理好的控制图。例如姿态图,深度图,线稿图等。
- VAE: 要使用的VAE模型输入。
- 强度: 用来控制网络调整的强度。建议取值在0.5~1.5之间比较合理,越小则模型会发挥越高的自由度,越大则会被限制得越严格。过高会出现很诡异的画面。
- 开始百分比start_percent: 取值 0.000~1.000,确定开始应用controlNet的百分比,比如取值0.2,意味着ControlNet的引导将在扩散过程完成20%时开始影响图像生成。
- 结束百分比end_percent: 取值 0.000~1.000,确定结束应用controlNet的百分比,比如取值0.8,意味着ControlNet的引导将在扩散过程完成80%时停止影响图像生成。
输出
- 正面条件/负向条件:经过ControlNet 处理后的正向条件/负向条件数据,可以输出到下一个ControlNet 节点 或者 K采样器节点。
注意事项
ComfyUI官方的 应用ControlNet 节点只接受「经过预处理器处理好的控制图(不是原图)」。该节点不会自动把普通图像转换成姿态骨架图/深度图/线稿图等。
这个「普通图 → 控制图」的转换步骤,就是预处理器的工作,但是ComfyUI 官方不带预处理器,所以如果要用预处理器,目前需要通过安装第三方自定义节点包来实现。
例如ComfyUI_controlnet_aux自定义节点包,该节点包包含了多个预处理器节点,用于把普通图像转换为姿态图/深度图/线稿图等类型的控制图。
因此要么把普通图像先经过预处理器处理后,再输入到 应用ControlNet 节点。要么直接使用控制图作为输入图像。
ComfyUI Examples 官方示例工作流工程
ComfyUI_examples是 ComfyUI 官方维护的工作流示例仓库,提供涵盖文生图、图生图、ControlNet、视频生成等场景的可加载 JSON 工作流模板与配置说明,用于快速学习节点连接逻辑与参数设置 。
仓库地址 https://github.com/comfyanonymous/ComfyUI_examples
下面的各个工作流有的来自 ComfyUI_examples 仓库。有的是网上找到的。有的是自己搭建的。
文生图工作流
SDXL 文生图工作流
模型介绍
SDXL模型是一个基于离散扩散架构的图像生成模型。模型内部已经内置了UNet,CLIP,VAE组件。因此只需要用checkpoint 加载器节点加载SDXL模型即可。
使用的模型文件
- checkpoint 模型文件:sd_xl_base_1.0.safetensors
工作流节点说明如下
- Checkpoint 加载器节点:一次性加载 SDXL 主模型,同时输出 模型对象、CLIP(双文本编码器)、VAE模型对象。
- CLIP文本编码器节点:输入并处理正面/负面提示词,输出为AI语言。
- K采样器节点:进行图像采样。
- 空latent图像节点:创建一个指定尺寸的空白潜在图像,传递给K采样器节点。这就像给画师准备好一张指定大小的画纸。
- VAE解码器节点:该节点通过调用VAE模型,将潜在图像转换为正常图像。
- 预览图片节点:显示生成的图像。
由于SDXL模型依然是标准离散扩散架构,而 K 采样器节点已经内置了对应的采样算法,因此整个工作流不加采样算法节点也可以。加了属于重复操作,没有任何效果提升。
注意事项
- 空白潜在图像的尺寸最好设置为1024x1024。因为SDXL模型的最佳图像分辨率就是1024x1024。如果设置为其他尺寸,可能会导致生成结果效果不好。
- K采样器节点中,采样器设置为dpmpp_2M(即 DPM++ 2M )。调度器设置为karras。这组搭配效果最好。
- SDXL模型的正面提示词和负面提示词,都需要用英文。对中文理解能力有限。
截图
如图所示,当搭建好图中的工作流后,点击运行按钮,程序就会按照工作流的节点顺序依次执行。最终生成一张图像。 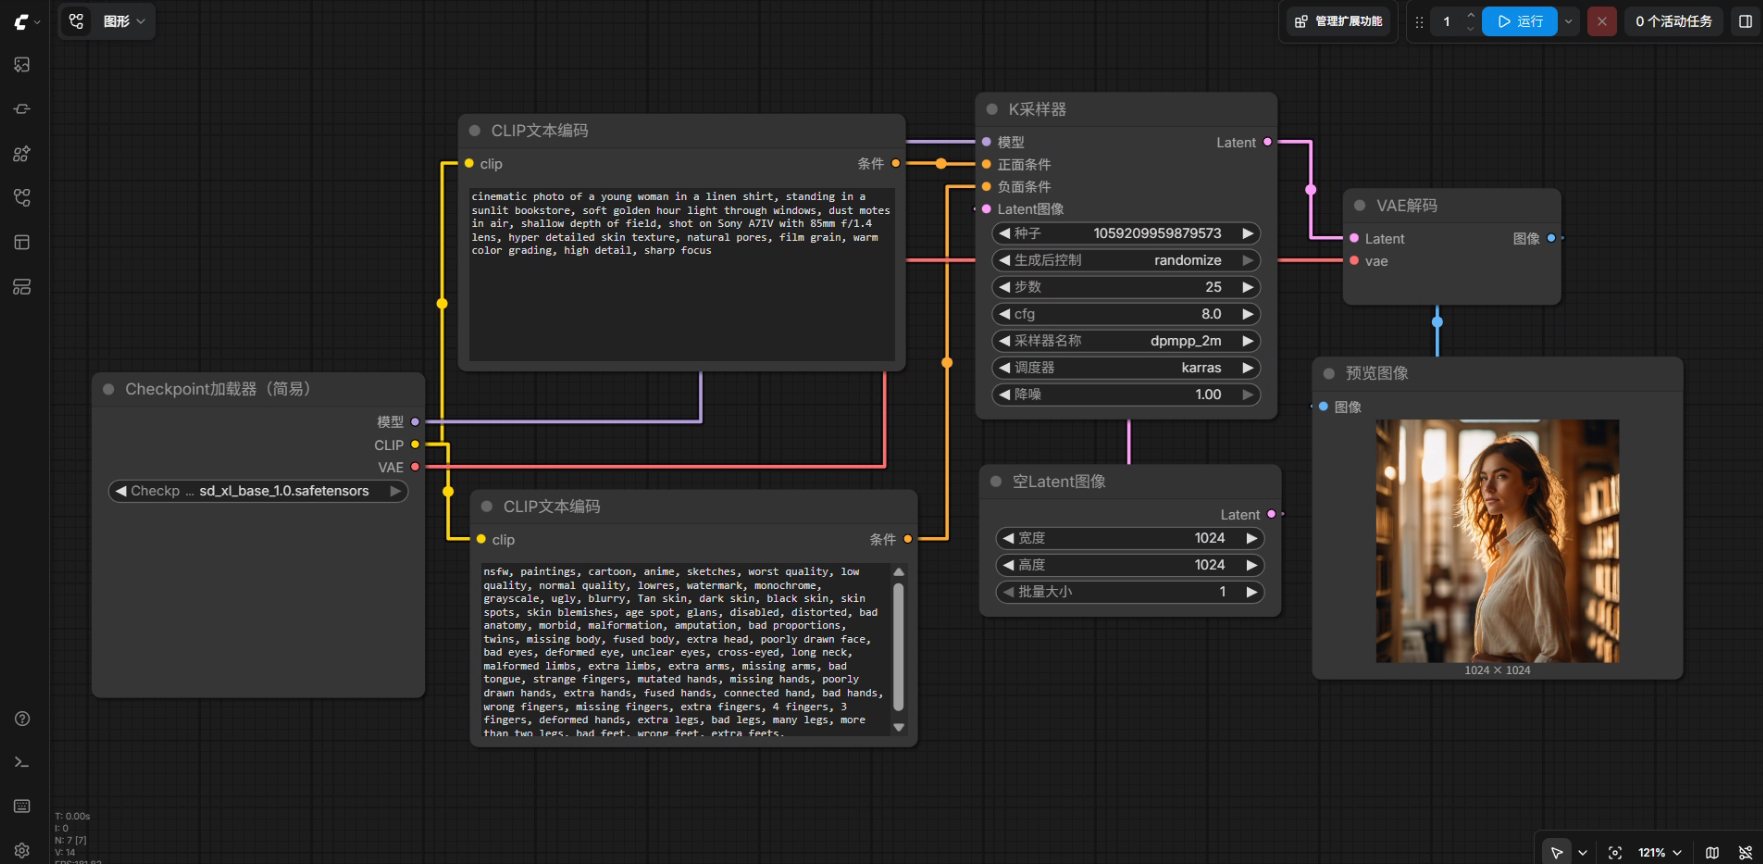
z-image-turbo 文生图工作流
模型介绍
z-image-turbo 模型是阿里巴巴通义实验室于 2026 年 1 月发布的开源高性能文生图模型,属于Z-Image(造相)系列的蒸馏加速版本。是 6B 参数的轻量化极速生成模型,主打「小体积、快速度、消费级显卡就能跑」。
z-image-turbo模型的最佳图像分辨率是1024x1024。
z-image-turbo 模型是新一代拆分式架构的。完整可用的 Z-Image-Turbo 是一套由 3 个独立文件 组成的模型,不像SDXL模型那样打包成一个模型文件。三个文件如下。
- UNet 图像生成模型:z_image_turbo_fp16.safetensors(或其他量化版本的)。
- CLIP 文本模型:qwen_3_4b.safetensors(阿里巴巴通义千问团队研发,适配的CLIP模型)。
- VAE 编码解码模型:ae.safetensors(模型原配 VAE)。
工作流节点说明如下
- UNet Loader(UNet加载器节点):只加载UNet模型,为图像生成提供基础支持。
- CLIP Loader(CLIP加载器节点):只加载 CLIP 文本模型。为文本处理提供支持。
- VAE Loader(VAE加载器节点):只加载 VAE 模型,为潜在图像转换提供支持。
- CLIP Text Encode(CLIP文本编码器节点):输入并处理正面/负面提示词,输出为AI语言。需要连接到 CLIP 加载器节点。
- KSampler(K采样器节点):用图像生成模型来生成图像(注意生成的是噪声图的潜在图像。人类无法直接识别。不是最终的图像结果)。
- Empty Latent Image(空latent图像节点):创建一个指定尺寸的空白潜在图像,传递给 KSampler节点。这就像给画师准备好一张指定大小的画纸。
- VAE Decode(VAE解码器节点):该节点通过VAE模型,将潜在图像转换为图像。用于将计算机画画的结果转换为人类的图像结果。
- Preview Image(预览图片节点):显示生成的图像。
- 采样算法节点(可选):用于调整模型内部的采样算法。
如图是Z-Image-Turbo模型的文生图工作流图截图。 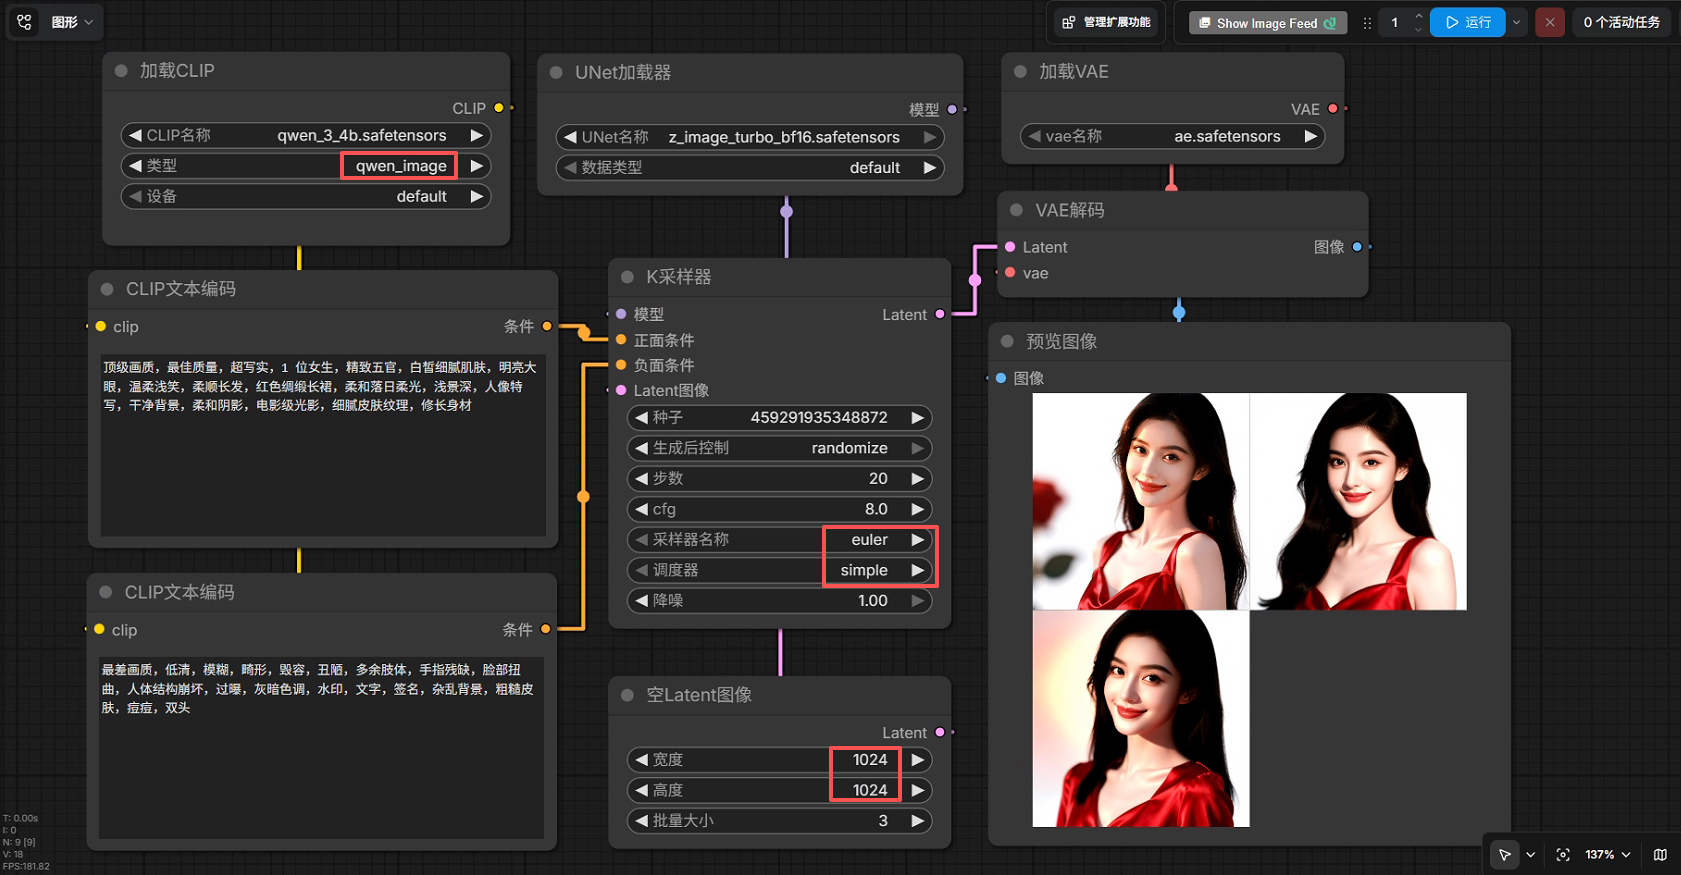
如图是添加了采样算法节点的工作流图截图。 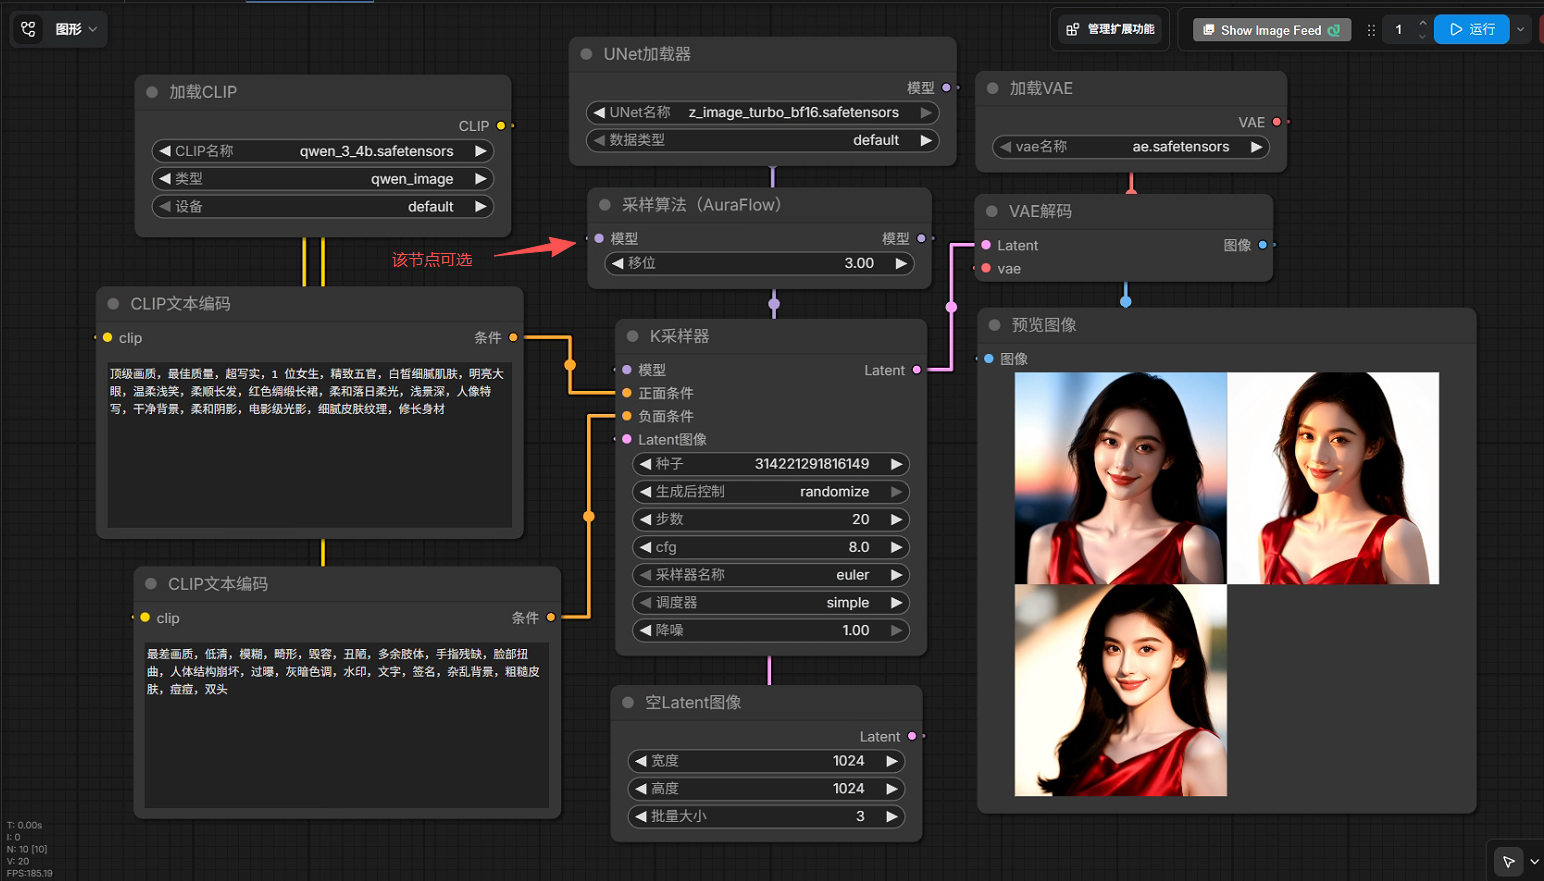
图中加载CLIP节点中的类型可以是default。也可以选择为qwen_image。
注意事项
注意:由于新一代模型的拆分式架构,因此不是通过checkpoint 加载器节点加载一个模型即可。而是需要分别使用三个节点去加载UNet,CLIP,VAE模型进行组合使用才行。
图生图工作流
SDXL 图生图工作流
相比文生图工作流,图生图工作流的节点组成是不同的。
工作流节点说明如下(额外说明)
- 加载图片节点:加载一张图片,作为图生图的原图输入。
- VAE编码节点:把原图编码成潜空间图像数据(Latent)。通常用于图生图场景中。
- 缩放Latent图像节点:放大/缩小原图的尺寸,来对应新图的尺寸。
- K采样器节点:在图生图场景中,可以通过调节降噪强度来控制生成图像相似性,越小越相似,越大越不同。
注意事项
- 如果我们想要的新图尺寸与原图尺寸不同,可以通过缩放Latent图像节点来实现。
截图
下面用SDXL模型来演示一个基础的图生图工作流。可以看到原图与新图的相似度是不同的。
如图所示 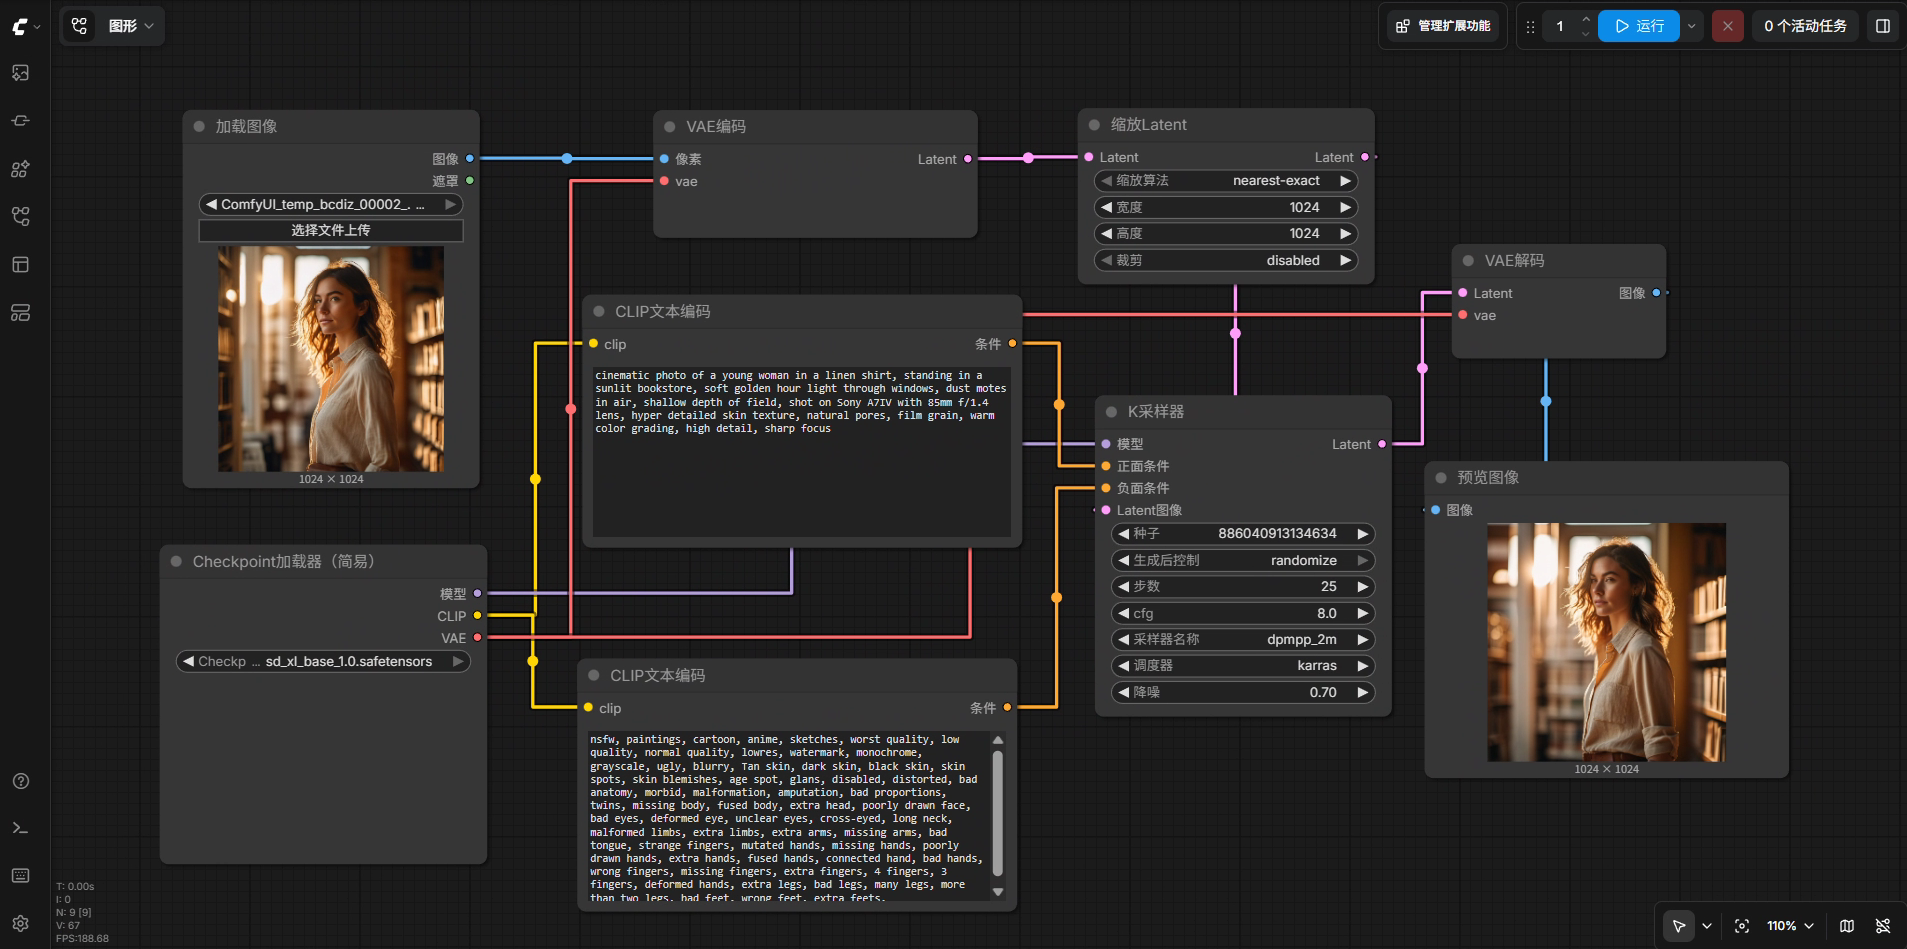
图像高清放大工作流
高清放大工作流的作用就是高清修复和放大。目前主要有多种方式实现。
使用场景
图像生成模型其实都有一个最佳的图像分辨率。如果我们想要生成的图像分辨率不是最佳分辨率,就会导致生成结果效果不好。
因此我们在进行图像生成的时候,先使用最佳分辨率来生成图像。然后将图像放大到目标分辨率。这样可以提高图像生成的效率。
潜空间放大(二次采样放大)
放大原理
潜空间放大的原理是将原图先编码成潜空间图像数据(Latent),然后放大/缩小潜空间图像数据(Latent),最后将Latent图像进行二次采样,然后解码为正常图像。
这种二次采样的方式就相当于图生图场景中的重绘功能。
核心节点
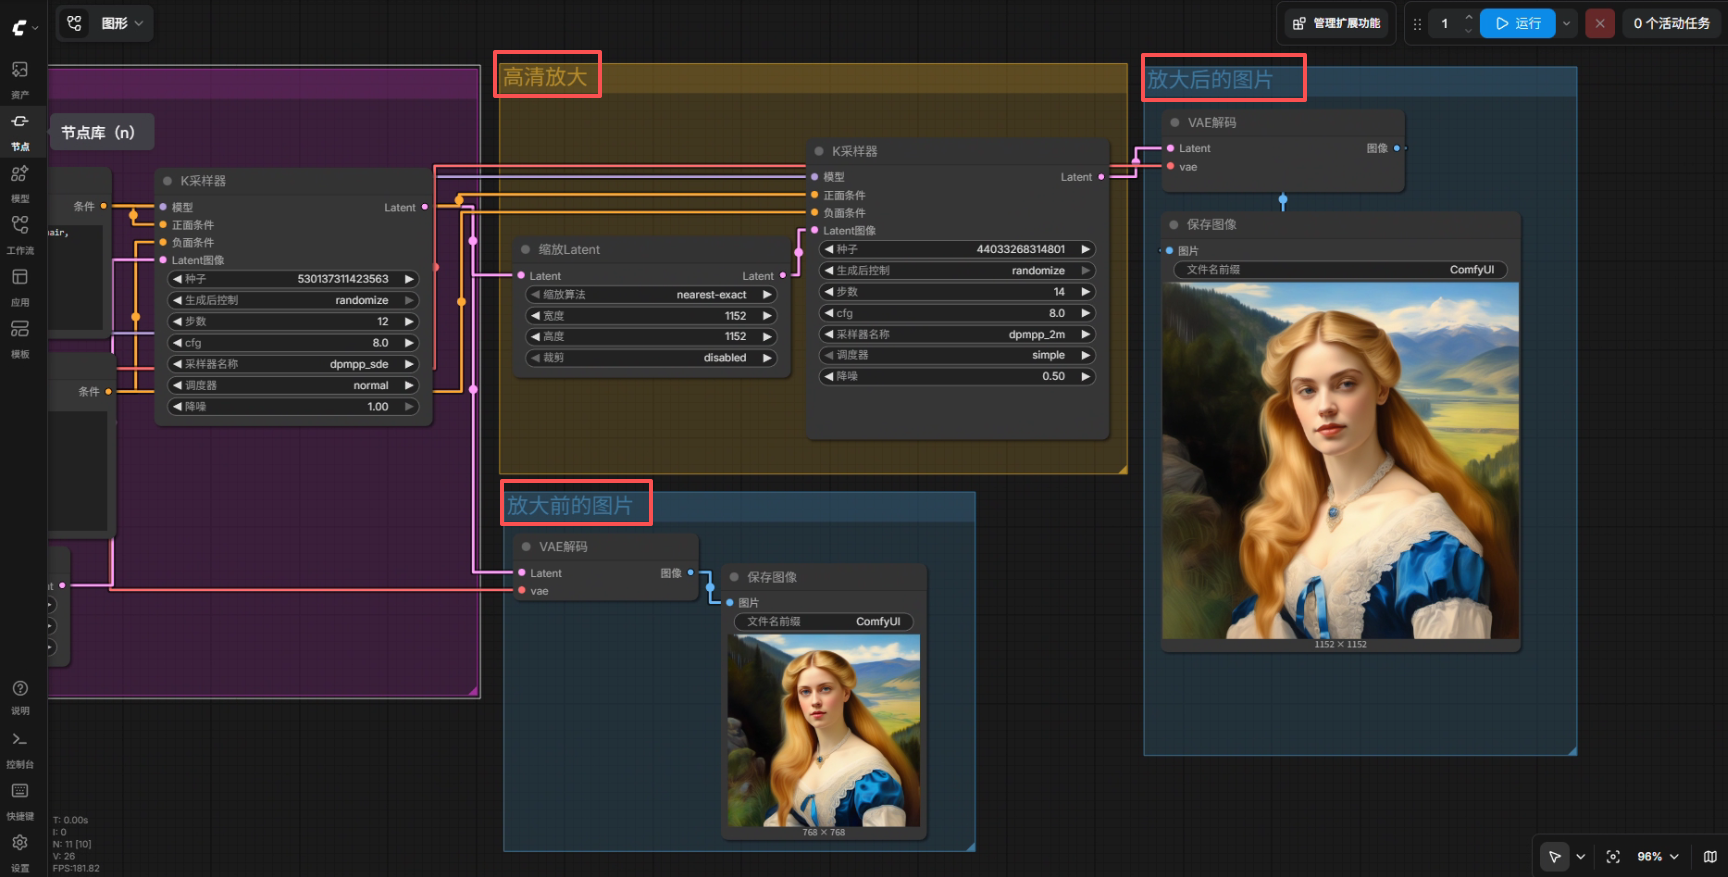
如图所示是在文生图的工作流中,额外添加了缩放Latent图像节点和K采样器节点。图中也有放大前和放大后的图片对比。
注意事项
图中是通过先放大潜空间图像数据(Latent),再进行二次采样重绘的方式,来实现高清放大的效果。这种方式新图会与原图有一定的差异。
如图所示。二次采样的降噪强度参数,会影响放大后图片的相似度。越小越相似,越大越不同。建议最低0.5。 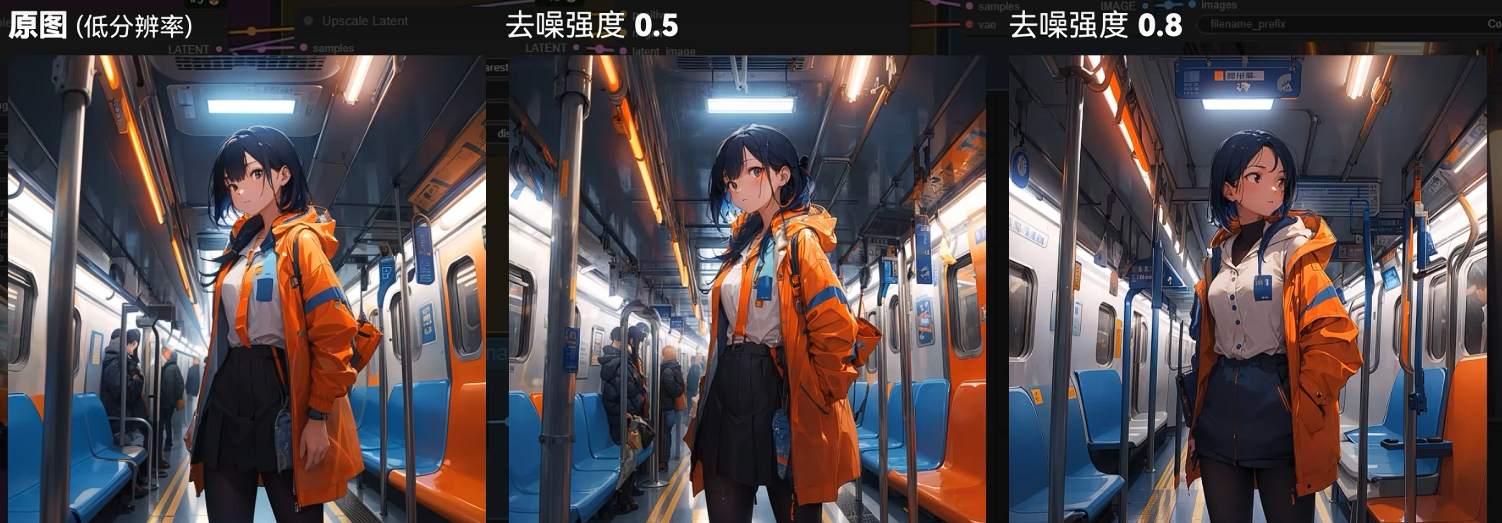
传统放大(放大模型放大)
传统放大是直接通过放大模型来放大原图的尺寸。这种方式的放大效果是直接的,不会改变原图的特征。
如图就是采用放大模型进行图像放大的工作流。 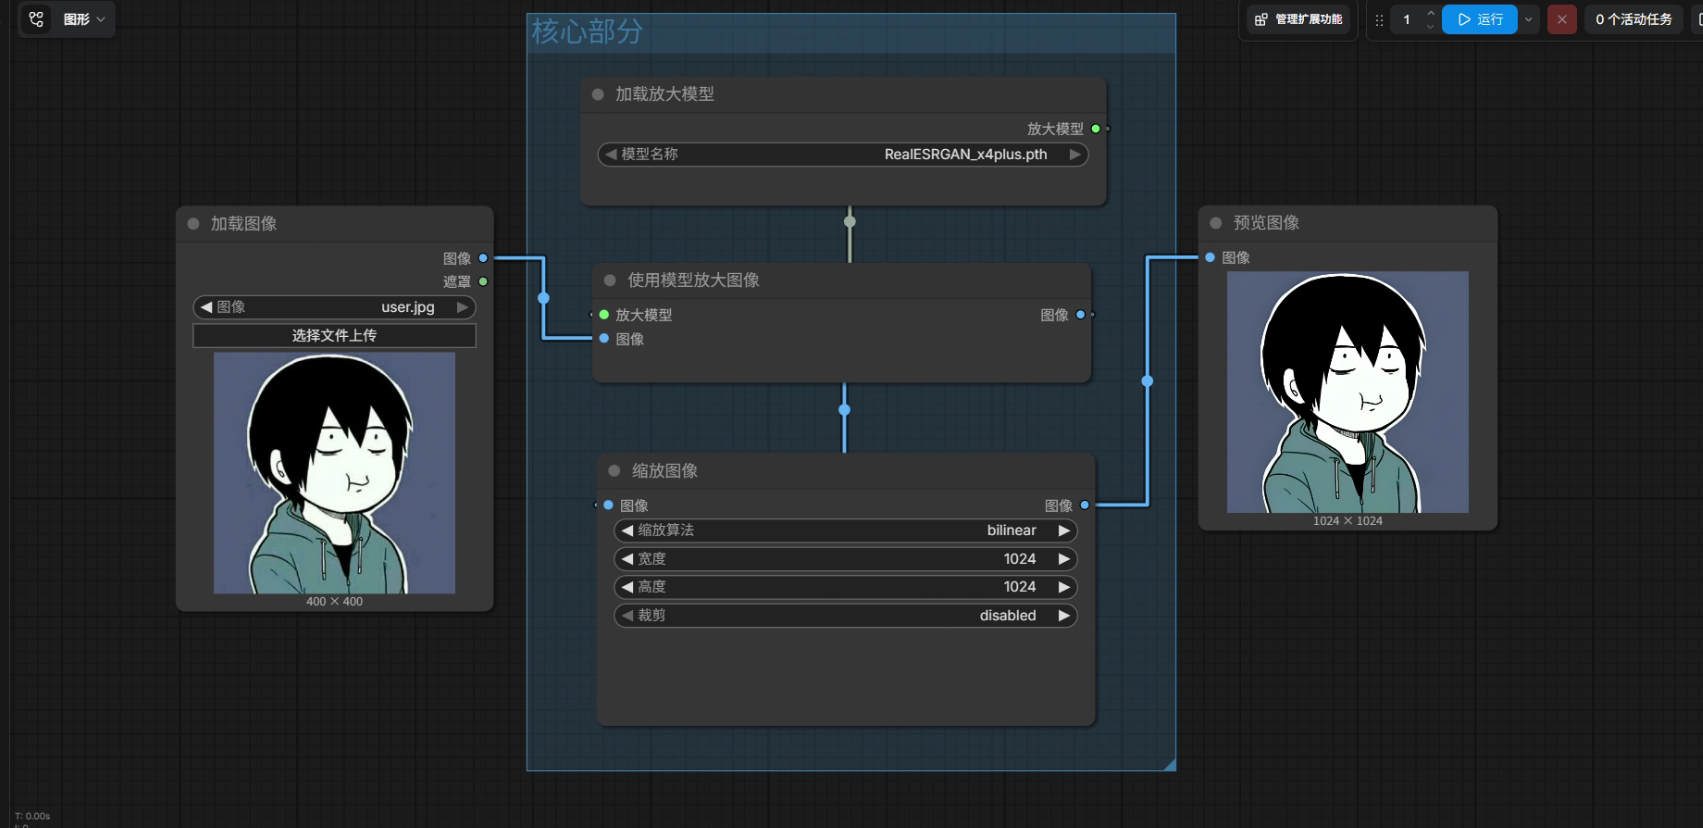
主要涉及的节点有:
- 加载放大模型节点:加载放大模型。
- 使用模型放大图像节点:调用放大模型和原图,输出放大后的图像。
- 缩放图像节点:将图像调整到目标尺寸。
目前比较推荐的传统放大模型是图中的 RealESRGAN_x4plus 模型。
注意:传统放大的缺点就是显存占用比潜空间放大高。图像局部重绘工作流
目前局部重绘有两种方式。
- 方式1:是在原图上添加遮罩区域后,然后对遮罩区域进行图生图,从而达到局部重绘的效果。
- 方式2:是在原图上添加遮罩区域后,再将原图和遮罩区域一起编码成潜空间图像数据(Latent),然后对Latent图像进行二次采样,最后解码为正常图像,从而达到局部重绘的效果。
区别
- 方式1是直接再遮罩区域上进行图生图,因此局部重绘的区域可能会与非遮罩区域有差异。
- 方式2将原图和遮罩区域一起先编码成潜空间图像数据(Latent)然后一起通过二次采样的方式,来实现局部重绘的效果。这样的话局部重绘的区域会与非遮罩区域保持一致。
注意:局部重绘通常需要搭配对应的局部重绘模型。下图工作流中使用的是基于 SDXL模型的局部重绘模型 sd_xl_base_1.0_inpainting_0.1.safetensors
空白区域重绘
如图所示是空白区域重绘的工作流。 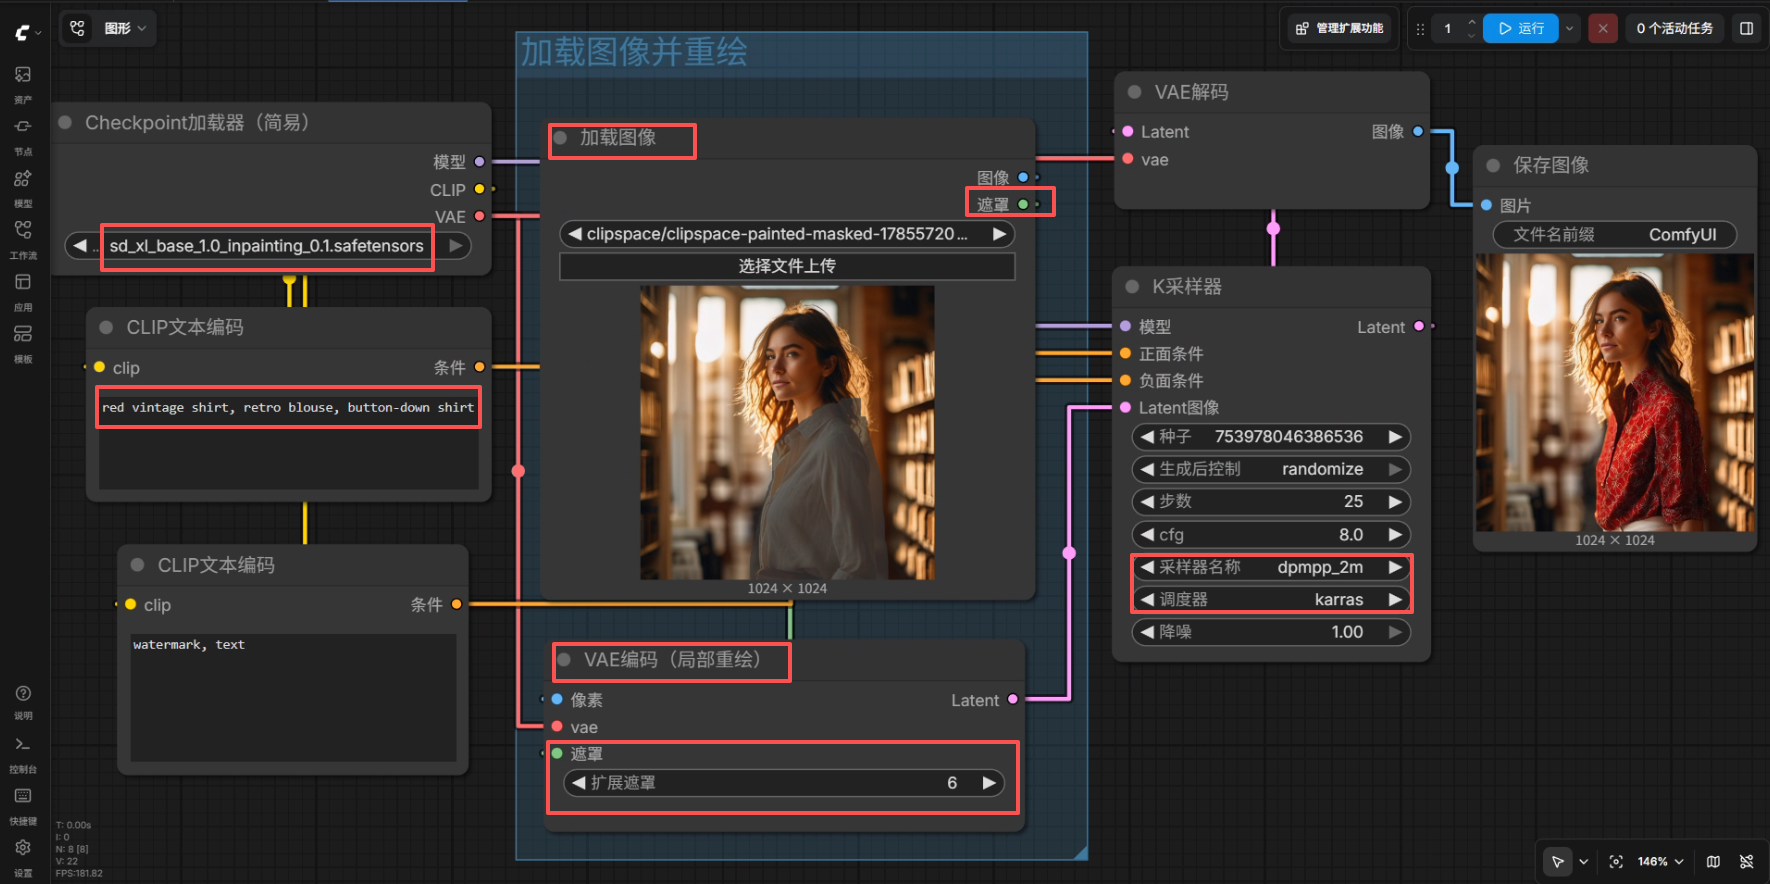
局部重绘原理
主要是先再原图上添加遮罩,然后对遮罩区域进行图生图,从而达到局部重绘的效果。
本质上也算是图生图工作流中的一种特殊情况。
核心节点
局部重绘工作流的核心节点
- 加载图像节点:输出图像数据和遮罩数据。
- VAE编码(局部重绘)节点:可以将添加了遮罩的原图,编码成潜空间图像数据(Latent)。
注意事项
注意:采样器中的denoise降噪强度设置过低,否则将出现重绘后图像蒙版区域为灰白色块情况。
潜空间重绘
如图所示是潜空间重绘的工作流。 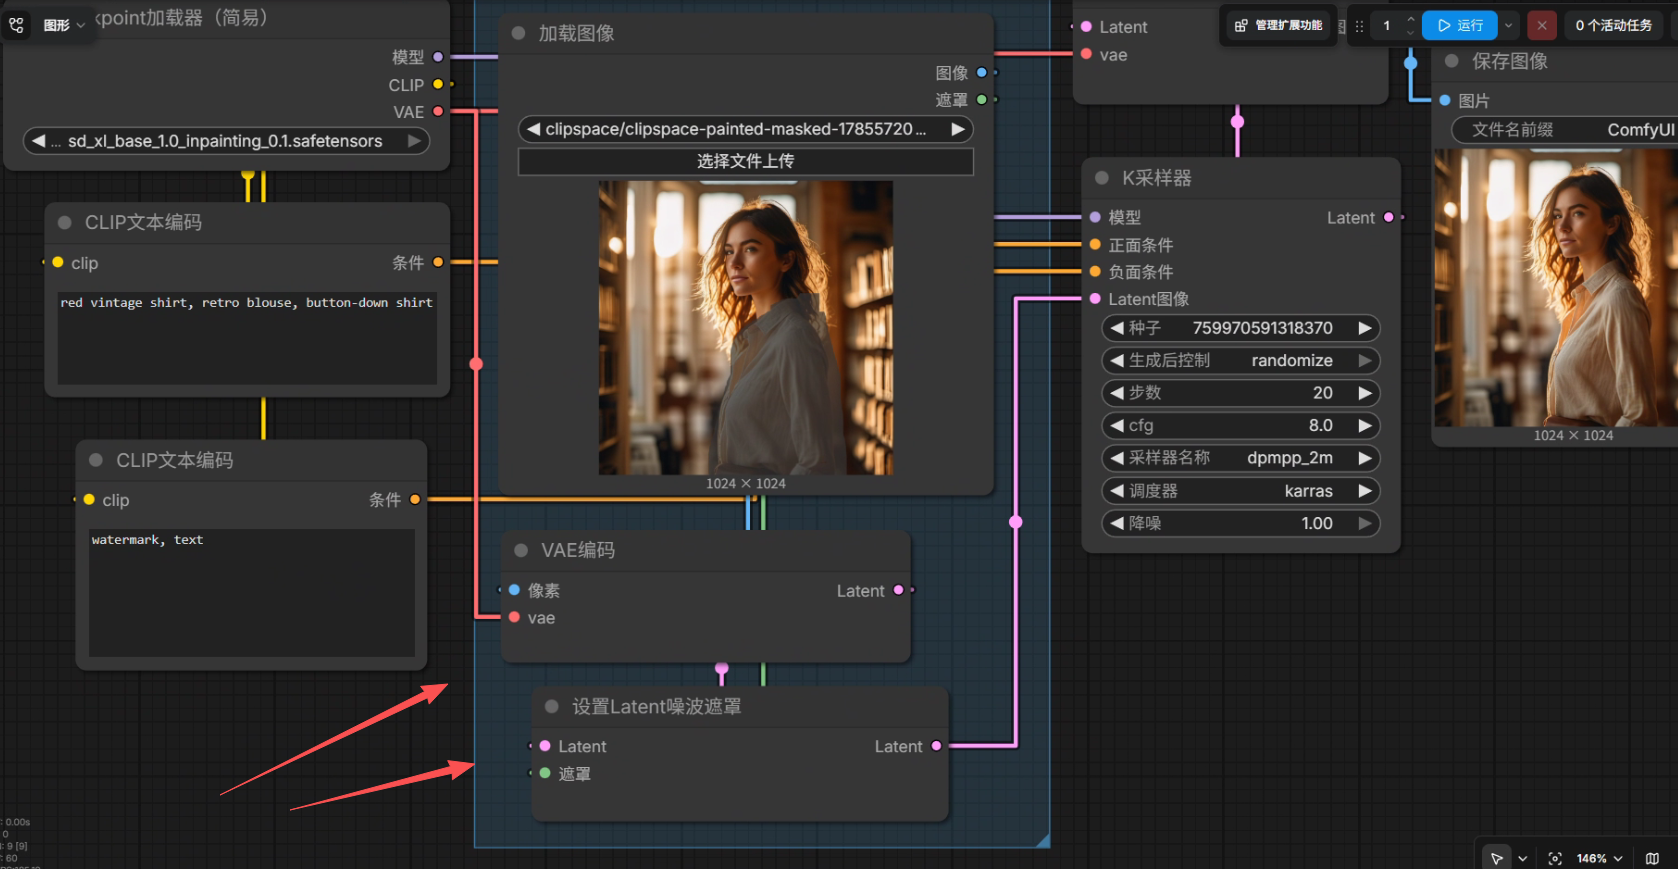
核心节点
相比空白区域重绘,只是将VAE编码(局部重绘)节点替换为下面的节点。
- 加载图像节点:输出图像数据和遮罩数据。
- VAE编码节点:将原图编码成潜空间图像数据(Latent)。
- 设置Latent噪波遮罩节点:将Latent图像数据(Latent)和遮罩数据进行合并,生成新的Latent图像数据(Latent)。
注意事项
空白区域重绘由于是对遮罩区域进行图生图,因此如果降噪强度数值较低,那么重绘后的区域可能会与非遮罩区域有差异。
相比空白区域重绘,潜空间重绘可以再降噪强度数值较低的情况下使用,从而实现局部重绘的效果。
embedding 附加工作流
embedding 模型的作用
embedding 模型本质也是提示词,只不过像“打包的提示词”一样。通过引入embedding模型,我们可以快速地调用预定义好的提示词,从而实现快速赋予生成作品特定的角色特征或风格。
例如只需调用角色 Embedding,就能轻松复现动漫人物形象,或通过风格 Embedding 为画面套用水晶雕塑、涂色书等独特质感。
提前准备
准备①:在使用embedding模型的时候,建议先安装一个自定义节点包。该自定义节点是由作者 pythongosssss 开发的 ComfyUI-Custom-Scripts(界面交互增强脚本)。用于提升ComfyUI的界面交互体验(自动排版节点、大图预览、历史记录、快捷键)。
如图所示。该自定义节点包可以帮我进行embedding模型的提示调用。 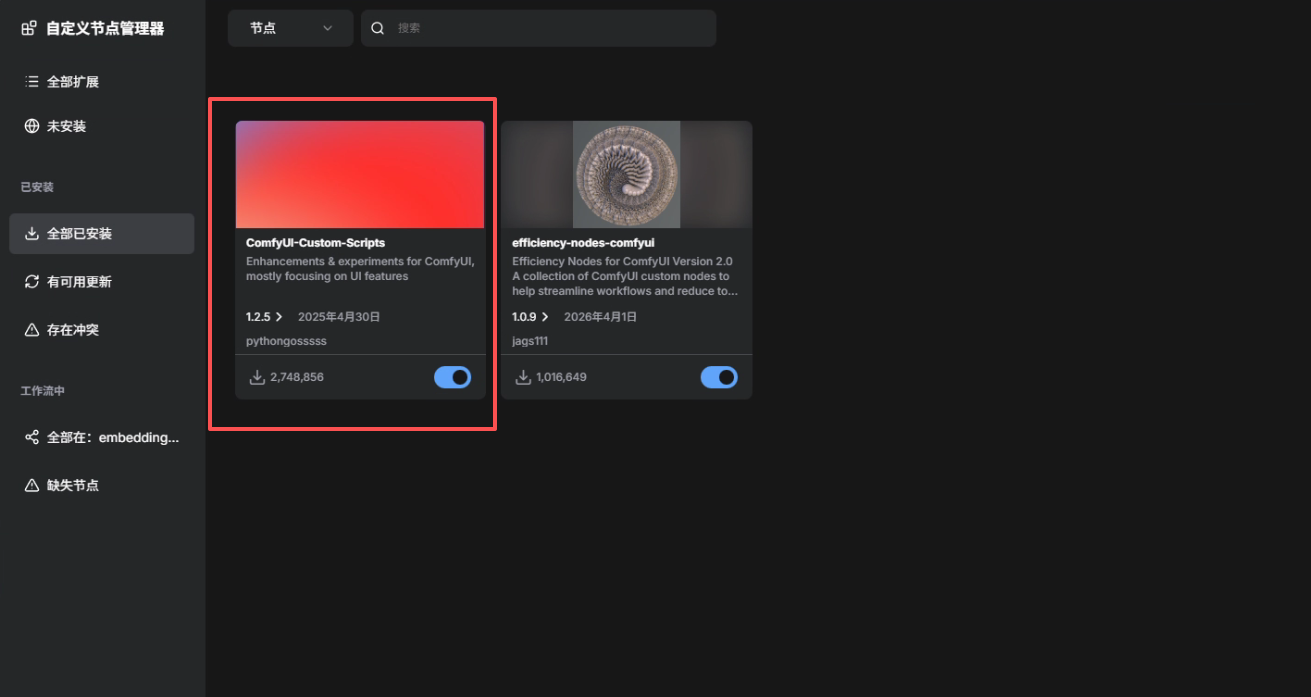
准备②:下载embedding模型。并添加到comfyui的"models/embeddings"目录下。
如图所示 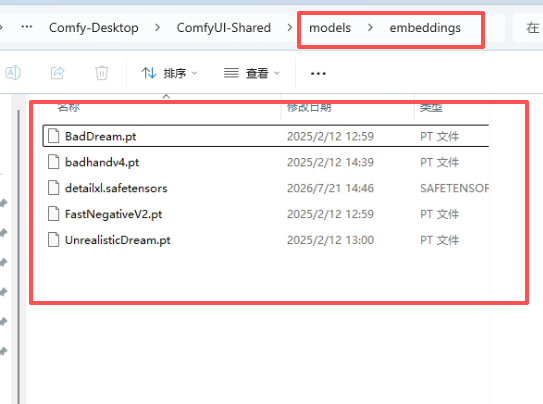
使用embedding模型
当安装好ComfyUI-Custom-Scripts 节点包和下载好embedding模型后,就可以使用embedding模型了。
直接在文本编码器节点中,按照 ”embedding:模型名称“ 格式添加到正面/负面提示词中即可。
如图所示 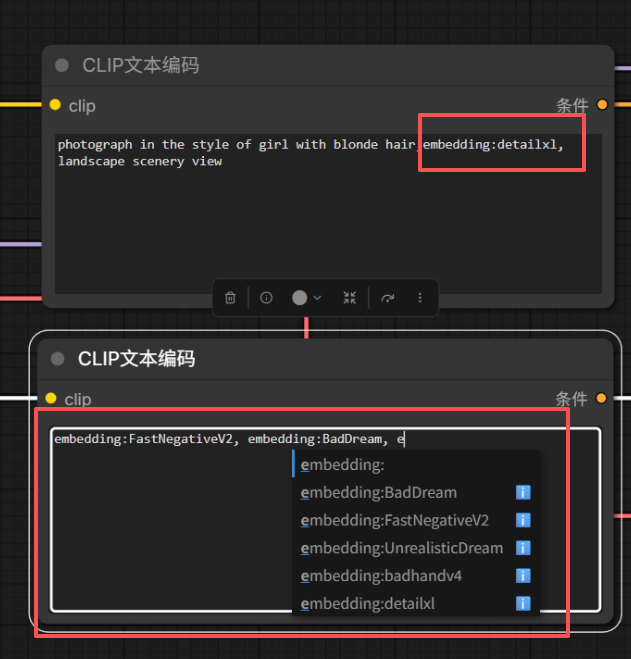
如图可以看到,当安装了ComfyUI-Custom-Scripts 节点包后,就可以在文本编辑器节点中,快捷使用embedding模型了。
Lora 附加工作流
Lora 模型的作用
Lora模型是完全基于模型本体的一小部分模型参数进行训练的微调产物。因此Lora模型不可以独立运行,只能搭配对应的模型本体一起使用。
Lora 模型就像给模型本体 定制了一个扩展包。通过将LoRA模型与模型本体 搭配使用,通过权重调节控制作用强弱,既能固定角色与 IP 形象,也能迁移特定画风,或植入发型、服饰等概念元素。
加速类Lora模型的命名
通常情况下,加速类的Lora模型,在命名上会包含:lighting,turbo,light等字样,以及推荐采样步数的数字。例如:qwen-image-edit-2509-lightning-4steps-v1.0-bf16.safetensors。 这个就是qwen的加速lora模型,推荐采样步数为4步。
提前准备
需要先下载模型本体对应的Lora模型。并添加到comfyui的"models/loras"目录下。
如图所示 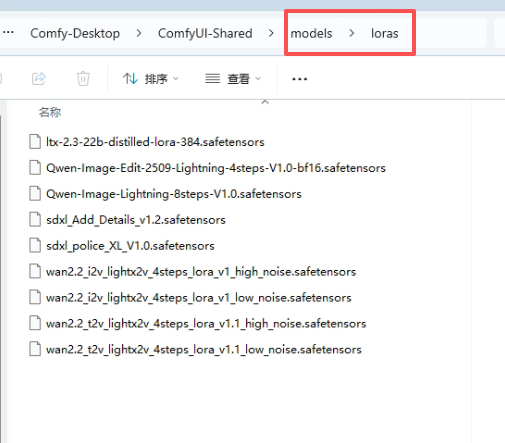
使用Lora模型
需要通过Lora加载器节点,将Lora模型加载到工作流中。若需要使用多个Lora模型,可以通过串联的方式,将多个Lora模型加载到工作流中。
如图所示 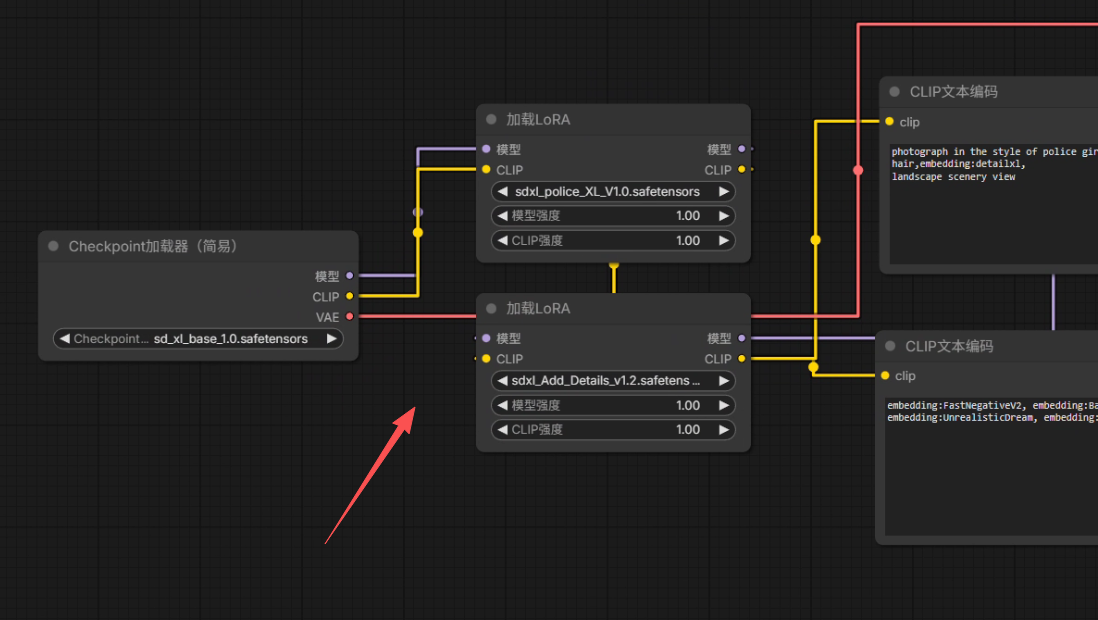
Lora 加速工作流 + CFG 归一化节点
Lora模型还能加速图像生成。
例如,当我们想要提高工作流的生成速度时,可以在工作流中添加 加速类Lora模型 和 CFG 归一化节点。就可以让工作流相比原来情况下,更快速生成图片。
加速类Lora模型的命名
通常情况下,加速类的Lora模型,在命名上会包含:lighting,turbo,light等字样,以及推荐采样步数的数字。
例如:qwen-image-edit-2509-lightning-4steps-v1.0-bf16.safetensors。 这个就是qwen的加速lora模型,推荐采样步数为4步。
Lora 加速工作流的本质
通过Lora模型,给工作流进行加速。只是众多加速手段中的一种,属于「算法级加速」,有微小画质损失;
Lora 加速工作流的本质是通过Lora模型,把原本需要 20~30 步才能完成的图像去噪过程,压缩到 2~8 步完成。由于步数减少,所以生成时间也会减少。 因此显得工作流加速了一样。
Lora 加速工作流的使用场景
由于Lora加速工作流会导致画质损失。
推荐使用的场景(收益远大于画质损失的场景)
- 草图预览、工作流搭建阶段
- 批量产出、图片低精度需求场景下。 例如 封面、海报、海量素材初稿筛选,对单图细节要求不高。
- 低显存显卡设备的情况。 Lora加速工作流 配合 量化模型,可以在低画质下流畅出图。
不推荐的场景(收益远小于画质损失的场景)
- 商用稿、印刷级高精度出图
- 极致还原原图的图生图的场景: 需要严格保留原图光影、结构,加速 LoRA 可能引入轻微偏移。
使用 Lora 加速工作流
当我们在工作流中使用加速Lora模型的时候,加载Lora模型节点需要在模型节点的后面。
即“模型节点 -> Lora模型节点--> 其他节点”。
另外,还需要修改采样器的采样步数和CFG值。
- 核心原则:采样器的采样步数必须严格匹配加速 LoRA 的推荐采样步数,宁少勿多。
- 调低采样器的CFG值。
为什么要将采样器的采样部署修改为加速 LoRA 的推荐采样步数?
这是因为加速类LoRA模型 是针对推荐采样步数蒸馏训练的,超出推荐采样步数过多会出现「过采样的情况」,使得最终画质反而不如少步结果。
- 采样器的采样步数远高于推荐采样步数(例如使用 4 步加速Lora模型,但采样步数设置20 步):会导致图像过度去噪,细节被磨平、五官塑料感、色彩发灰发死;
- 采样器的采样步数远低于推荐采样步数:去噪不充分,画面模糊、满是噪点、主体轮廓不清晰。
因此只有采样步数设置在加速类Lora模型的推荐采样步数范围内,才能同时拿到加速收益和合格的画面质量。
主流加速 LoRA 标准参照表
| 加速 LoRA 类型 | 推荐采样步数 | 推荐 CFG 值 | 建议匹配采样器 | 整体提速 |
|---|---|---|---|---|
| Lightning LoRA(画质最优) | 4 步(极速预览)6~8 步(平衡画质) | 2.0 ~ 3.5 | DPM++ 2M Karras | 3~6 倍 |
| LCM LoRA(速度最快) | 2~4 步 | 1.0 ~ 2.5 | LCM 专用采样器 | 5~8 倍 |
| Turbo LoRA(极致秒出) | 1~2 步 | 1.0 ~ 2.0 | Euler a | 8~10 倍 |
注意事项
- 每多叠加 1 个普通LoRA,采样器的CFG 需要上调 0.3~0.5,保证 LoRA 特征正常生效;
- 图生图低重绘幅度场景,CFG 下调 0.3~0.5,避免破坏原图结构;
使用 CFG 归一化节点的场景
CFG 归一化不是加速工作流的必需组件,它解决的是 「高 CFG + 低采样步数」组合带来的数值不稳定问题 。你的工作流中越容易触发这个问题,使用CFG归一化的收益就越大;反之则可以不使用。
通俗解释
如果把 CFG 引导比作开车打方向:
- 多步采样 = 慢慢开,小幅度多次打方向,车很稳;
- 少步加速 = 高速急打方向,很容易失控跑偏;
- CFG 归一化 = 车身稳定系统,不改变你打方向的意图,只把过度的拉扯修正到安全范围,让车高速也能走直线。
建议使用 CFG 归一化节点的场景
加速 LoRA 模型的推荐采样步数 ≤ 8 步的情况 由于加速 LoRA 模型的推荐采样步数 ≤ 8 步,采样步数越少,数值不稳定问题越容易触发。因此,建议使用 CFG 归一化节点。
使用 FP8 量化模型的情况 FP8 量化模型 浮点精度低、容错空间小,因此建议使用 CFG 归一化节点。
叠加 2 个及以上普通 LoRA,且 CFG≥3的情况 多 LoRA 会放大条件向量的数值偏差,容易出现色彩漂移、画面失控的情况。因此建议使用 CFG 归一化节点。
图生图 / 局部编辑场景的情况 归一化能稳定引导强度,避免局部修改时颜色溢出、原图结构变形,保证编辑区域和原图的光影融合。
批量生产、需要结果可复现的情况 开启归一化后,不同种子、不同批次的画面色彩、对比度高度统一,不会出现一张亮一张暗的情况。
不建议使用 CFG 归一化节点的场景
常规采样≥20 步的情况 多步采样每步修正幅度小,数值本身稳定,归一化收益极低,感知不到差别。
采样器本身就是低CFG的情况。
纯艺术风格创作,追求高饱和强对比的情况 归一化会轻微压缩色彩动态范围,追求艳丽夸张风格时可以关闭。
总结
若采样器的设置是 低采样步数 + 高 CFG 值 的情况下,可以使用 CFG 归一化节点。这种情况下,归一化的收益高。其他情况下,可用可不用。
使用示例
以下是各个测试示例。
使用的模型文件
- CLIP 文本模型:qwen_2.5_vl_7b_fp8_scaled.safetensors
- UNet 扩散模型:qwen_image_edit_2509_fp8_e4m3fn.safetensor
- VAE编码解码模型:qwen_image_vae.safetensors 专属的VAE模型,只能用于Qwen-Image模型。
- lora 模型(可选使用):qwen-image-edit-2509-lightning-4steps-v1.0-bf16.safetensors,用于加速图像生成。
加速Lora模型,通常命名包含:lighting,turbo,light等字样。例如上面这个就是qwen的加速lora模型,推荐采样步数为4步。
示例展示
示例1:如图是不使用加速Lora模型时,采样器设置(采样步数为20步,CFG值为8)。生成这样一张图片耗时330秒。 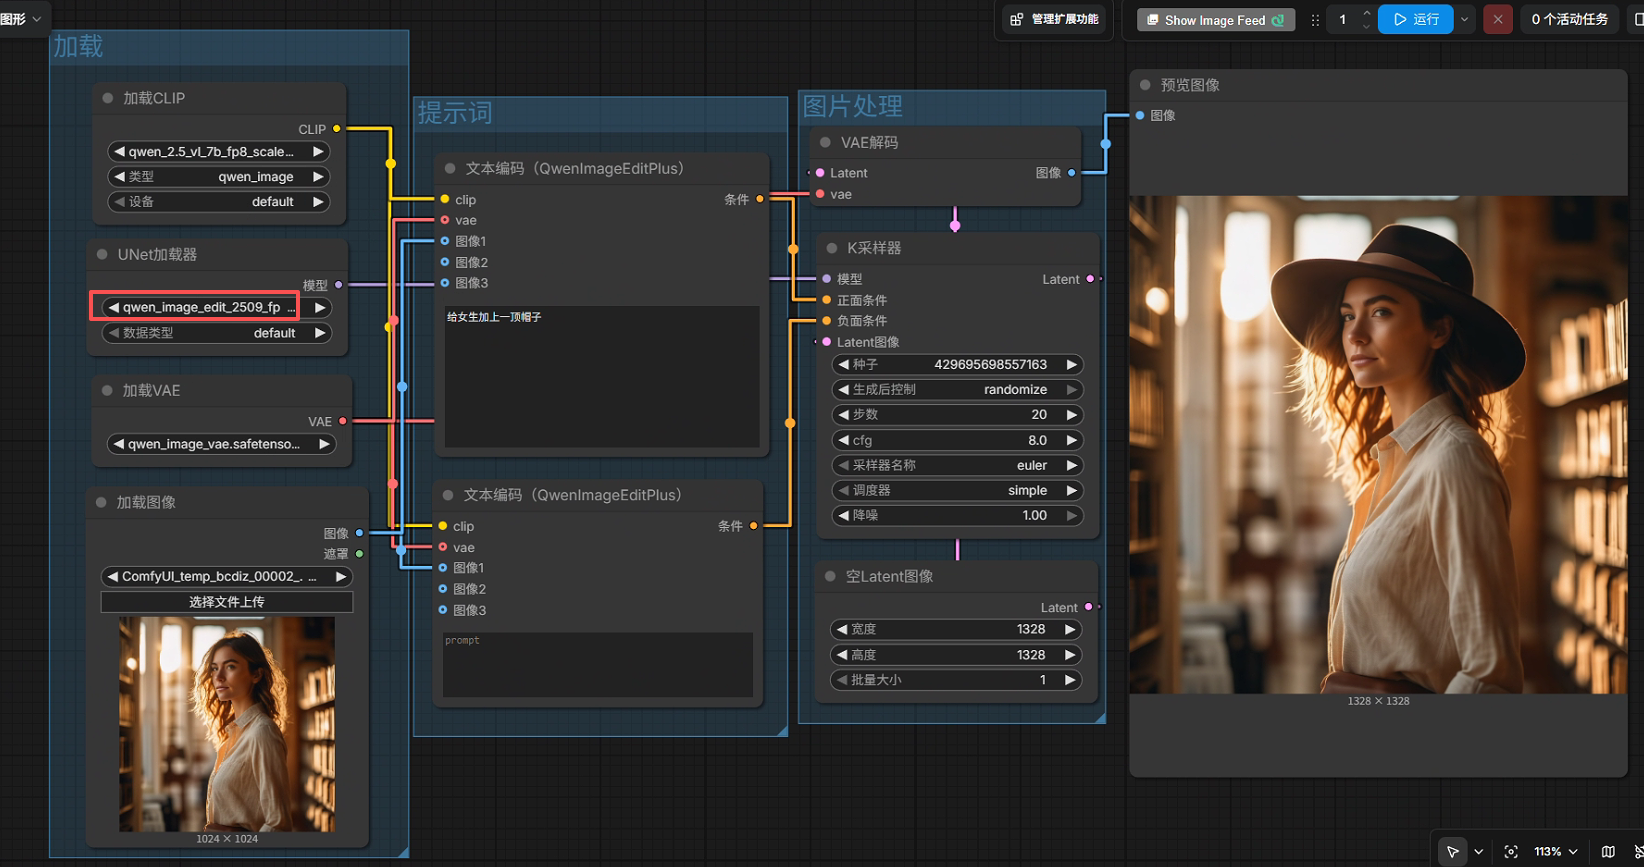
示例2:如图是使用了Lora加速模型,不改采样器设置的情况。采样器设置(采样步数为20步,CFG值为8)。一共耗时290秒。虽然生成时间缩短了10%,但是图片颜色过深。 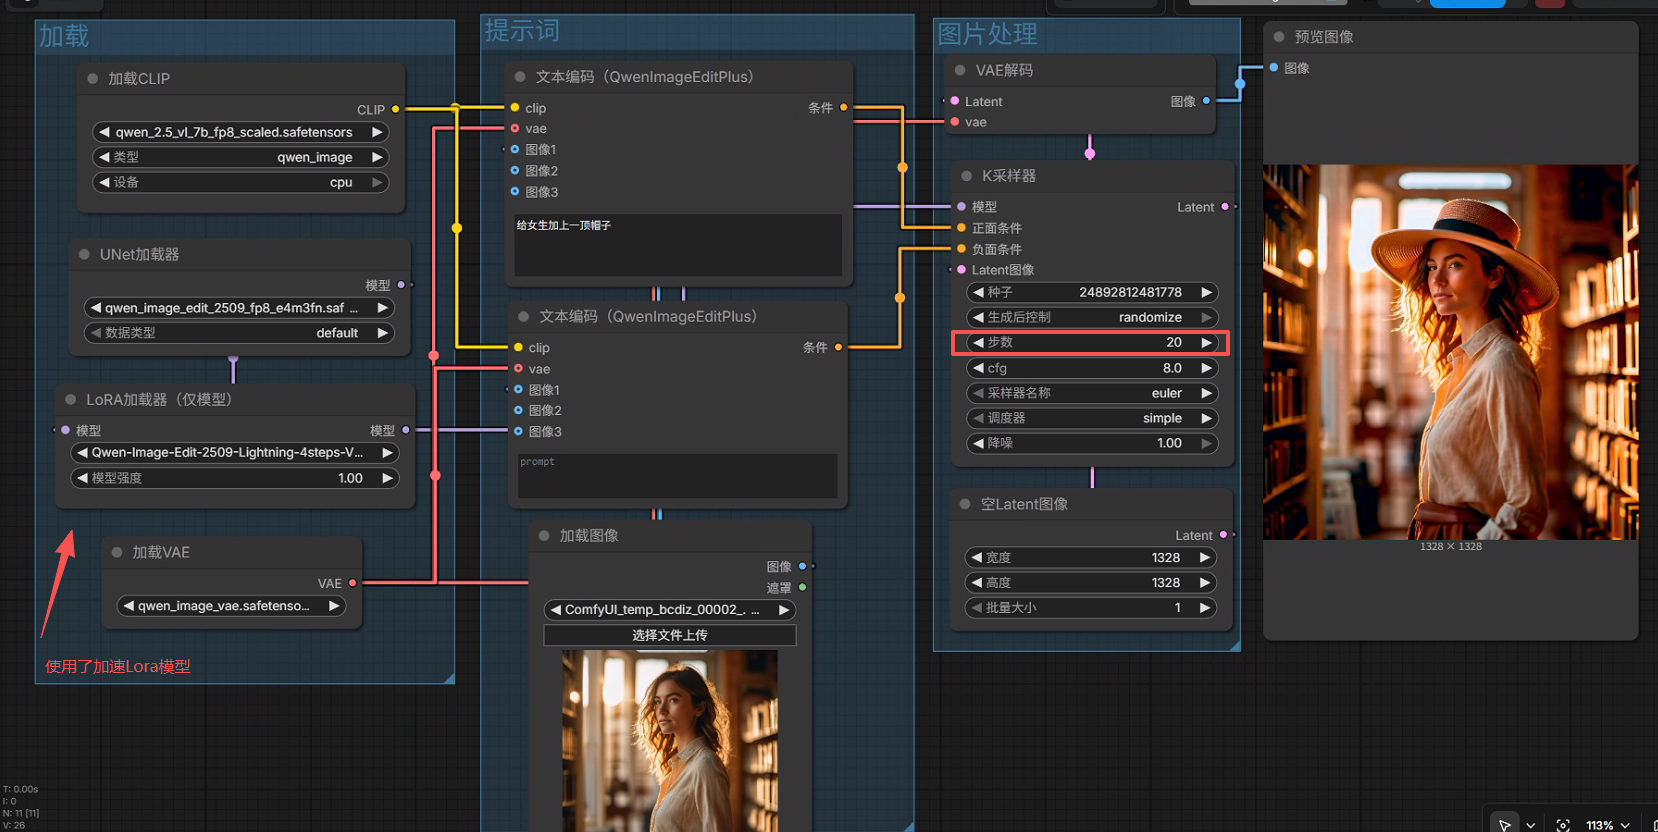
示例3:如图是使用了Lora加速模型,修改采样步数的情况。采样器设置(采样步数为4步,CFG值为8)。一共耗时55秒。虽然极大加速了,生成时间缩短了80%,但是生成的图片完全不能用。 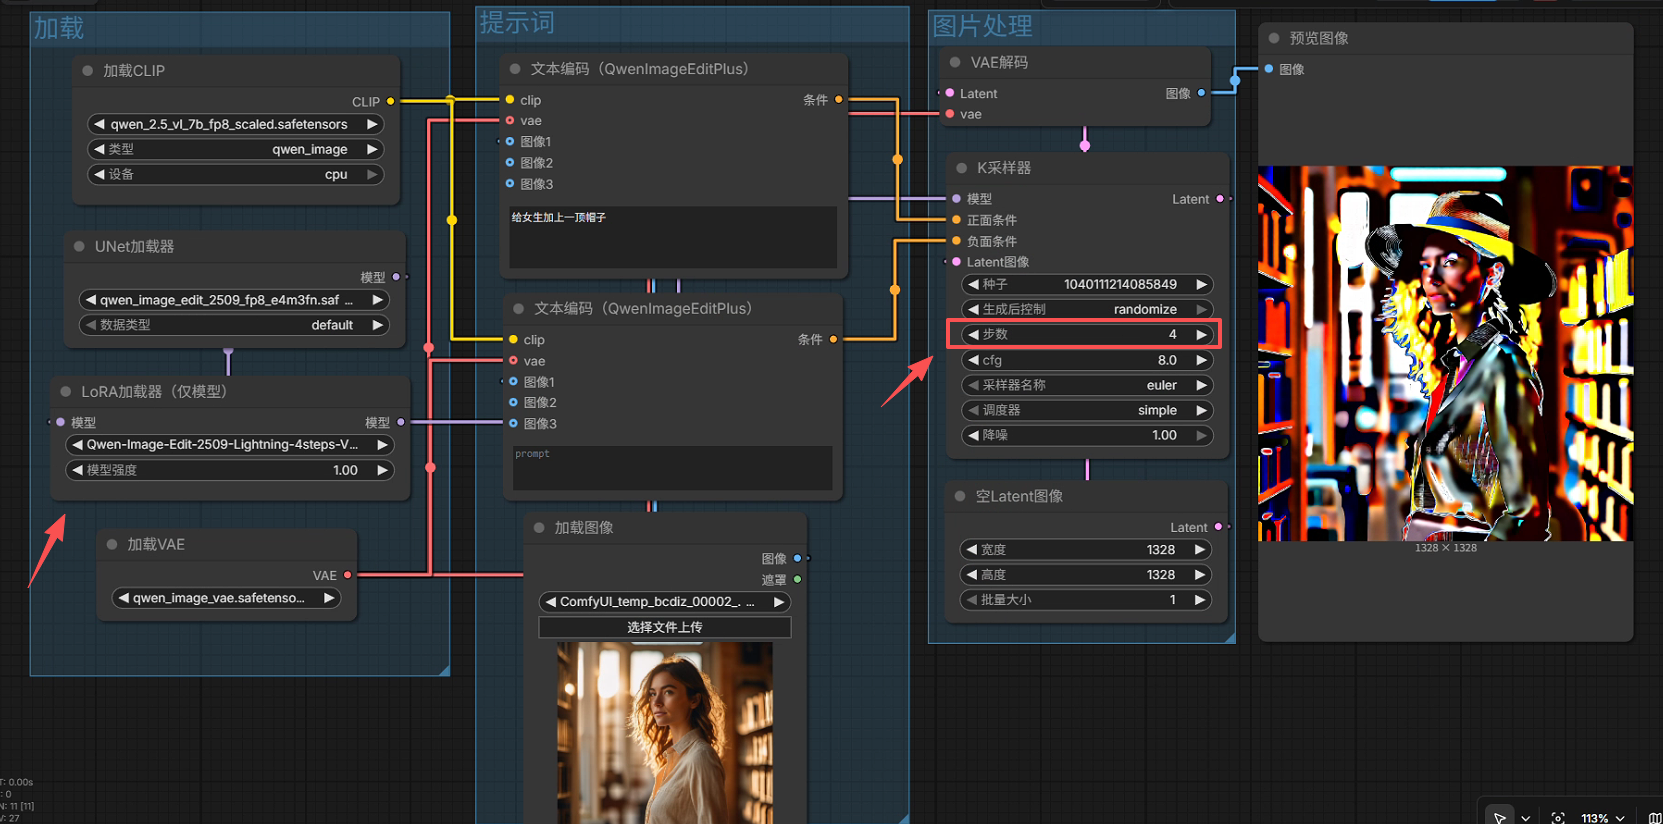
示例4:如图是使用了Lora加速模型,修改采样步数和CFG值的情况。采样器设置(采样步数为4步,CFG值为2)。一共耗时130秒。生成时间缩短了60%,并且图片质量也可以用。 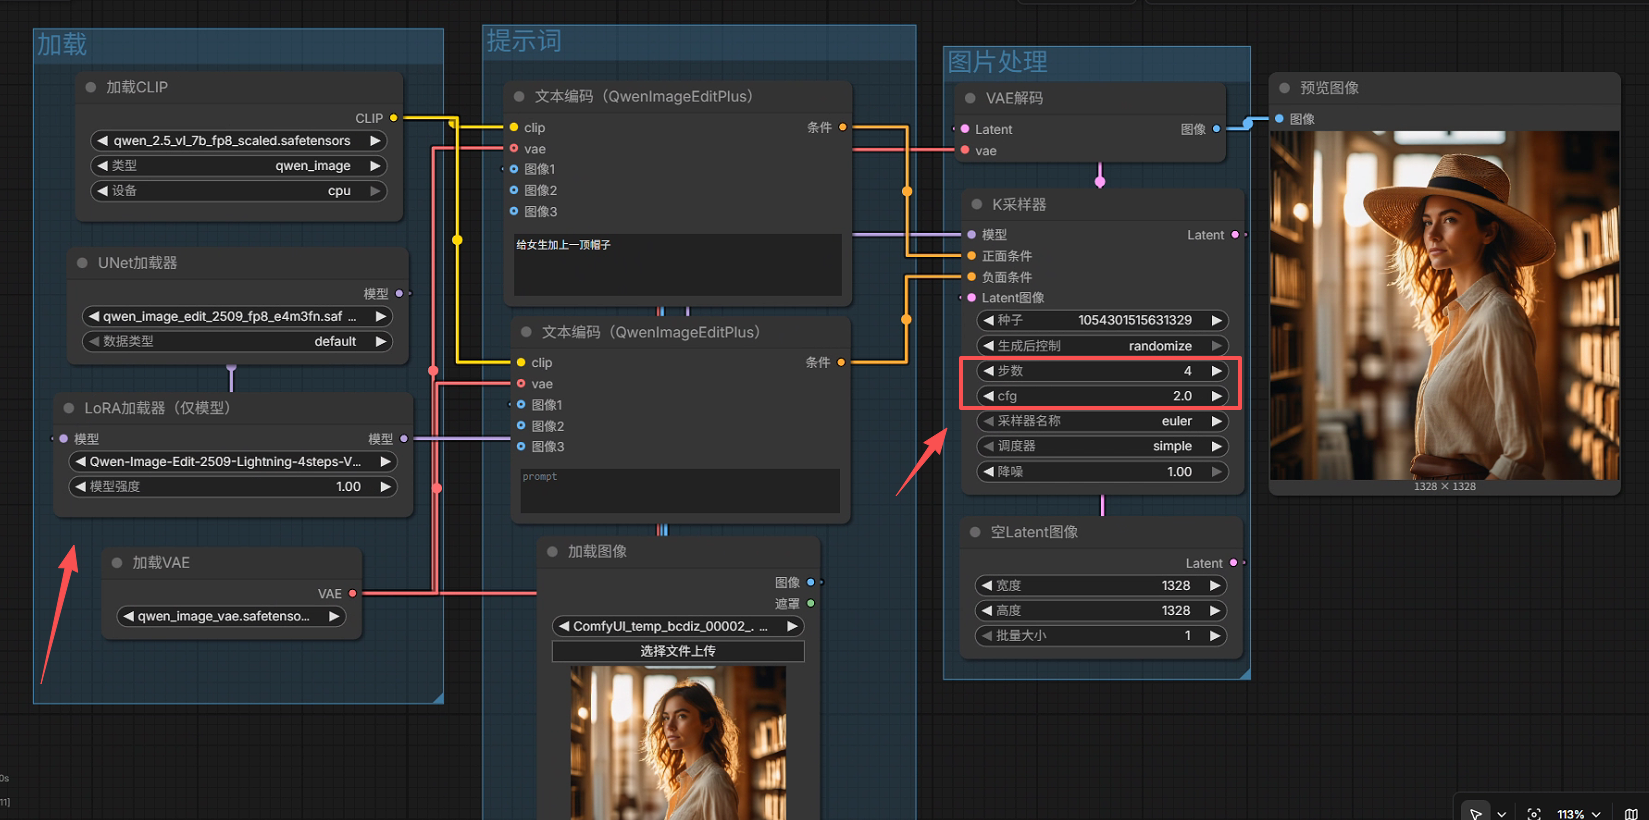
示例5:如图是使用了Lora加速模型 + CFG 归一化节点后,采样器设置(采样步数为4步,CFG值为2)。一共耗时58秒。生成时间缩短了80%,生成的图片质量是可以用的。 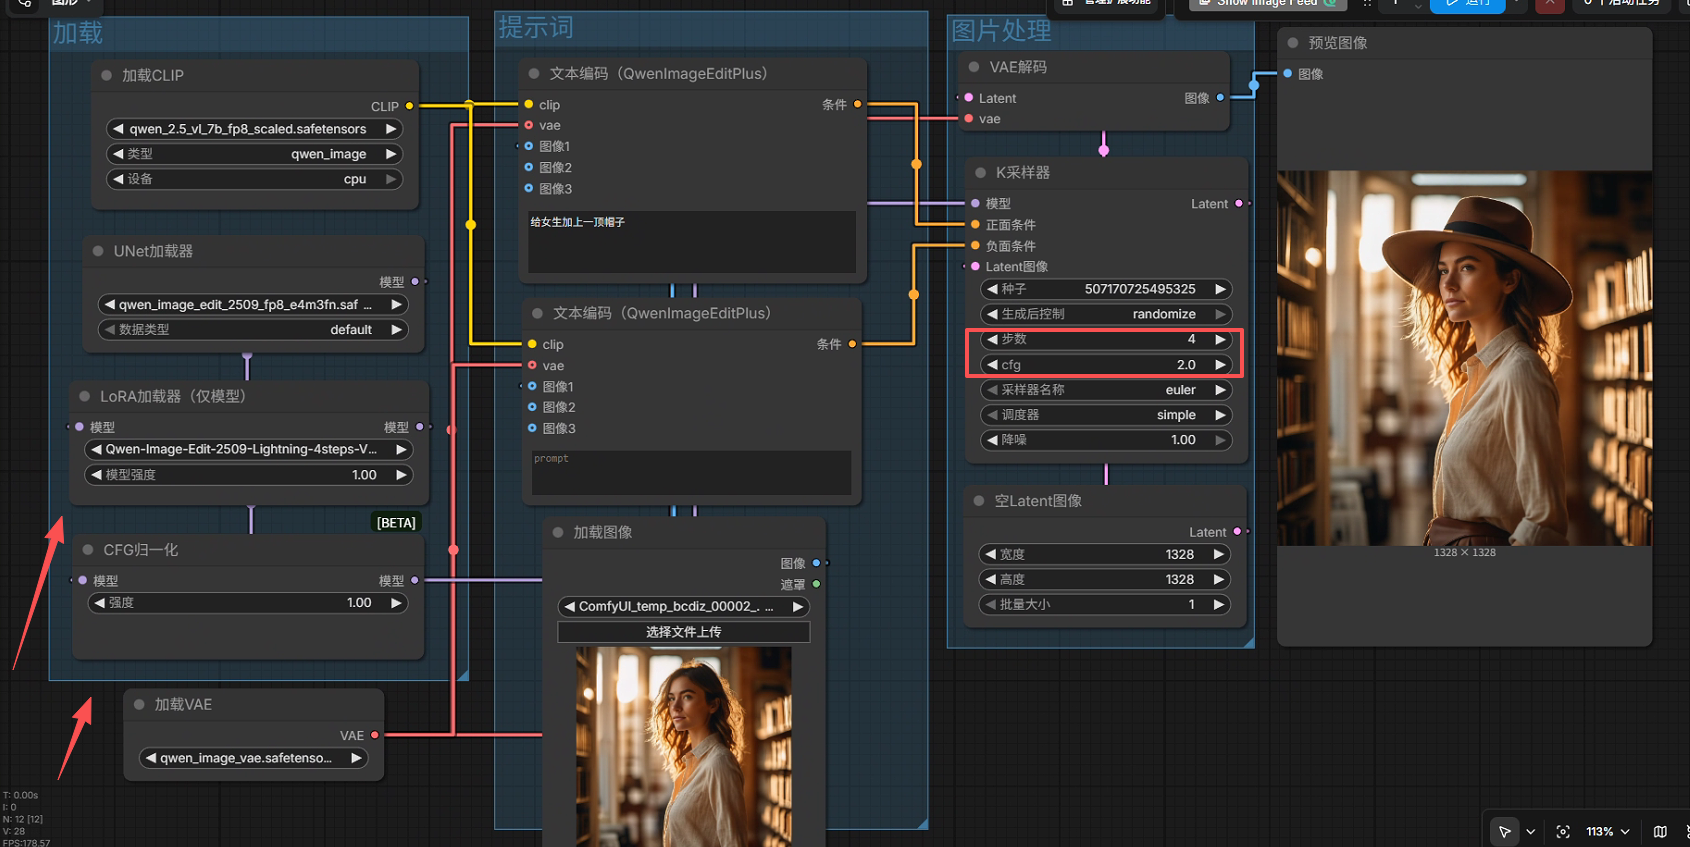
总结:目前上面示例中,只有两种情况下,才能同时拿到加速收益和合格的画面质量。
- 示例4:使用加速Lora模型,修改采样器步数和CFG值。生成时间缩短60%。
- 示例5:使用加速Lora模型 + CFG 归一化节点,修改采样器步数和CFG值。生成时间缩短80%。最优的情况。
其他情况中:
- 示例2:虽然生成时间缩短了10%,但是图片质量不是很好。不划算。
- 示例3:虽然生成时间缩短了80%,但是生成的图片完全不能用。不划算。
总结
根据上面的示例可以总结如下:
当工作流需要加速的时候,如果想要获得最佳的加速效果,那么建议使用加速类的Lora模型 + CFG 归一化节点。并且需要修改采样器中的采样步数和CFG值。那么生成图片的速度相比原来情况,生成时间直接缩短 60%~90%。
其中采样器的采样步数设置为加速类Lora模型的推荐采样步数。采样器的CFG值需要调低,推荐设置为 1~3 之间。
ControlNet 附加工作流
ControlNet 介绍
一般情况下,通过图像生成模型生成的图像,会根据文字提示词,自由发挥,人物姿势、物体轮廓很容易画崩、变形。就算是通过图生图的方式,也与原图有很大的差异。
而 ControlNet 就像一根 “定形支架”,强制让图像生成模型 严格按照你给的图片轮廓、姿势、结构去画,不让它乱变形。
如图所示,先将原图通过预处理器,生成控制图。再将控制图通过ControlNet模型,生成图像。 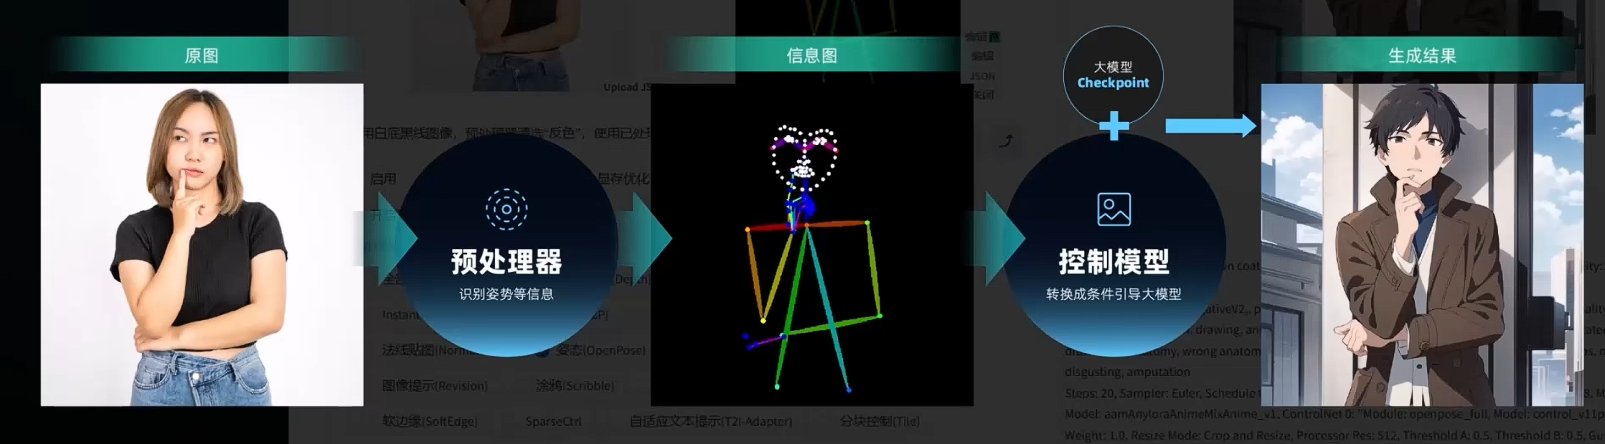
注意:ControlNet模型必须配合对应架构的基础模型协同工作。
如何使用ControlNet模型?
ComfyUI 原生提供了 ControlNet 模型的加载、应用、调度的全套节点,覆盖扩散采样阶段的全部控制逻辑,无需安装任何第三方插件即可使用。
具体节点参考上面内容。
预处理器(ComfyUI controlnet aux 第三方节点包)
ComfyUI 官方只维护核心节点(加载、编码、采样、解码),没有内置「预处理器节点」。关于预处理器节点目前是由社区插件生态维护的。
如何使用预处理器节点?
我们需要再ComfyUI的第三方节点包库中,下载预处理器节点包。目前推荐的预处理器节点包有 ComfyUI controlnet aux 节点包。
comfyui_controlnet_aux节点包 是 ComfyUI 生态中最主流、功能最全的第三方 ControlNet 预处理器节点包,由社区开发者 Fannovel16 维护,是绝大多数 ControlNet 工作流的标配组件。
核心优势:
- 全类型覆盖:集成了几乎所有主流 ControlNet 对应的预处理器
- 多架构兼容:同时适配主流模型架构,参数内置对应优化。
- xinsir 专属适配优化:针对 xinsir 系列模型做了专属坐标适配(scale_stick 开关),是使用 xinsir 模型的官方推荐配套节点。
预处理器(Preprocessor) 和 ControlNet 模型的关系
各自的作用
预处理器 和 ControlNet 模型是在工作流中起到完全不同的作用。
- 预处理器:主要从原图中提取结构化信息,生成控制图。是在采样器之前的一个步骤。例如 DWPose 预处理器可以将原图中的姿态信息提取出来,生成姿态控制图。
- ControlNet 模型:通过读取控制图,在每一步采样中,保证新图的构图/姿态/轮廓不跑偏。
如图所示,先将原图通过预处理器,生成控制图。再将控制图通过ControlNet模型,生成图像。
注意:是先通过预处理器生成控制图,再通过ControlNet模型生成图像。两者是互相搭配的。
注意事项
由于 ControlNet 模型是针对特定类型的控制图训练而成的,因此在使用时需要注意控制图的类型。
- 例如,Canny ControlNet模型 只认识边缘线控制图,喂给它骨骼图就会完全失效
- OpenPose ControlNet模型 只认识关节骨架控制图,喂给它深度图就会生成混乱结果
另外注意:不同基础模型对应的ControlNet模型,也不能混用搭配使用。例如 SDXL模型对应 的 ControlNet模型 只能用于 SDXL模型, 不可混用。
ControlNet 模型与基础模型的组合
SDXL 模型
目前对于sdxl模型,推荐搭配使用xinsir_controlnet-union-sdxl-1.0模型。
xinsir_controlnet-union-sdxl-1.0是多合一的ControlNet模型。它包含了 openpose、canny、depth等多个功能。
下载地址:https://huggingface.co/xinsir/controlnet-union-sdxl-1.0
pose 姿态控制
pose 姿态控制,它能够根据原图,生成对应姿势检测图像。
Pose 预处理器节点
如图所示,OpenPose Pose 预处理器节点是来自 comfyui_controlnet_aux 自定义节点包中的节点。节点上还有节点包名称的标签。
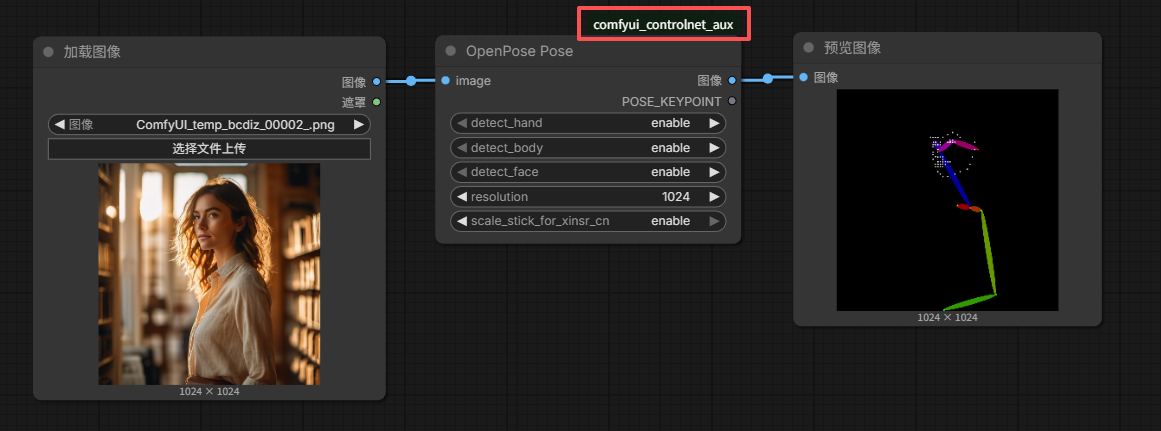
OpenPose Pose预处理器节点的作用是将原图中的姿态信息提取出来,生成姿态控制图。
输入输出
- 输入:原图
- detect_hand: 是否检测手部。
- detect_face: 是否检测人脸。
- detect_body: 是否检测人体。
- resolution: 输出的分辨率。
- scale_stick_for_xinsr_cn: 针对 xinsir 系列模型做了专属坐标适配(scale_stick 开关)。
- 输出:姿态控制图
注意事项
该节点由于内置了scale_stick_for_xinsr_cn 开关。当使用xinsir系列模型时,需要开启该开关。否则会导致效果异常。非xinsir系列模型,不需要开启该开关。
注意:由于使用了第三方节点包,因此在使用第三方预处理器节点时,可能会从外网下载一些脚本文件,节点才能正常运行。请确保你的网络环境允许下载。如果下载失败,也可以手动下载脚本文件,然后添加指定的对应目录下。具体说明可以看ComfyUI的终端命令行输出来判断需要下载哪些文件。
工作流示例
如图是示例的工作流 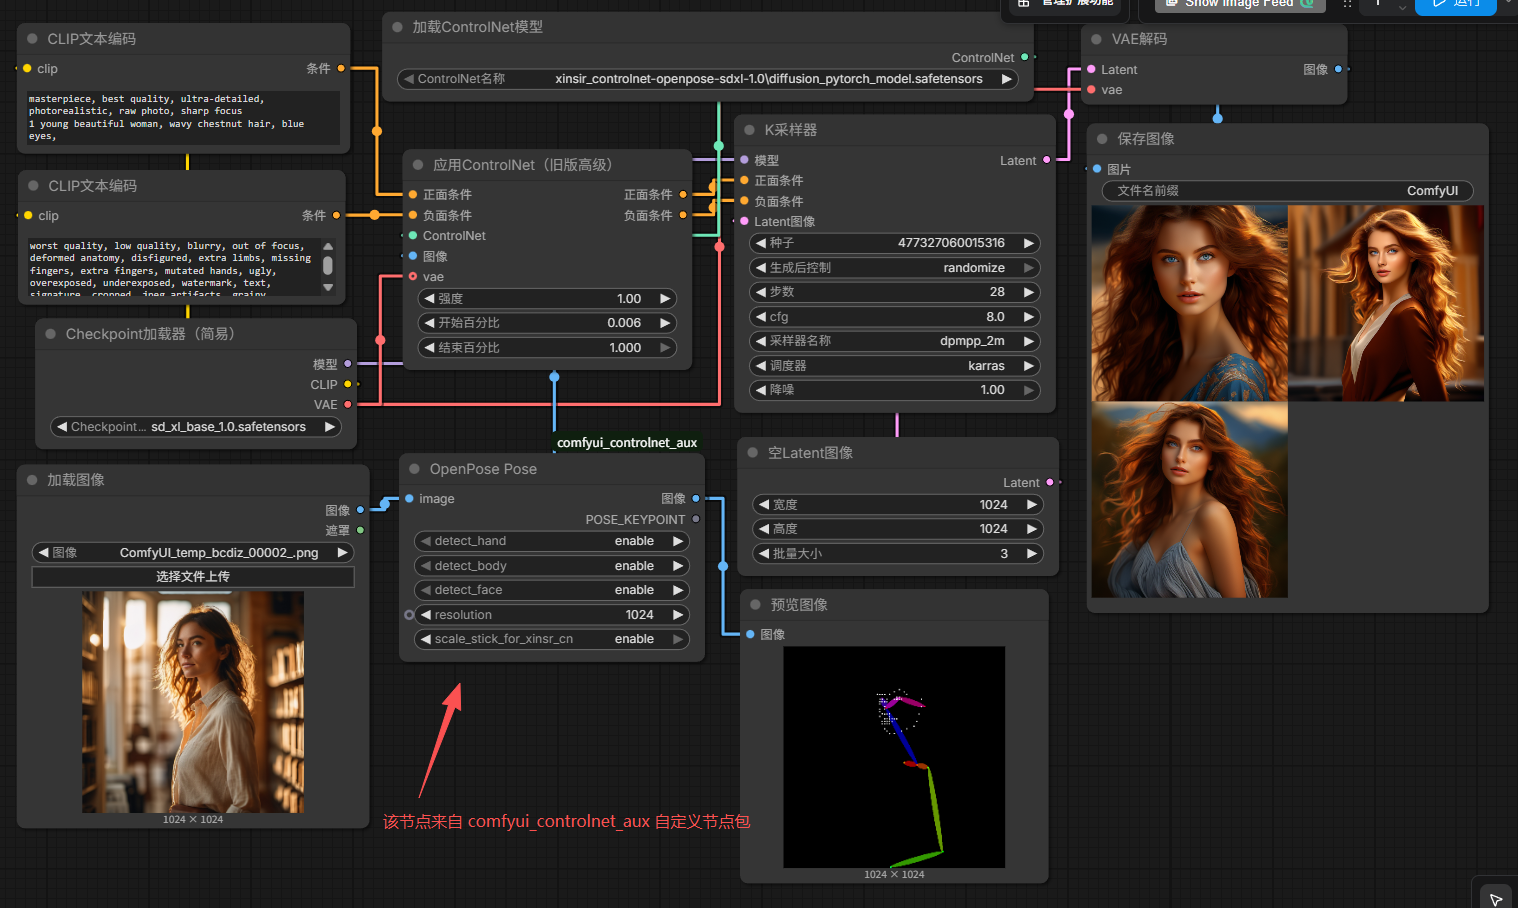
工作流说明
- 该工作流中包含了comfyui_controlnet_aux自定义节点包中的 OpenPose Pose预处理器节点。
- 基础模型用的是sdxl模型。搭配的controlnet模型是xinsir_controlnet-openpose-sdxl-1.0模型。两者互相搭配。
注意事项
- 图像尺寸要根据基础模型的最佳生成分辨率来设置。否则会导致新图的效果异常。例如sdxl的最佳生成分辨率为1024x1024。
canny 边缘检测
Canny 边缘检测 是一种基于Canny边缘检测算法的ControlNet模型。它能够根据原图,生成对应边缘线控制图。
canny edge 边缘检测预处理器节点
该节点的核心作用是提取画面高对比度硬边缘,输出黑白锐利线条,是最基础的轮廓控制方案。
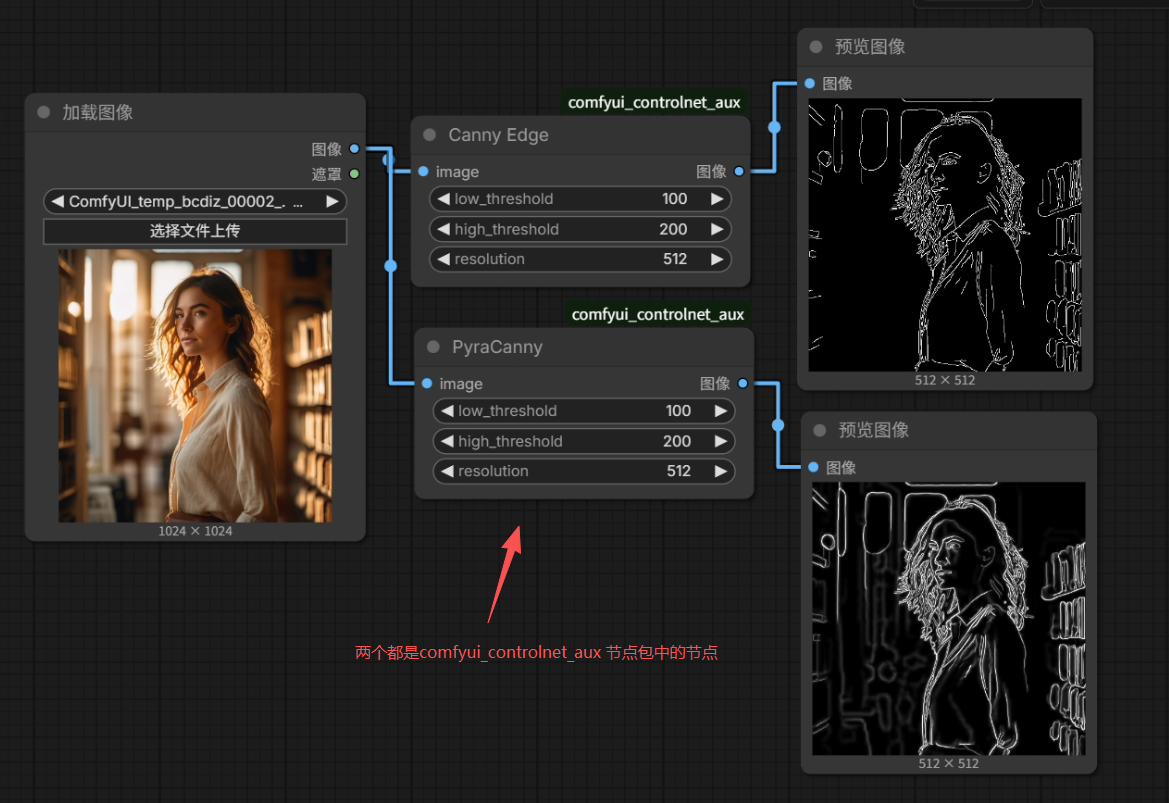
如图所示不同的节点,对应不同的处理效果
- Canny Edge: 标准Canny Edge节点。偏向简笔风格。
- PyraCanny: 基于Pyramid的Canny Edge节点。
适用场景
- 建筑、产品、机械结构严格锁定
- 简笔画/线稿转写实场景
- 约束物体外形,防止构图跑偏
输入输出
- 输入:原图
- resolution: 输出的分辨率。
- threshold: 边缘检测高低阈值区间。阈值越高线条越少、越简洁;阈值越低线条越多、越复杂。
- 输出:边缘控制图
注意:由于使用了第三方节点包,因此在使用第三方预处理器节点时,可能会从外网下载一些脚本文件,节点才能正常运行。请确保你的网络环境允许下载。如果下载失败,也可以手动下载脚本文件,然后添加指定的对应目录下。具体说明可以看ComfyUI的终端命令行输出来判断需要下载哪些文件。
工作流示例
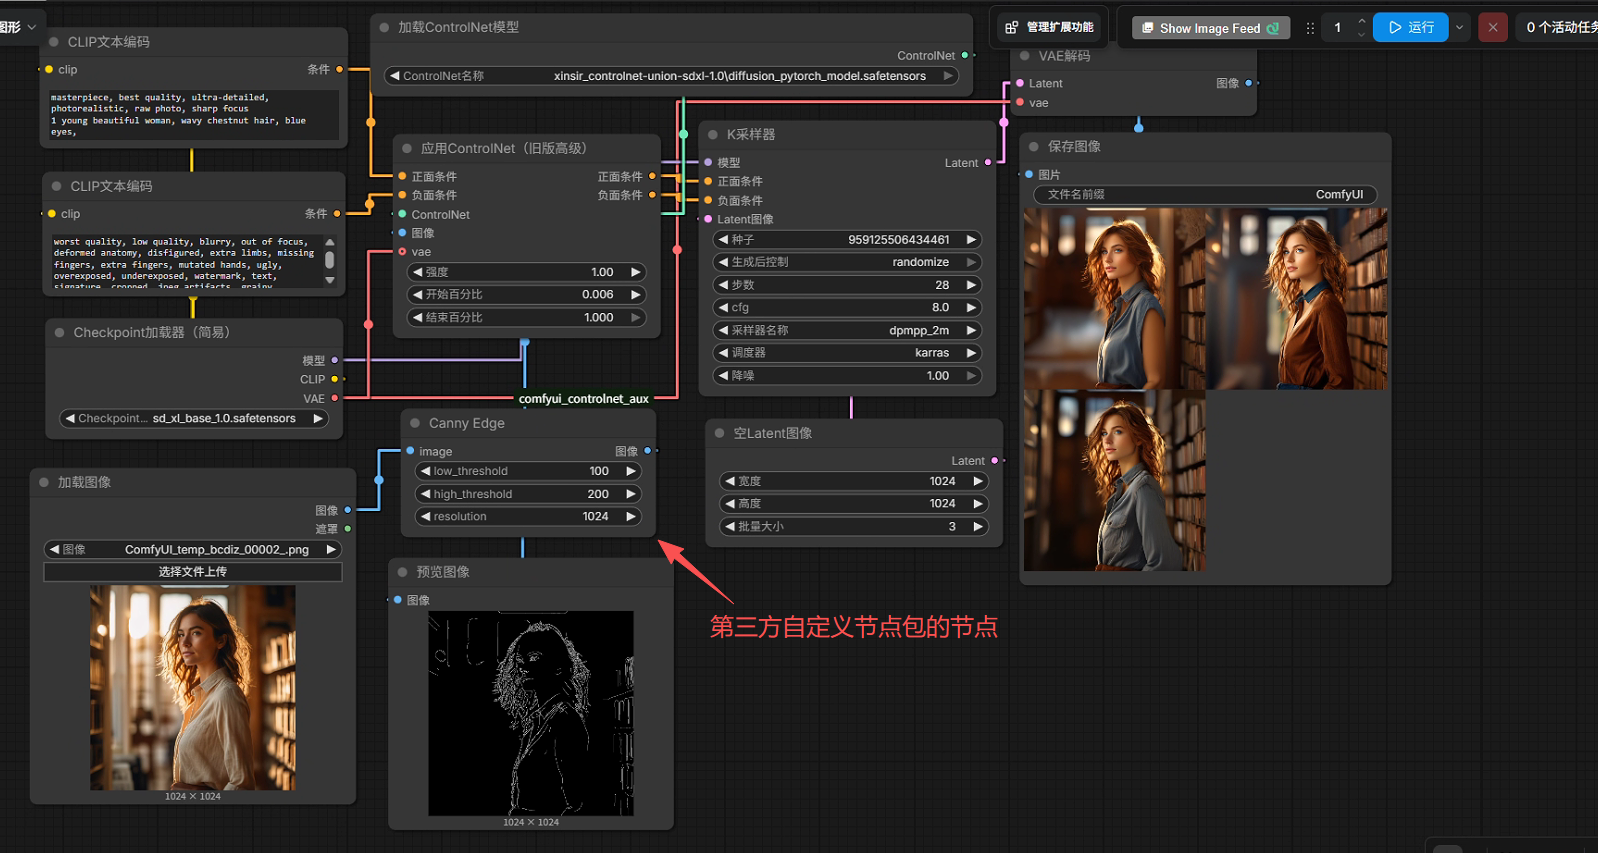
如图是使用canny 边缘检测 ControlNet模型 的工作流。可以看到通过边缘控制图生成的新图都是符合原图边缘特征的。
工作流说明
- 该工作流中包含了comfyui_controlnet_aux自定义节点包中的Canny Edge预处理器节点。
- 基础模型用的是sdxl模型。搭配的controlnet模型是
xinsir_controlnet-union-sdxl-1.0模型。这个模型是多功能ControlNet模型,包含了Canny Edge、OpenPose、Lineart等多个功能。
注意事项
- 图像尺寸要根据基础模型的最佳生成分辨率来设置。否则会导致新图的效果异常。例如sdxl的最佳生成分辨率为1024x1024。
lineart 艺术线稿
LineArt 是一种基于简单艺术线稿的ControlNet模型。它能够根据原图,生成对应的艺术线稿图像。
lineart 艺术线稿控制预处理器节点
如图是三种不同的lineart预处理器节点的使用效果。 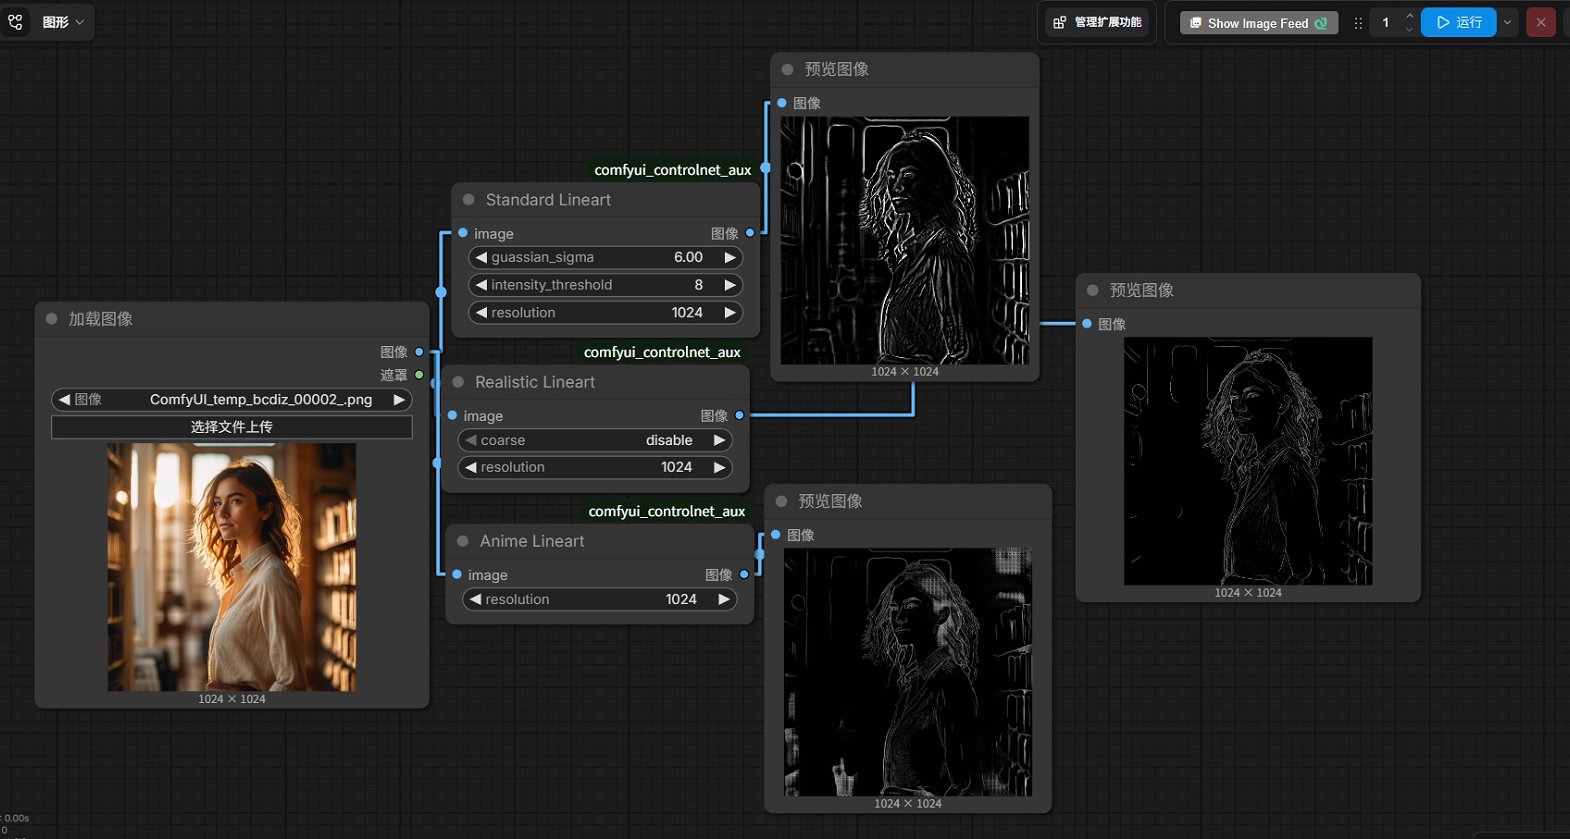
不同的lineart预处理器节点,对应不同的风格。
- Standard Lineart: 标准艺术线稿控制节点。
- Realistic Lineart: 真实艺术线稿控制节点。偏向写实风格。
- Anime Lineart: 动漫艺术线稿控制节点。偏向动漫风格。
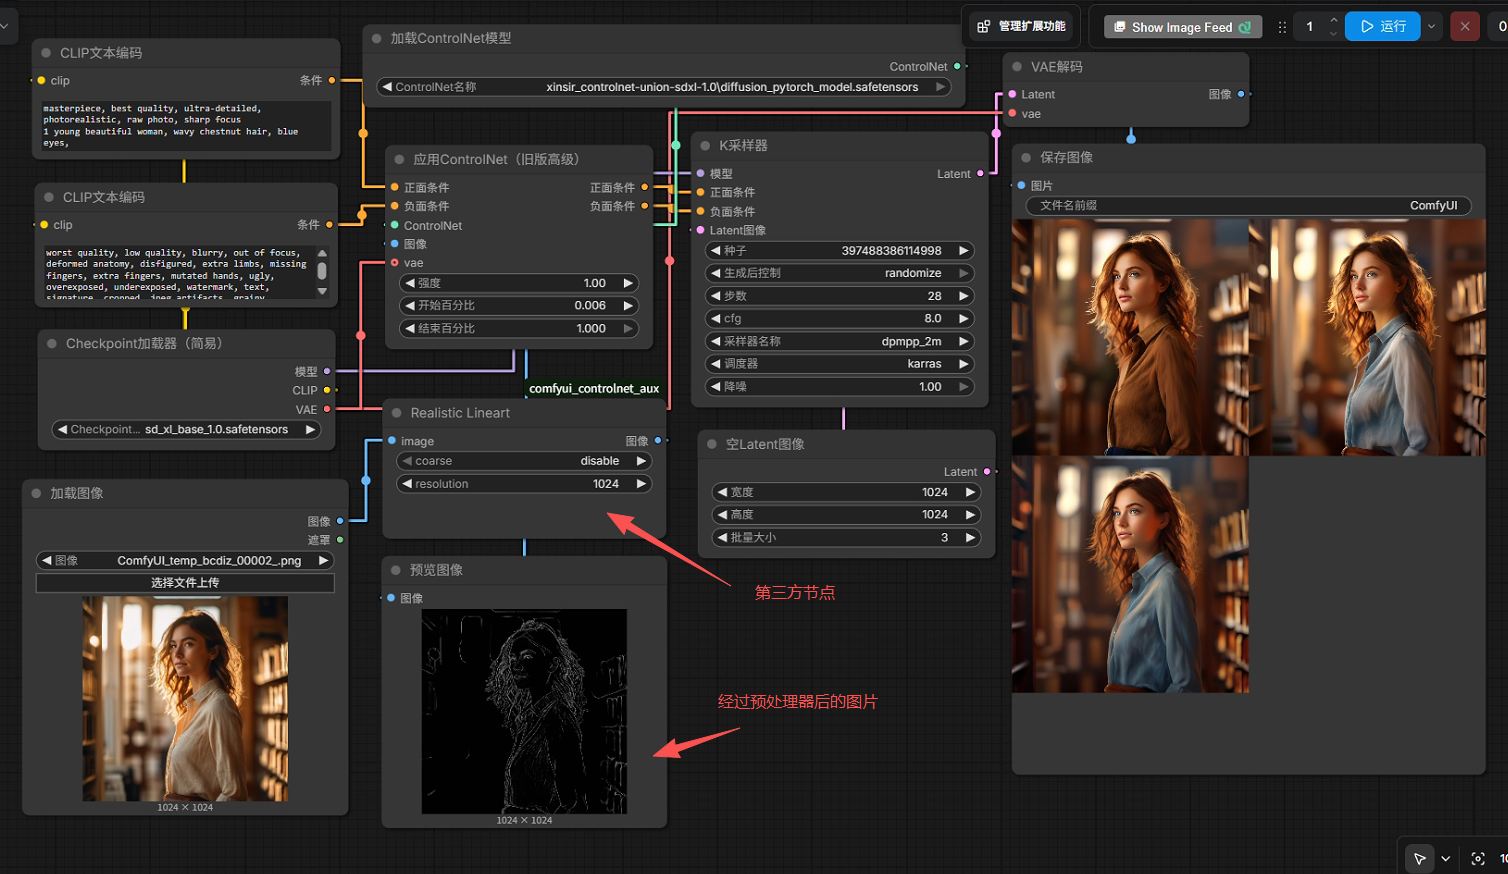
注意:由于使用了第三方节点包,因此在使用第三方预处理器节点时,可能会从外网下载一些脚本文件,节点才能正常运行。请确保你的网络环境允许下载。如果下载失败,也可以手动下载脚本文件,然后添加指定的对应目录下。具体说明可以看ComfyUI的终端命令行输出来判断需要下载哪些文件。
工作流示例
如图是使用 lineart 艺术线稿 ControlNet模型 的工作流。可以看到通过艺术线稿控制图生成的新图都是符合原图特征的。
工作流说明
- 该工作流中包含了comfyui_controlnet_aux自定义节点包中的Lineart预处理器节点。
- 基础模型用的是sdxl模型。搭配的controlnet模型是
xinsir_controlnet-union-sdxl-1.0模型。这个模型是多功能ControlNet模型,包含了Canny Edge、OpenPose、Lineart等多个功能。
注意事项
- 图像尺寸要根据基础模型的最佳生成分辨率来设置。否则会导致新图的效果异常。例如sdxl的最佳生成分辨率为1024x1024。
SoftEdge 软边缘
SoftEdge 是一种基于软边缘检测的ControlNet模型。它能够根据原图,生成对应软边缘检测图像。
SoftEdge 软边缘检测预处理器节点
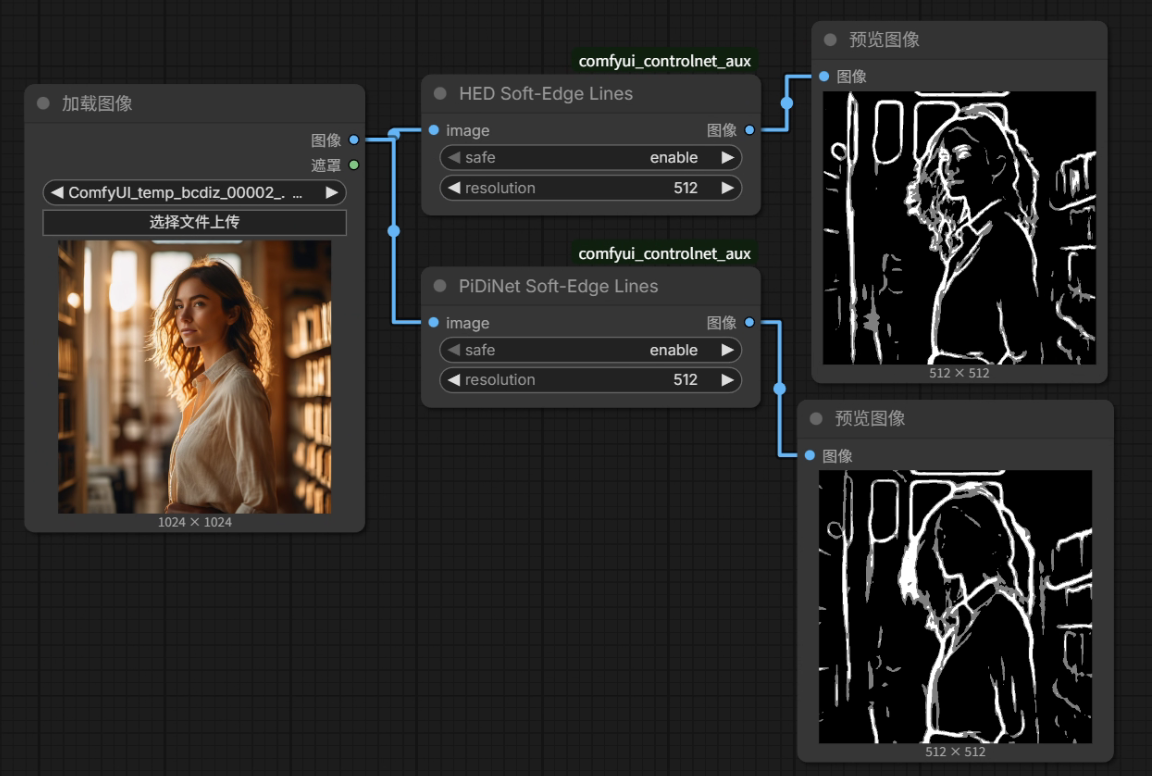
如图不同的SoftEdge 软边缘检测预处理器节点,对应不同的处理效果。
- HED Soft-Edge Lines: 基于HED模型的软边缘检测,输出软边缘检测图。
- PiDiNet Soft-Edge Lines: 基于PiDiNet模型的软边缘检测,输出软边缘检测图。
注意:由于使用了第三方节点包,因此在使用第三方预处理器节点时,可能会从外网下载一些脚本文件,节点才能正常运行。请确保你的网络环境允许下载。如果下载失败,也可以手动下载脚本文件,然后添加指定的对应目录下。具体说明可以看ComfyUI的终端命令行输出来判断需要下载哪些文件。
工作流示例
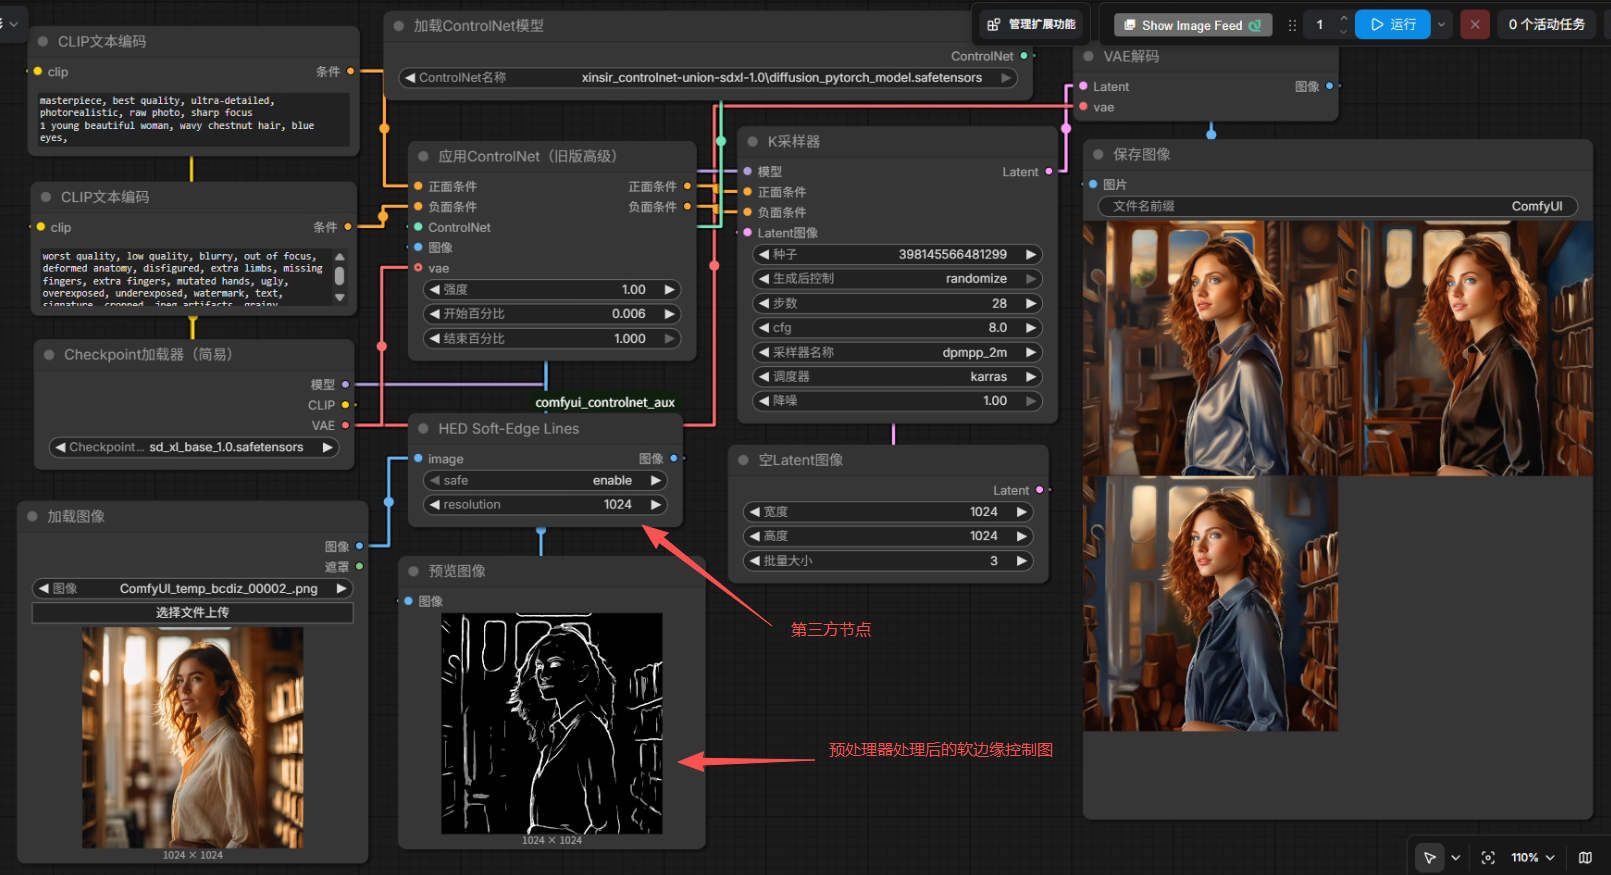
如图是使用 SoftEdge 软边缘检测 ControlNet模型 的工作流。可以看到通过软边缘检测生成的新图都是符合原图特征的。
工作流说明
- 该工作流中包含了comfyui_controlnet_aux自定义节点包中的SoftEdge预处理器节点。
- 基础模型用的是sdxl模型。搭配的controlnet模型是
xinsir_controlnet-union-sdxl-1.0模型。这个模型是多功能ControlNet模型,包含了Canny Edge、OpenPose、Lineart等多个功能。
注意事项
- 图像尺寸要根据基础模型的最佳生成分辨率来设置。否则会导致新图的效果异常。例如sdxl的最佳生成分辨率为1024x1024。
depth 深度图
Depth 是一种基于深度图的ControlNet模型。它能够根据原图,生成对应深度图图像。
depth 深度图预处理器节点
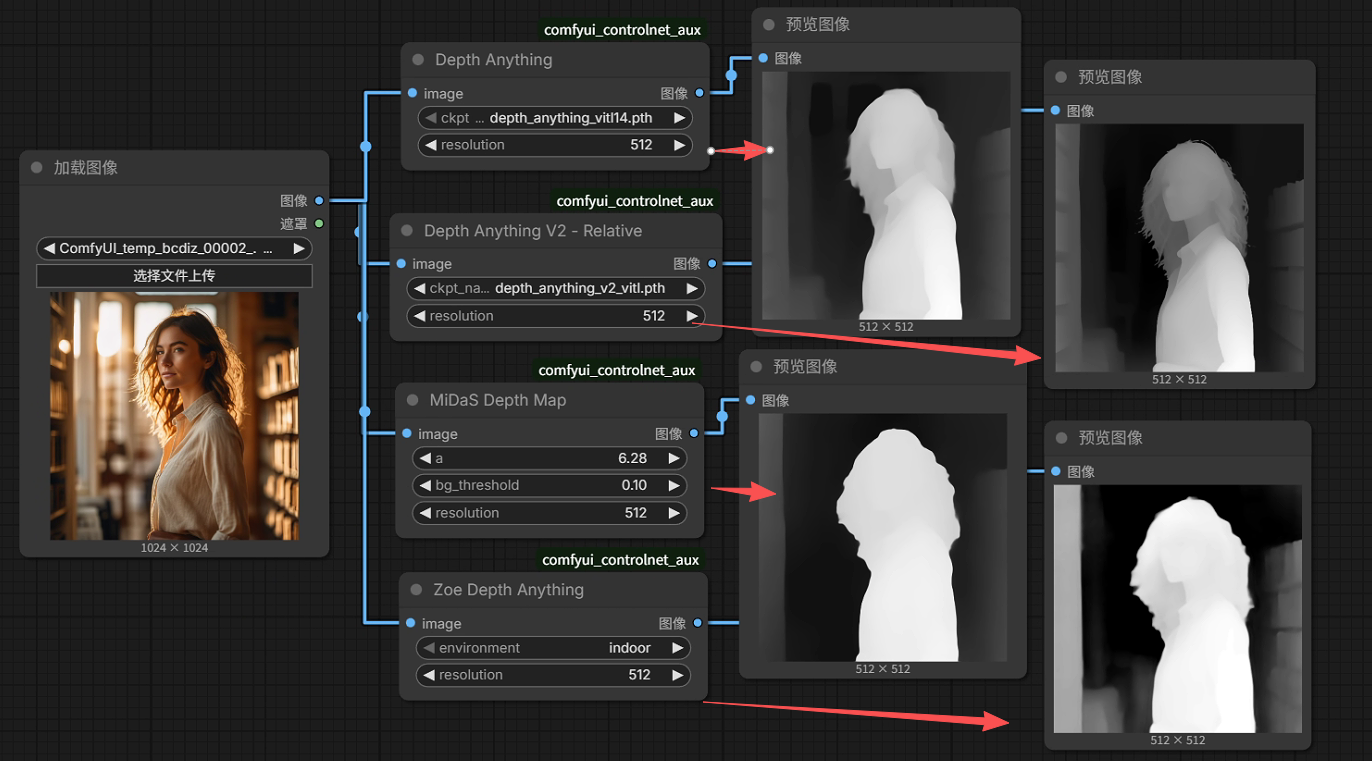
如图是各个深度图预处理器节点的使用效果。
- Depth Anything: 通用深度图预处理器节点,支持多种场景。
- Depth Anything V2: 新一代深度估计算法,复杂场景、边缘细节的识别精度远高于 Midas。
- Midas Depth Map: 估算画面深度信息,输出灰度深度图(近亮远暗),锁定前后空间层次。
- Zoe Depth Anything: 基于Zoe模型的深度图预处理器节点,支持多种场景。
注意:由于使用了第三方节点包,因此在使用第三方预处理器节点时,可能会从外网下载一些脚本文件,节点才能正常运行。请确保你的网络环境允许下载。如果下载失败,也可以手动下载脚本文件,然后添加指定的对应目录下。具体说明可以看ComfyUI的终端命令行输出来判断需要下载哪些文件。
工作流示例
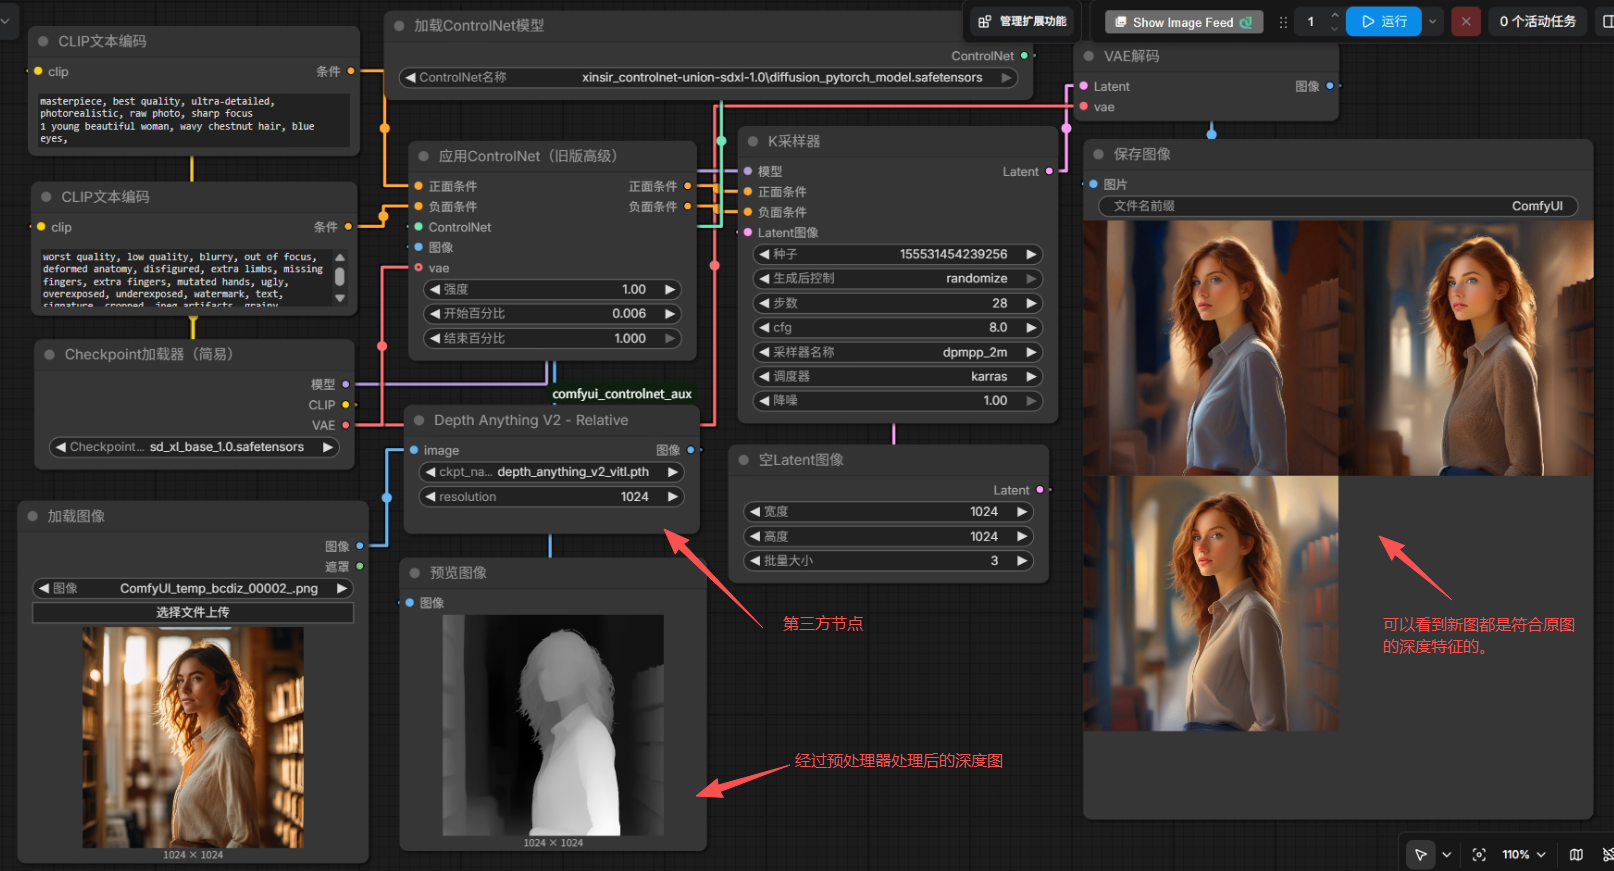
如图是使用 depth 深度图 ControlNet模型 的工作流。可以看到通过深度图生成的新图都是符合原图特征的。
工作流说明
- 该工作流中包含了comfyui_controlnet_aux自定义节点包中的Depth预处理器节点。
- 基础模型用的是sdxl模型。搭配的controlnet模型是
xinsir_controlnet-union-sdxl-1.0模型。这个模型是多功能ControlNet模型,包含了Canny Edge、OpenPose、Depth等多个功能。
注意事项
- 图像尺寸要根据基础模型的最佳生成分辨率来设置。否则会导致新图的效果异常。例如sdxl的最佳生成分辨率为1024x1024。
Tile 分块控制
在controlnet模型中,Tile 分块控制模型是一个非常有用的模型。
作用
Tile 分块控制模型,可以把原图切分成无数小图块(Tile),并在每一小块内保留原图色彩、光影、物体结构、纹理布局,同时填充高清细节;从而解决图像放大、图生图糊图、高清大图崩坏、局部细节丢失问题。
如图所示 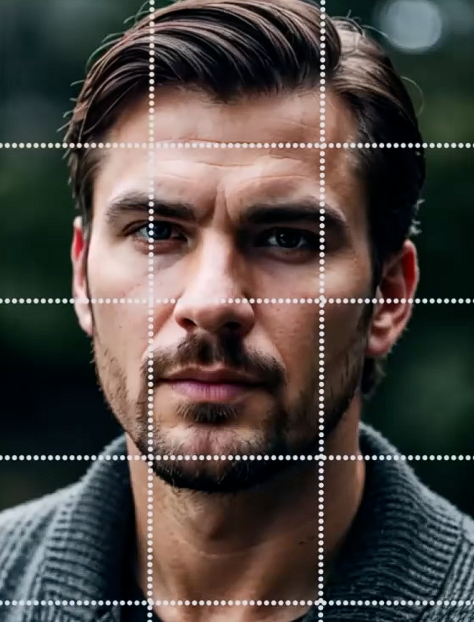
Tile 分块控制预处理器节点
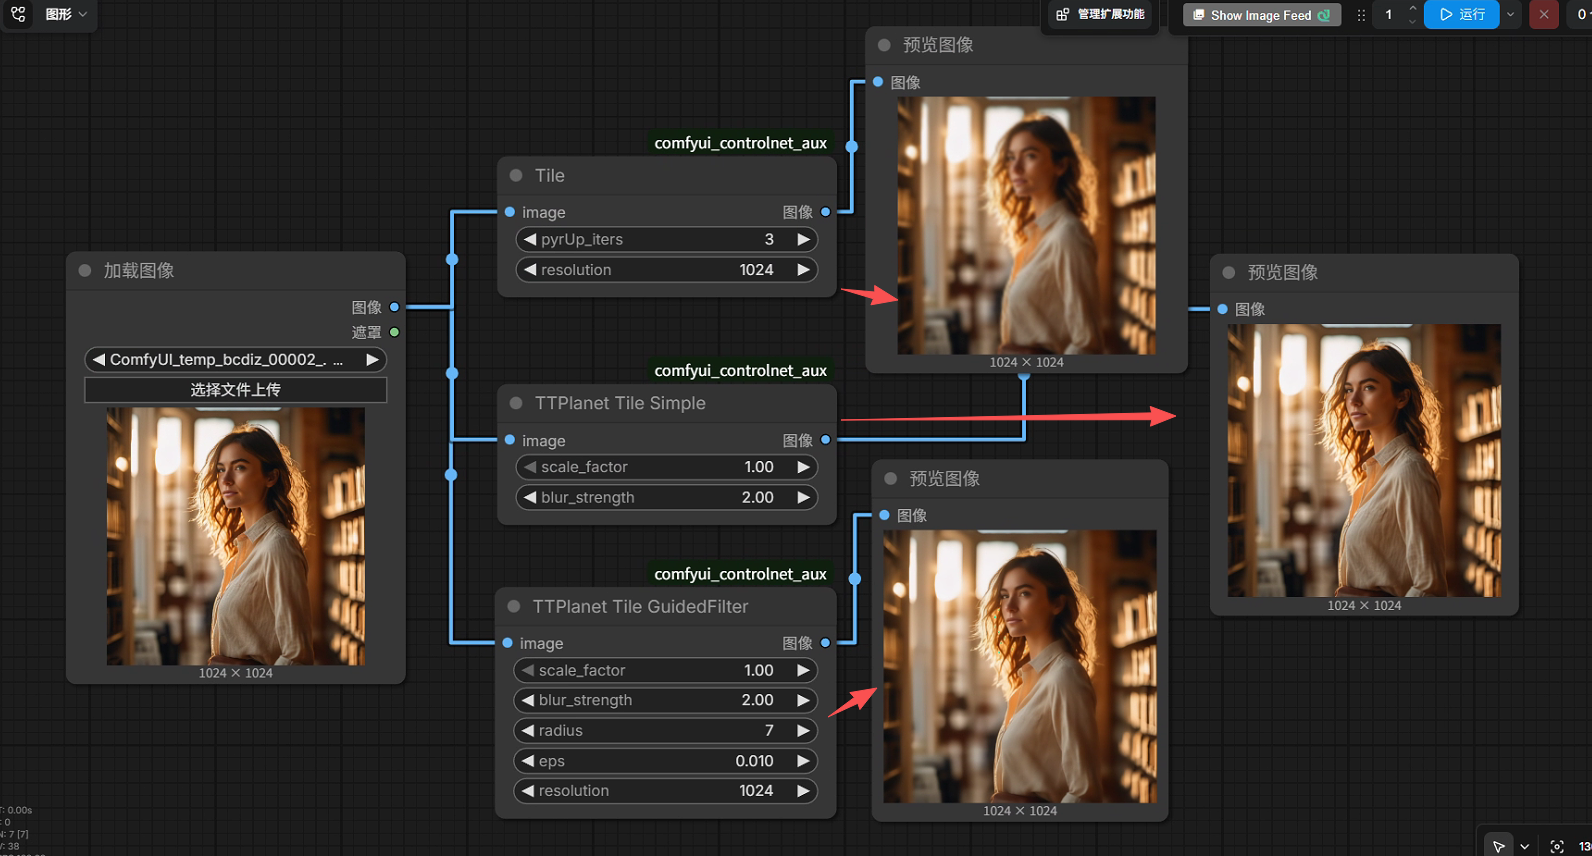
如图是各个Tile 分块控制预处理器节点的使用效果。
标准 Tile 节点: 通用Tile 分块控制预处理器节点,支持多种场景。
- pyrUp_iters 参数:图像分层拆分的次数。默认值为3。越高越精细,但是越不像原图。
- resolution 参数:输出图的分辨率,必须和最终出图尺寸完全一致,否则控制失效、人物扭曲。
TTPlanet Tile Simple (轻量化 Tile)节点: 运算速度比标准 Tile 快 30% 左右,低配置显卡更流畅。
TTPlanet Tile GuidedFilter(引导滤波专业级 Tile)节点: 专业版 Tile,参数最多,可控性拉满。
注意:由于使用了第三方节点包,因此在使用第三方预处理器节点时,可能会从外网下载一些脚本文件,节点才能正常运行。请确保你的网络环境允许下载。如果下载失败,也可以手动下载脚本文件,然后添加指定的对应目录下。具体说明可以看ComfyUI的终端命令行输出来判断需要下载哪些文件。
工作流示例
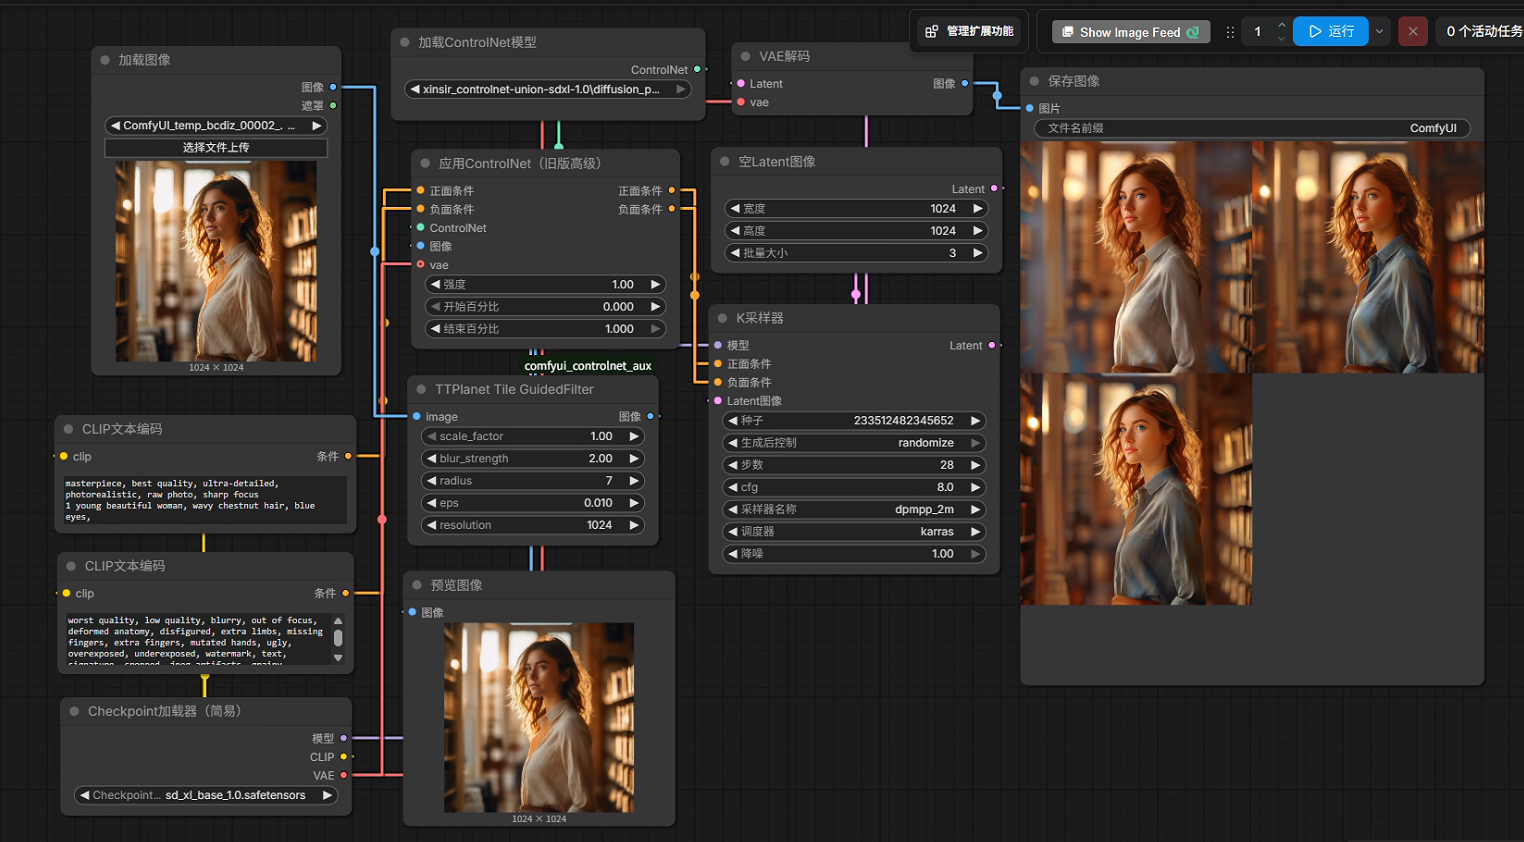
如图是使用 Tile 分块控制 ControlNet模型 的工作流。可以看到通过Tile 分块控制生成的新图都是符合原图特征的。
工作流说明
- 该工作流中包含了comfyui_controlnet_aux自定义节点包中的Tile 分块控制预处理器节点。
- 基础模型用的是sdxl模型。搭配的controlnet模型是
xinsir_controlnet-union-sdxl-1.0模型。这个模型是多功能ControlNet模型,包含了Canny Edge、OpenPose、Depth等多个功能。
注意事项
- 图像尺寸要根据基础模型的最佳生成分辨率来设置。否则会导致新图的效果异常。例如sdxl的最佳生成分辨率为1024x1024。
AIO Aux Preprocessor 多合一预处理器节点
该节点是comfyui_controlnet_aux自定义节点包中一体化的 ControlNet 预处理器节点。
原本每种预处理器(边缘图/姿势图/深度图)都需要对应的预处理器节点来进行处理。但是该节点集成了绝大多数预处理器。是上面SoftEdge、Depth、Lineart等多个预处理器节点的整合节点。
在使用该节点时,可以不用频繁增减节点,从而快速切换测试各类 ControlNet 控制图的效果。
如图所示 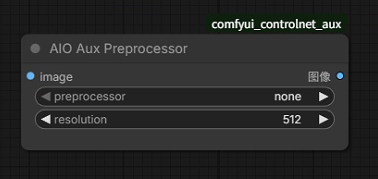
输入输出
- 输入:
- 图像输入:需要进行预处理的图像。
- preprocessor:选择要使用的预处理器。
- resolution:设置图像分辨率。
- 输出:
- 预处理后的图像:根据选择的预处理器,输出对应的预处理结果。
使用示例
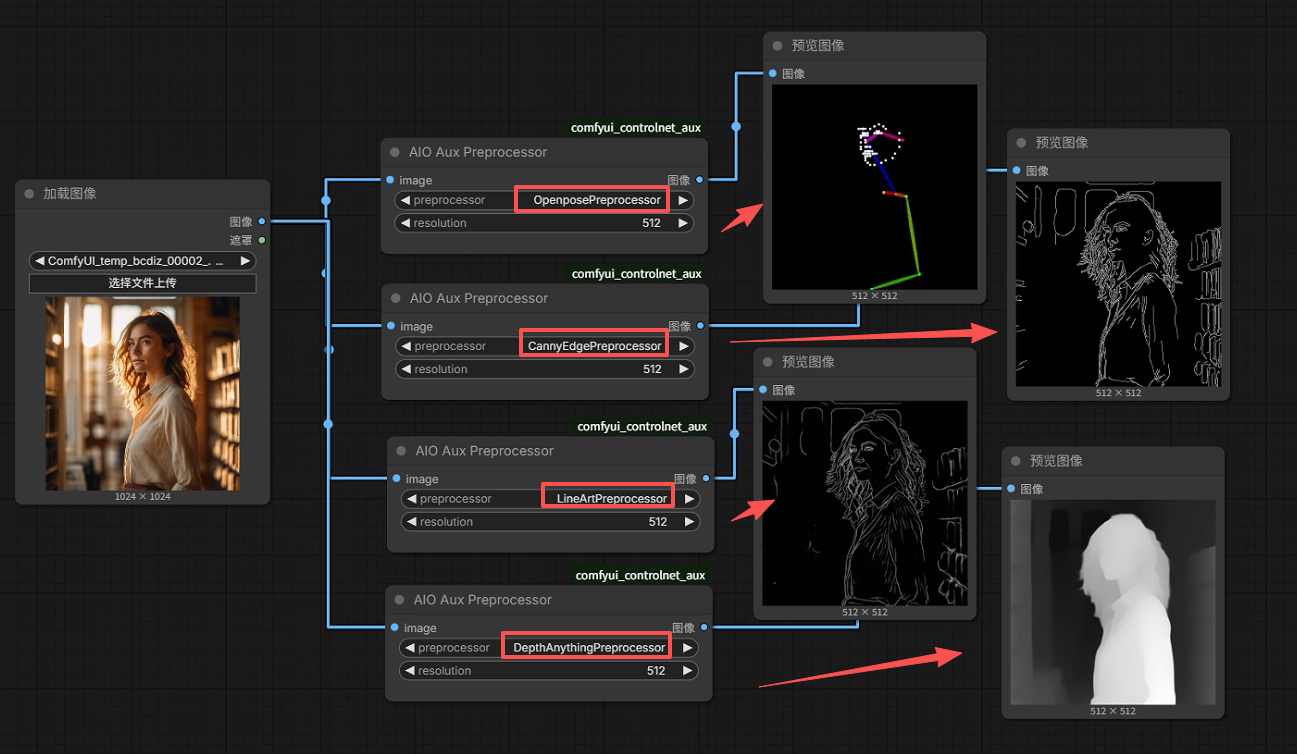
如图是使用AIO Aux Preprocessor节点,可以同时进行边缘图、姿势图、深度图、lineart图的预处理。
注意事项
多合一预处理器节点更多的用于测试。在实际生产场景中,建议使用对应的预处理器节点。因为在配置选项和预处理效果上,单个预处理器节点比多合一预处理器节点更好。
组合使用(多ControlNet搭配使用)
在实际的使用场景中,我们通常会结合使用多个ControlNet模型,以实现更复杂,更精确的控制效果。
如图所示,我们组合使用了lineart、OpenPose、Depth三个ControlNet模型,以实现更复杂,更精确的控制效果。 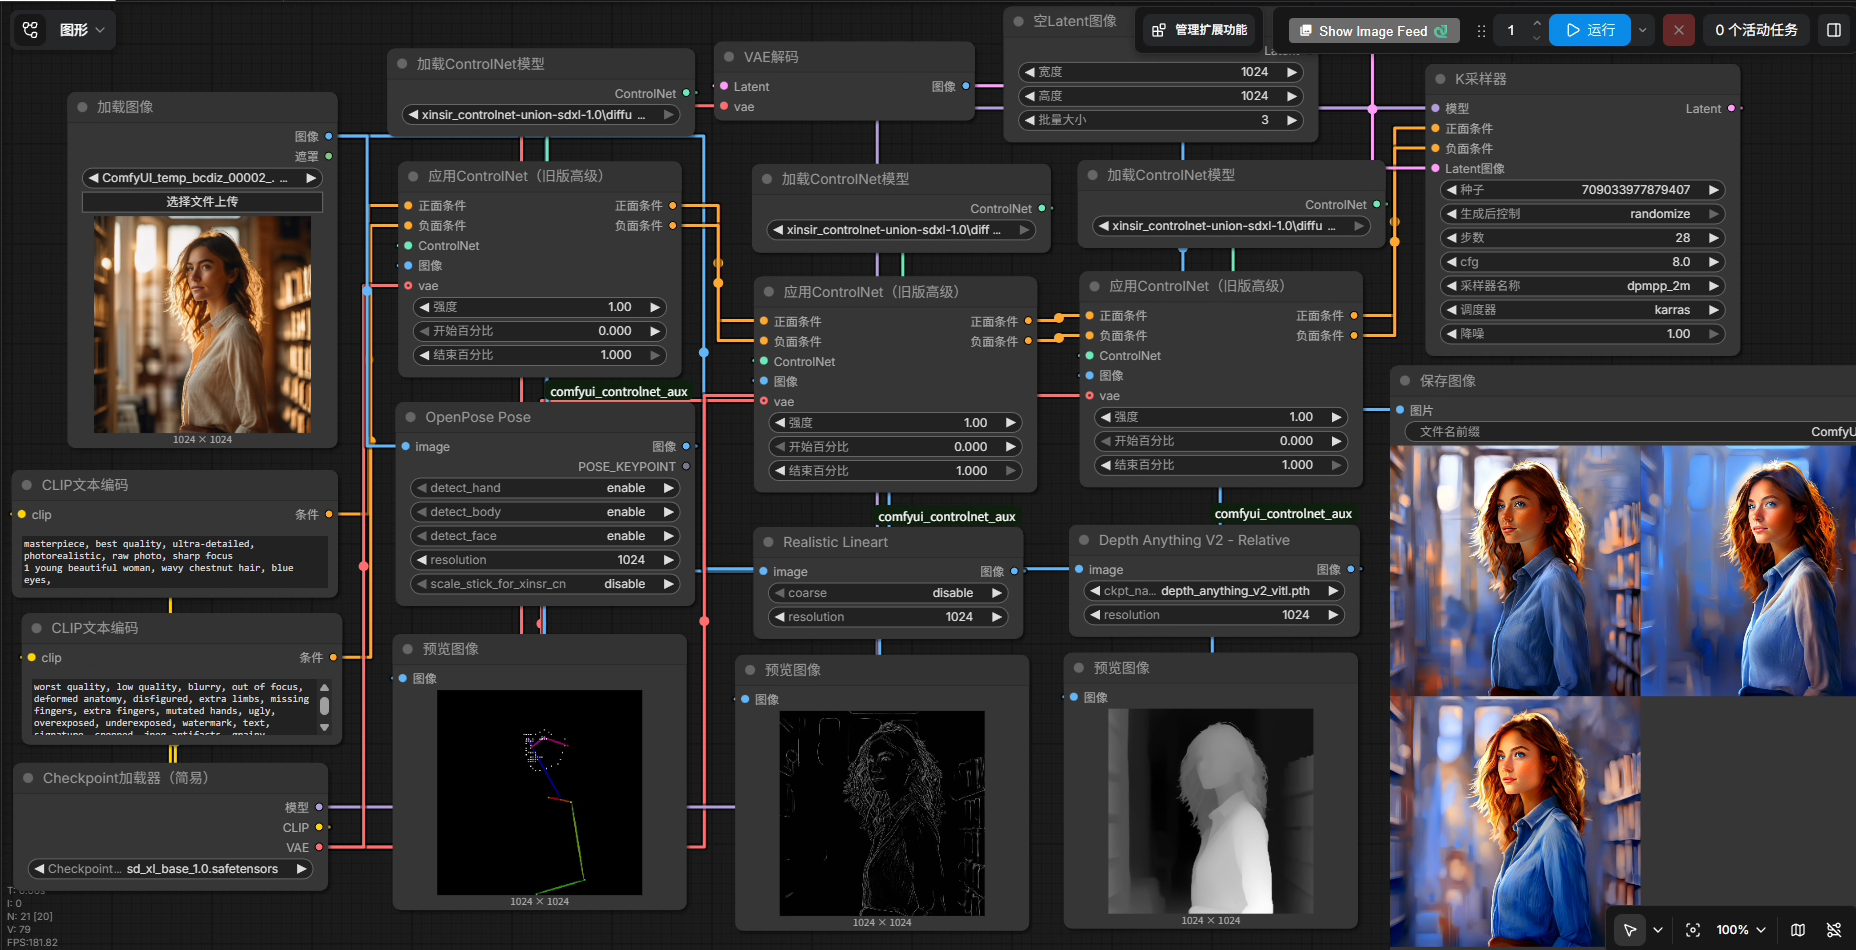
注意: 通过将多个 应用ControlNet节点 的正负面条件串联起来,以实现多ControlNet模型的组合使用。
注意:由于使用了第三方节点包,因此在使用第三方预处理器节点时,可能会从外网下载一些脚本文件,节点才能正常运行。请确保你的网络环境允许下载。如果下载失败,也可以手动下载脚本文件,然后添加指定的对应目录下。具体说明可以看ComfyUI的终端命令行输出来判断需要下载哪些文件。