[toc]
LangChain笔记
LangChain 官网 https://www.langchain.com/
LangChain 中文文档 https://reference.langchain.org.cn/python/
LangChain是什么
LangChain 本质上是一个用于构建大语言模型(LLM)应用的 Python 框架。
它的名称源自 "Language"(语言模型)与 "Chains"(链)的结合,核心思想是将多个大模型相关组件串联成工作流。
LangChain 作为连接和集成不同组件的桥梁。通过 LangChain 提供的统一接口,开发者可以方便地与大模型、Prompt、向量数据库、工具调用、记忆系统以及 Agent 工作流进行交互。从而帮助开发者快速构建复杂 AI 应用。
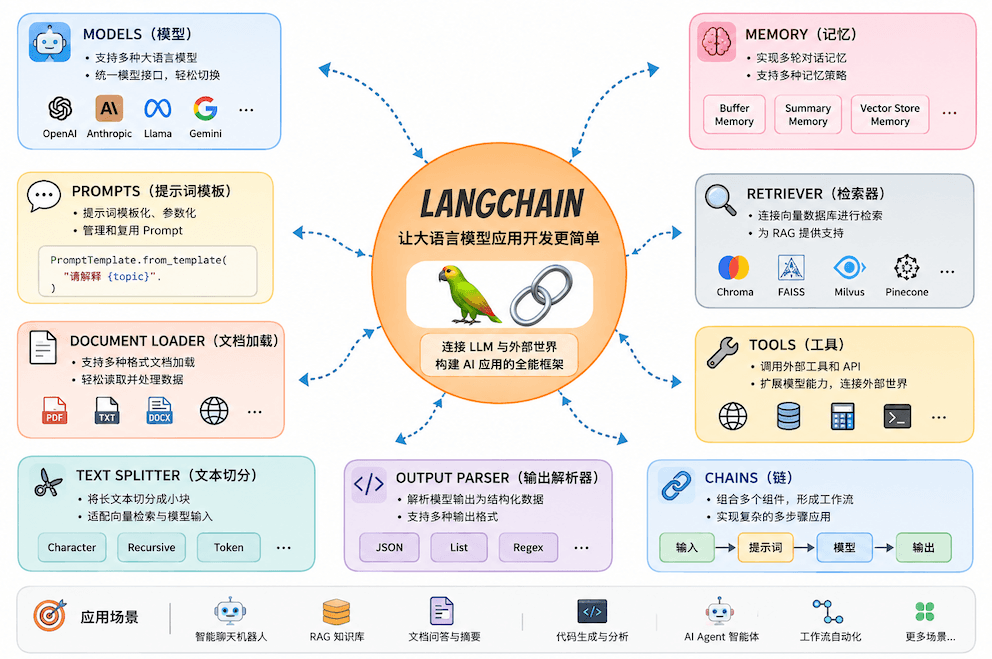
LangChain 各个组件的作用
| 组件 | 作用 |
|---|---|
| Models(模型) | 统一模型接口,支持多模型切换 |
| Prompts(提示词模板) | 管理 Prompt 模板,动态生成提示词,支持Prompt 参数化,模板复用等 |
| Document Loader(文档加载) | 读取外部文档数据,读取网页与数据库数据。 |
| Text Splitter(文本切分) | 拆分长文本,将文本转换为多个小的文本块(Chunk)。 |
| Memory(记忆) | 实现上下文记忆,保存聊天历史。 |
| Retriever(检索器) | 检索相关知识内容,向量搜索 语义检索。 |
| Tools(工具) | 调用外部工具与 API,搜索互联网,数据库查询。 |
| Output Parser(输出解析器) | 解析模型输出结果,将模型输出转换为结构化输出。 |
| Chains(链) | 组合多个组件形成工作流,实现流程编排,组件串联。 |
LangChain 在 AI 技术中的定位
LangChain 在 AI 技术栈中处于应用层框架的位置。
上层应用可以统一使用 LangChain 提供的接口,无需关心底层模型的实现细节。
┌─────────────────────────────────────────────┐
│              业务应用层                      │
│   智能客服、代码助手、数据分析、自动化工作流    │
├─────────────────────────────────────────────┤
│              应用框架层                      │
│               LangChain                     │
├─────────────────────────────────────────────┤
│              模型层                          │
│OpenAI系列模型 / Google系列模型 / 其他模型      │
├─────────────────────────────────────────────┤
│              基础设施层                      │
│   向量数据库、存储系统、内部数据库             │
└─────────────────────────────────────────────┘
核心包架构
采用"微内核 + 插件"模式:
| 包名 | 定位 | 核心内容 |
|---|---|---|
| langchain-core | 核心抽象层 | Runnable 协议、BaseChatModel、BaseTool、BaseMessage、Callbacks |
| langchain-community | 第三方集成大本营 | 向量数据库(FAISS、Chroma等)、工具(Search、Requests等)、文档加载器 |
| langchain-openai | 特定平台模型集成 | ChatOpenAI、OpenAIEmbeddings |
| langchain | 主包 | create_agent、init_chat_model、标准化 content blocks |
| langgraph | 底层执行运行时 | 图结构工作流、状态机、持久化执行 |
安装
# 安装  langchain 包
pip install langchain
集成其他模型包
LangChain 本身不包含具体的模型实现,你需要根据使用的模型安装对应的包
| 模型提供商 | 安装命令 | 使用的模型 |
|---|---|---|
| OpenAI | pip install langchain-openai | GPT-4、GPT-5 等 |
| Anthropic | pip install langchain-anthropic | Claude 系列 |
| DeepSeek | pip install langchain-deepseek | DeepSeek-V3、R1 等 |
| pip install langchain-google-genai | Gemini 系列 | |
| Ollama(本地模型) | pip install langchain-ollama | Llama、Qwen 等本地模型 |
| xAI | pip install langchain-xai | Grok 系列 |
配置模型商的API key
当你需要使用某个模型商的模型时,你需要配置对应的 API key。
自行参考各个模型商的文档,配置对应的 API key。
LangChain 集成 阿里云百炼大模型平台 示例
from langchain_openai import ChatOpenAI

chatLLM = ChatOpenAI(
    api_key="sk-bdxxxxxx",                  #阿里云百炼大模型平台的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",   #阿里云百炼大模型平台的API地址
    model="qwen-plus",  # 模型名词 qwen-plus为例,您可按需更换模型名称。模型列表:https://help.aliyun.com/zh/model-studio/getting-started/models
)

# 测试一下
response = chatLLM.invoke("你好,请做一个简短的自我介绍。")
print(response.content)

# 运行结果
# 你好!我是通义千问(Qwen),阿里巴巴集团旗下的超大规模语言模型。我擅长回答问题、创作文字,比如写故事、写公文、写邮件、写剧本、逻辑推理、编程等等,还能表达观点,玩游戏等。我支持多种语言,包括中文、英文、法语、西班牙语等,希望能以友好、专业和耐心的态度为你提供帮助。😊 有什么我可以帮助你的吗?
模型
LangChain 的标准模型接口让您可以访问许多不同的模型提供商的模型。
初始化模型 (init_chat_model 函数)
init_chat_model() 是 LangChain 中最常用的函数之一,它让你用统一的方式连接 20 多种模型提供商,不需要记忆每个提供商的类名和参数差异。
init_chat_model() 函数语法
init_chat_model() 函数可以初始化一个模型对象。该函数返回一个BaseChatModel对象。
from langchain.chat_models import init_chat_model
# 完整语法
model = init_chat_model(
    model,                    # str | None
    *,
    model_provider=None,      # str | None
    configurable_fields=None, # None | "any" | list[str]
    config_prefix=None,       # str | None
    **kwargs,                 # dict
)
参数说明
- model: 模型名称。通常是 provider:model 格式。传 None 时可用于创建可配置模型。
- model_provider: 单独指定模型提供商。默认None,当 model 无法推断时使用。
- configurable_fields: 可运行时修改的字段列表。None 表示固定模型
- config_prefix: 多模型场景下配置键的前缀,避免冲突。默认None。
- kwargs: 传递给底层模型的参数。默认None。
指定模型(model 参数,必填)
model 参数要与模型提供商配合使用的特定模型名称或标识符。
model参数也可以使用 “提供商:模型名” 格式在单个参数中同时指定模型及其提供商
from langchain.chat_models import init_chat_model

# model参数一般是 provider:model 格式
model = init_chat_model("deepseek:deepseek-chat")
model = init_chat_model("ollama:llama3.2")

# init_chat_model 会根据model参数自动推断提供商
model = init_chat_model("deepseek-chat")     # 推断为 deepseek 模型商
model = init_chat_model("grok-3")            # 推断为 xai 模型商
指定模型提供商(model_provider 参数,可选)
假如有的模型是同名的,但是来自不同的模型提供商,你可以使用 model_provider 参数来指定模型提供商。
from langchain.chat_models import init_chat_model
# 当 model_provider 单独指定时,效果等价于 provider:model 格式。
model = init_chat_model("deepseek-v4-flash", model_provider="deepseek")
model = init_chat_model("deepseek:deepseek-v4-flash")
指定模型的 API 地址 和 API Key(base_url 和 api_key 参数)
- base_url 参数用于指定模型提供商的 API 地址。默认值为模型提供商的 API 地址。
- api_key 参数用于指定模型提供商的 API Key。默认值为None。通常设置在环境变量中。
我们可以通过指定这两个参数,来调用第三方的模型服务。
from langchain.chat_models import init_chat_model

# 场景 使用兼容 OpenAI 接口的第三方服务
# 很多国产模型提供了第三方的 OpenAI 兼容接口
model = init_chat_model(
    "openai:deepseek-v4-flash",                 # provider 写 openai
    base_url="https://api.third-party.com/v1",  # 但实际指向第三方服务的 API 地址
    api_key="xxxx",  # 第三方 API Key
)

# 场景 连接本地模型(如 vLLM、Ollama)
model = init_chat_model(
    "openai:qwen2.5",               # 本地模型名
    base_url="http://localhost:8000/v1",  # 本地服务地址
    api_key="not-needed",           # 本地通常不需要 Key
)
控制模型的输出随机性(temperature 参数)
temperature 参数用于控制模型的输出随机性。temperature 参数默认值为0.7,范围为0.0到2.0。数值越大,模型生成的文本越随机。
什么是输出随机性?
输出随机性是指模型生成的文本的随机程度。即对于同一个问题的情况下,这一次和下一次调用模型时,生成的文本是否不同。
示例
from langchain.chat_models import init_chat_model

# 同一问题,不同 temperature 的对比
question = "用一句话介绍你自己!"

# temperature=0:输出非常确定,几乎每次结果一样
model_low = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)
resp1 = model_low.invoke(question)
resp2 = model_low.invoke(question)
print(f"temperature=0 第1次输出结果: {resp1.content}")
print(f"temperature=0 第2次输出结果: {resp2.content}")

# temperature=1.5:输出多样化,每次可能不同
model_high = init_chat_model("deepseek:deepseek-v4-flash", temperature=1.5)
resp1 = model_high.invoke(question)
resp2 = model_high.invoke(question)
print(f"temperature=1.5 第1次输出结果: {resp1.content}")
print(f"temperature=1.5 第2次输出结果: {resp2.content}")| temperature 值 | 效果 | 适用场景 |
|---|---|---|
| 0 ~ 0.3 | 输出稳定、确定,每次结果几乎一致 | 数据提取、分类、代码生成、翻译 |
| 0.5 ~ 0.7 | 适度的创造性,输出自然但不偏离主题 | 日常对话、内容总结 |
| 0.8 ~ 1.2 | 输出多样化,有较多发挥空间 | 创意写作、头脑风暴 |
| 1.3 ~ 2.0 | 输出非常随机,可能出现意外内容 | 探索性生成(不太推荐用于生产) |
控制模型的调用超时时间和重试次数(timeout 参数,max_retries 参数)
- timeout 参数用于设置单词请求模型调用的超时时间。None 表示不限制。
- max_retries 参数用于设置模型调用失败时的重试次数。0 表示不重试。
from langchain.chat_models import init_chat_model

model = init_chat_model(
    "deepseek:deepseek-v4-flash",
    # 单次请求最多等待 30 秒
    timeout=30,
    # 失败后最多重试 3 次(总共 4 次请求机会)
    max_retries=3,
)

# 模拟正常调用
try:
    response = model.invoke("你是什么?")
    print(f"调用成功: {response.content}")
except Exception as e:
    print(f"调用失败: {e}")
控制模型全局的输出长度(max_tokens 参数)
max_tokens 限制模型输出的最大 Token 数。一个 Token 大约相当于 0.75 个英文单词或 0.5 个中文字。
from langchain.chat_models import init_chat_model
# 初始化模型对象
model = init_chat_model("deepseek:deepseek-v4-flash", max_tokens=30)

# max_tokens=30:限制输出在 30 个 Token 以内
response_short = model.invoke("详细介绍一下你自己",)
print(response_short.content)
调用模型(invoke() 方法)
当使用init_chat_model()函数获取模型对象时。我们可以用invoke()方法,来调用模型。
该方法返回模型回复对象 AIMessage,包含模型的完整回复内容、元数据等。
控制当前调用模型的输出长度(max_tokens 参数)
max_tokens 限制模型输出的最大 Token 数。一个 Token 大约相当于 0.75 个英文单词或 0.5 个中文字。
from langchain.chat_models import init_chat_model
# 初始化模型对象
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

# max_tokens=30:限制输出在 30 个 Token 以内
response_short = model.invoke(
    "详细介绍一下你自己",
    max_tokens=30
)
print(response_short.content)
注意:invoke() 方法的 max_tokens 参数与模型的 max_tokens 参数是不同的。
- 模型的 max_tokens 参数限制了模型生成的文本的最大 Token 数。
- invoke() 方法的 max_tokens 参数仅对这一次调用模型的文本内容生效。会覆盖模型的 max_tokens 参数。
异步调用模型(ainvoke() 方法)
ainvoke() 方法异步调用模型,适合在 Web 服务等异步环境中使用。
from langchain.chat_models import init_chat_model
# 初始化模型对象
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

# 异步调用模型
response = model.ainvoke(
    "详细介绍一下你自己",
)
print(response.content)
流式输出(stream() 方法)
流式输出是指模型在生成输出时,会实时地将生成的内容发送给客户端。
调用 stream()方法 会返回多个 AIMessageChunk 迭代器对象。每个迭代器对象只包含输出文本的一部分。
您可以使用循环来实时处理每个迭代器对象。通过相加累积成一条完整的消息。
from langchain.chat_models import init_chat_model
# 初始化模型对象
model = init_chat_model("deepseek:deepseek-v4-flash")

# stream() 方法返回的是多个 AIMessageChunk 迭代器对象,需要遍历获取其中的每个 chunk
for chunk in model.stream("用一句话介绍你自己"):
    # 每个 chunk 是一小段文本,打印出来
    print(chunk.content, end="", flush=True)
批量处理(batch() 方法)
批量处理一组独立的模型请求可以显著提高性能并降低成本,因为处理可以并行进行。
from langchain.chat_models import init_chat_model
# 初始化模型对象
model = init_chat_model("deepseek:deepseek-v4-flash")

# 批量处理一组独立的模型请求
# 该方法返回一个列表,每个元素对应一个模型的回复。
responses = model.batch([
    "1+1=?",
    "你是谁?",
    "你是什么?"
])
# 打印每个问题的回复
for response in responses:
    print(response.content)
消息
在 LangChain 中,所有的对话都通过消息(Message)进行传递。
LangChain 定义了四种核心消息类型,分别代表对话中的不同角色。
| 消息类型 | 消息对应角色 | 说明 | 典型内容 |
|---|---|---|---|
| HumanMessage | 用户,人类 | 用户发送的消息 | "今天天气怎么样?" |
| AIMessage | AI 助手 | 模型的回复,可能包含 tool_calls | "今天杭州晴天,25°C" |
| SystemMessage | 系统 | 系统指令,定义 AI 的角色和行为规则 | "你是一个专业的天气助手" |
| ToolMessage | 工具 | 工具执行后的返回结果 | "晴,25°C,湿度 60%" |
BaseMessage 基础消息
所有消息类型都继承自 BaseMessage,共享一些通用方法:
- content: 消息的文本内容。
- type: 消息的类型,如 human、ai、system、tool 等。
- role: 消息的角色,如 user、assistant、system 等。
示例如下
from langchain.messages import BaseMessage

# 创建一条基础消息
msg = HumanMessage(content="你好")

print(f"类型: {msg.type}")        # human
print(f"内容: {msg.content}")      # 你好
print(f"角色: {msg.role}")         # user

# text 属性:如果是文本内容,返回文本;否则返回 ""
print(f"text: {msg.text}")
HumanMessage 用户消息
HumanMessage 代表用户发送给 AI 的消息。
from langchain.messages import HumanMessage
from langchain.chat_models import init_chat_model

# 创建一条用户消息
msg = HumanMessage(content="你是什么?")

print(f"类型: {msg.type}")        # human
print(f"内容: {msg.content}")      # 你是什么?
print(f"角色: {msg.role}")         # user

# 创建消息列表(代表多轮对话历史)
messages_history = [
    HumanMessage(content="你好"),
    HumanMessage(content="你是什么?"),
    HumanMessage(content="Python 课程适合零基础吗?"),
]

# 初始化模型对象
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

# 调用模型,传入消息列表(代表多轮对话历史)获取模型回复。
response = model.invoke(messages_history)

# 打印模型回复
print(f"模型回复: {response.content}")
其他格式的 HumanMessage
代码中的几种方式都是等价的,都会在 Agent 内部被转换为 HumanMessage 用户消息。
from langchain.messages import HumanMessage

# 方式 1:标准构造函数
msg1 = HumanMessage(content="你好")

# 方式 2:元组快捷方式 (role, content) user表示用户消息
msg2 = ("user", "你好")
# 方式 3:元组快捷方式 (role, content) human表示用户消息
msg3 = ("human", "你好")

# 方式 4:字典格式数据,表示用户消息
msg4 = {"role": "user", "content": "你好"}
# 方式 5:字典格式数据,表示用户消息
msg5 = {"role": "human", "content": "你好"}

# 这几种方式等价,都会在 Agent 内部被转换为 HumanMessage
print(type(msg1))  # <class 'langchain_core.messages.human.HumanMessage'>
print(type(msg2))
print(type(msg3))
print(type(msg4))
print(type(msg5))
AIMessage AI消息
AIMessage 代表模型的回复消息。与普通文本不同,AIMessage 包含各种各样的信息,。
from langchain.messages import AIMessage

# 普通 AI 回复(无工具调用)
ai_msg = AIMessage(content="我是一个专业的天气助手。")

# 包含工具调用的 AI 回复
ai_with_tools = AIMessage(
    content="",  # 工具调用时 content 通常为空
    tool_calls=[
        {
            "name": "get_weather",
            "args": {"city": "杭州"},
            "id": "call_abc123",
            "type": "tool_call",
        }
    ]
)
其他格式的 AIMessage
代码中的两种方式都是等价的,都会在 Agent 内部被转换为 AIMessage。
from langchain.messages import AIMessage

# 方式 1:标准构造函数
msg1 = AIMessage(content="我是一个专业的天气助手。")
# 方式2:字典格式数据,表示AI消息
msg2 = {"role": "assistant", "content": "我是一个专业的天气助手。"}
ToolMessage 工具消息
ToolMessage 代表工具执行后的返回结果。它通常包含工具调用的 ID、参数和结果。它必须与AIMessage 中的 tool_call 关联。
from langchain.messages import HumanMessage, AIMessage, ToolMessage
from langchain.chat_models import init_chat_model

# 模拟一轮完整的工具调用对话
messages_history = [
    # 用户消息
    HumanMessage(content="杭州天气怎么样?"),
    # AI消息(包含工具调用)
    AIMessage(
        content="",
        tool_calls=[
            {"name": "get_weather", "args": {"city": "杭州"},
             "id": "call_abc", "type": "tool_call"}
        ]
    ),
    # 工具消息(必须包含 tool_call_id 与上面的 id 对应)
    ToolMessage(
        content="晴,25°C,湿度 60%",
        tool_call_id="call_abc",   # 与 tool_call 的 id 对应
        name="get_weather",        # 工具名称
    ),
]

# 初始化模型对象
model = init_chat_model("deepseek:deepseek-v4-flash")
# 传入消息列表(代表多轮对话历史)
response = model.invoke(messages_history)
# 打印模型回复
print(f"模型基于工具结果的回复: {response.content}")
ToolMessage 的 tool_call_id 必须与 AIMessage 中 tool_call 的 id 精确匹配。如果不匹配,模型可能会忽略这个工具结果,或者产生混乱的行为。
ToolCall 工具调用
ToolCall表示模型调用工具的请求。它通常包含工具调用的 ID、参数和结果。
from langchain.messages import AIMessage
from langchain.messages.tool import ToolCall

# 手动构建一个 ToolCall
tool_call = ToolCall(
    name="get_weather",        # 工具名称
    args={"city": "杭州"},     # 调用参数
    id="call_abc123",         # 唯一标识
    type="tool_call",         # 固定值
)

# AIMessage表示模型回复消息,其中包含 tool_calls,表示模型调用工具的请求。
ai_message = AIMessage(
    content="",               # 有 tool_calls 时 content 通常为空
    tool_calls=[tool_call],
)

print(f"工具名称: {ai_message.tool_calls[0]['name']}")
print(f"调用参数: {ai_message.tool_calls[0]['args']}")
print(f"调用 ID: {ai_message.tool_calls[0]['id']}")
上面代码表示,模型需要调用 get_weather 工具,参数为 {"city": "杭州"},调用 ID 为 call_abc123。
SystemMessage 系统指令消息
SystemMessage 代表一组初始指令,用于设定 AI 的行为、角色和约束。它放在消息列表的最前面,指导模型如何回复。
from langchain.messages import HumanMessage, SystemMessage
from langchain.chat_models import init_chat_model

# 初始化模型对象
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0.7)

# 设置系统指令消息
messages_history = [
    SystemMessage(content="你是一个小红书风格的博主,回复要活泼、使用 emoji、带话题标签"),
    HumanMessage(content="介绍一下你自己。")
]
# 调用模型,传入消息列表(代表多轮对话历史)获取模型回复。
response = model.invoke(messages_history)
# 打印模型回复
print(f"{response.content}")
其他格式的 SystemMessage
代码中的两种方式都是等价的,都会在 Agent 内部被转换为 SystemMessage。
from langchain.messages import SystemMessage

# 方式 1:标准构造函数
msg1 = SystemMessage(content="你是一个专业的天气助手。")
# 方式2:字典格式数据,表示系统消息
msg2 = {"role": "system", "content": "你是一个专业的天气助手。"}
RemoveMessage 删除特定消息
在某些高级场景中,你可能需要从消息历史中删除特定消息(如敏感内容清洗、重新生成回复等)
你可以使用 RemoveMessage 来删除特定消息。RemoveMessage 是一个特殊的消息,它会触发模型在处理时从消息历史中移除指定的消息。
from langchain.messages import HumanMessage, AIMessage, RemoveMessage

# 假设有一段对话
messages = [
    HumanMessage(content="你好", id="msg_1"),
    AIMessage(content="你好!有什么可以帮你的?", id="msg_2"),
    HumanMessage(content="帮我查天气", id="msg_3"),
]

# 使用 RemoveMessage 删除特定消息(通过 ID)
removal = RemoveMessage(id="msg_3")
多模态消息
多模态消息是指包含多种内容类型的消息,如文本、图片、视频等。
注意不是所有的模型都支持多模态消息。如果你用不支持的模型,会收到报错信息。
from langchain.messages import HumanMessage

# 纯文本的用户消息
human_message = HumanMessage("你好。")

# 包含文本和图片的用户消息,方式1 用 content 字段
human_message = HumanMessage(content=[
    {"type": "text", "text": "你好。"},
    {"type": "image_url", "image_url": {"url": "https://example.com/image.jpg"}}
])

# 包含文本和图片的用户消息,方式2 用 content_blocks 字段
human_message = HumanMessage(content_blocks=[
    {"type": "text", "text": "你好。"},
    {"type": "image", "url": "https://example.com/image.jpg"},
])
字典格式的多模态消息
# 纯文本的用户消息
message = {
    "role": "user",
    "content": [
        {"type": "text", "text": "你好。"},
    ]
}

# 包含文本和图片链接的用户消息
message = {
    "role": "user",
    "content": [
        {"type": "text", "text": "你好。"},
        {"type": "image_url", "image_url": "https://example.com/path/to/image.jpg"},
    ]
}

# 包含文本和base64编码图片的用户消息
message = {
    "role": "user",
    "content": [
        {"type": "text", "text": "你好。"},
        {
            "type": "image",
            "base64": "AAAAIGZ0eXBtcDQyAAAAAGlzb21tcDQyAAACAGlzb2...",
            "mime_type": "image/jpeg",
        },
    ]
}
ContentBlock 消息内容块
上面的消息示例都是纯文本消息。我们也可以使用 ContentBlock 来表示更复杂的消息内容。
| 类型 | 说明 | 用途 |
|---|---|---|
| PlainTextContentBlock | 纯文本内容 | 普通文字消息 |
| ImageContentBlock | 图片内容(base64 或 URL) | 多模态模型的图片输入 |
示例
from langchain.messages import HumanMessage
from langchain.messages import PlainTextContentBlock, ImageContentBlock

# content 也可以是 ContentBlock 列表(复杂消息)
# 即多种内容类型的列表组合
complex_msg = HumanMessage(content=[
    PlainTextContentBlock(text="这张图片里是什么?"),
    # 图片可以是 URL 或 base64 编码
    ImageContentBlock(
        url="https://example.com/photo.jpg"
    ),
])

# 调用模型,传入消息列表(代表多轮对话历史)获取模型回复。
response = model.invoke(complex_msg)
# 打印模型回复
print(f"{response.content}")
工具
在LangChain中,工具本质是可调用函数,具有明确定义的输入和输出。
模型可以根据对话上下文决定何时调用工具以及提供哪些输入参数。
@tool 装饰器(定义工具)
@tool 是 LangChain 提供的装饰器,你可以将任何 Python 函数快速转换为可调用的工具。
用法极其简单:在函数上加上 @tool 装饰器,函数就变成了一个工具。
示例
from langchain.tools import tool

# 最简单的工具:一个普通函数 + @tool 装饰器
@tool
def hello_tool(name: str) -> str:
    """向指定的人打招呼。
    Args:
        name: 要打招呼的人的名字
    """
    return f"你好! {name}"

@tool("hello_tool_new")
def hello_tool2(name: str) -> str:
    """向指定的人打招呼。
    Args:
        name: 要打招呼的人的名字
    """
    return f"你好! {name}"
注意:
- 工具函数的参数的类型提示是必须的,因为这规定了工具的输入参数的类型。
- 工具函数的返回参数的类型提示是必须的,因为这规定了工具的输出参数的类型。
- 工具函数的文档字符串会自动成为工具的描述。模型会主动读取工具函数的文档字符串,从而理解工具的用途。因此,工具函数的文档字符串应该简洁明了,能够清晰描述工具的功能。
自定义工具名词, 自定义工具描述
- 默认情况下,工具名称来自函数名。当您需要更具描述性的名称时,可以用name_or_callable参数来覆盖它。
- description 参数可以自定义工具的描述。
示例。自定义工具名称为AAA。
from langchain.tools import tool

@tool(name_or_callable="AAA", description="这是一个新的自定义描述")
def hello_tool(name: str) -> str:
    """向指定的人打招呼。
    Args:
        name: 要打招呼的人的名字
    """
    return f"你好! {name}"
工具绑定到模型上(bind_tools() 方法)
当我们定义好工具之后,可以将工具绑定到模型上。模型会根据对话上下文,判断是否调用工具以及提供哪些输入参数。
注意 bind_tools() 方法会将工具绑定到模型上,但是这只是告诉模型"你有一个工具可以用",当模型判断需要调用工具时,会返回工具调用的请求。真正的执行由 Agent 或你自己编写的代码来完成。
示例代码
# 创建 Agent
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.tools import tool
from langchain.messages import HumanMessage

# 定义天气查询工具
@tool
def get_weather(city: str) -> str:
    """查询指定城市的天气情况。
    Args:
        city: 城市名称,如 "杭州"、"北京"
    """
    # 这里用模拟数据演示
    weather_data = {
        "杭州": "晴,25°C,湿度 60%",
        "北京": "多云,18°C,湿度 45%",
        "上海": "小雨,22°C,湿度 80%",
    }
    if weather_data.get(city) is not None:
        return weather_data.get(city)
    else:
        return "暂无该城市天气数据"

# 初始化模型对象
model = init_chat_model(
    api_key="sk-xxx",  # 阿里云大模型的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 阿里云大模型的API地址
    model="openai:qwen-plus",
)

# 绑定工具到模型
model_with_tools = model.bind_tools([get_weather])
# 调用模型
response = model_with_tools.invoke("杭州今天天气怎么样?")

# 检查模型是否请求调用工具
if response.tool_calls:
    print("模型请求调用以下工具:")
    for tc in response.tool_calls:
        print(f"  工具名: {tc['name']}")
        print(f"  参数: {tc['args']}")
        print(f"  调用ID: {tc['id']}")
else:
    print(f"模型直接回复: {response.content}")

# 运行结果
# 模型请求调用以下工具:
#   工具名: get_weather
#   参数: {'city': '杭州'}
#   调用ID: call_872a234d01654cdf817751bc
从运行结果上看,可以发现模型并没有真正执行 get_weather 工具函数。而是返回了调用 get_weather 工具函数 的请求。