[toc]
LangChain笔记2
Agent 智能体
Agent 是将模型与工具相结合,创建能够推理任务、决定使用哪些工具并迭代地寻找解决方案的系统。
什么是Agent?
普通的模型调用是一问一答。而Agent 则不同,Agent 的核心是一个简单的循环:调用模型 → 检查是否需要工具 → 执行工具 → 重复。直到模型不再请求工具调用,Agent 停止并返回最终结果。
举个例子,如果你问"今天天气怎么样?",普通模型只能回答训练数据中的天气(可能是几个月前的)。而 Agent 会主动调用天气查询工具获取实时数据,然后基于真实数据回答你。
Agent的执行流程?
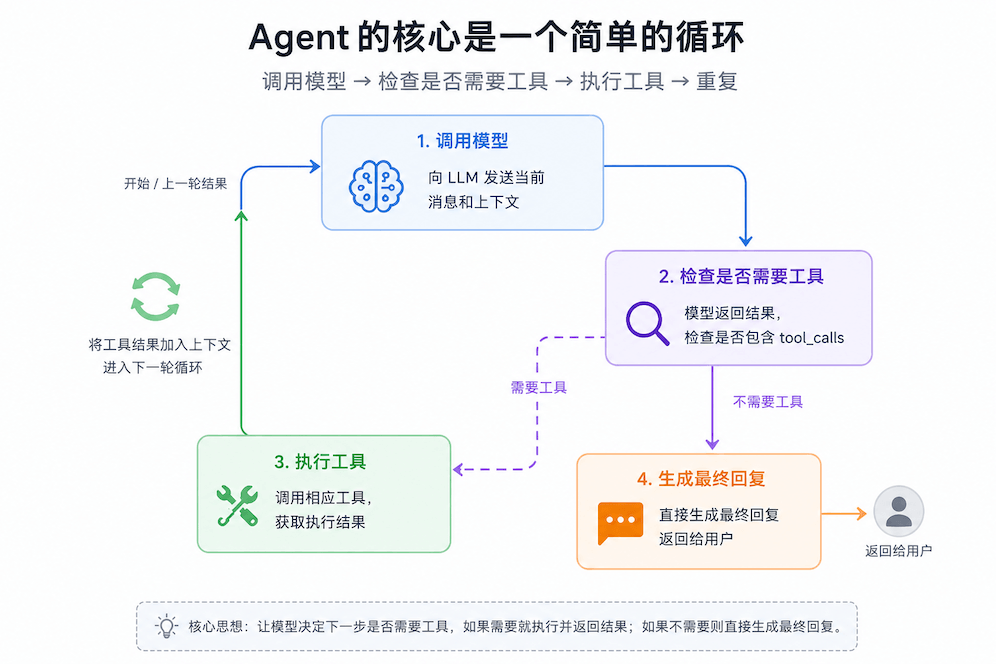
从图中可以看到,Agent 智能体是一个循环过程。它会根据模型的回复,自行判断是否继续调用工具。如果需要,它会继续调用工具,直到得出最终答案。
创建 Agent(create_agent 方法)
create_agent() 是 LangChain 最核心的函数,它会创建一个完整的 Agent ,包含模型调用、工具执行、循环控制等全部逻辑。
语法
from langchain.agents import create_agent

agent = create_agent(
    model,                     # str | BaseChatModel:语言模型
    tools=None,                # Sequence:工具列表
    *,
    system_prompt=None,        # str | SystemMessage:系统提示
    middleware=None,             # Sequence[AgentMiddleware]:中间件列表
    response_format=None,      # ResponseFormat | type:结构化输出配置
    state_schema=None,         # type[AgentState]:自定义状态结构
    context_schema=None,       # type:运行时上下文结构
    checkpointer=None,         # Checkpointer:对话持久化
    store=None,                # BaseStore:跨会话存储
    interrupt_before=None,     # list[str]:在哪些节点前暂停
    interrupt_after=None,      # list[str]:在哪些节点后暂停
    debug=False,               # bool:是否输出详细日志
    name=None,                 # str:Agent 名称
    cache=None,                # BaseCache:缓存配置
)
部分参数说明
- model:Agent 要绑定的聊天模型。接受两种类型。”供应商:模型名称“的字符串或 BaseChatModel 实例。
- tools:Agent 要使用的工具列表。如果为 None 或空列表,则Agent没有工具调用。
- system_prompt:定义 Agent 的行为角色和约束规则。支持字符串和 SystemMessage 对象。
- middleware:中间件列表。中间件可以在各个阶段拦截和修改Agent行为。
- response_format:定义 Agent 输出的结构化格式。支持 ResponseFormat 对象和 type 类型。
- name :Agent 的名称。当将Agent作为节点添加到另一个图时,将自动使用此名称。对于构建多Agent系统特别有用。
create_agent() 方法的返回值
create_agent() 返回一个 CompiledStateGraph 对象,这是 LangGraph 的编译后的图,提供了多种运行方式。
| 方法 | 说明 | 适用场景 |
|---|---|---|
| invoke(input, config) | 同步运行,等待完整结果 | 脚本、简单接口 |
| ainvoke(input, config) | 异步运行,等待完整结果 | Web 服务 |
| stream(input, config, stream_mode) | 同步流式运行 | 实时展示中间步骤 |
| astream(input, config, stream_mode) | 异步流式运行 | WebSocket、SSE |
调用 Agent(invoke 方法)
创建并调用Agent只需要三步:(1) 定义模型,定义工具;(2) 创建 Agent,并绑定模型和工具;(3) 调用Agent。
示例
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.tools import tool
from langchain.messages import HumanMessage

# 定义天气查询工具
@tool
def get_weather(city: str) -> str:
    """查询指定城市的天气情况。
    Args:
        city: 城市名称,如 "杭州"、"北京"
    """
    # 这里用模拟数据演示
    weather_data = {
        "杭州": "晴,25°C,湿度 60%",
        "北京": "多云,18°C,湿度 45%",
        "上海": "小雨,22°C,湿度 80%",
    }
    if weather_data.get(city) is not None:
        return weather_data.get(city)
    else:
        return "暂无该城市天气数据"

# 初始化模型对象
model = init_chat_model(
    api_key="sk-xxx",  # 阿里云大模型的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 阿里云大模型的API地址
    model="openai:qwen-plus",  # 模型名称
)

# 创建 Agent,传入模型和工具列表
agent = create_agent(
    model=model,
    tools=[get_weather],
    system_prompt="你是一个乐于助人的助手,会使用工具来回答问题。",
)

inputs = {"messages": [HumanMessage(content="武汉今天天气怎么样?")]}

# invoke() 运行 Agent,返回最终状态
response = agent.invoke(inputs)

# 完整的响应内容
print(response)
# 最后一条 AI 消息就是最终答案
print(response["messages"][-1].content)
代码执行流程解析
上面这个例子的完整执行过程如下:
- 用户发送消息。 例如 "武汉今天天气怎么样?"
- 模型收到消息后判断:需要查询天气 → 返回一个 tool_call(调用 get_weather,参数 city="武汉")
- Agent 执行 get_weather 工具 → 返回 "暂无该城市天气数据"
- 模型收到工具结果 → 判断任务完成 → 生成最终回复
system_prompt 提示词参数
create_agent() 的 system_prompt 参数接受两种形式:字符串和 SystemMessage 对象。
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import SystemMessage
# 初始化模型对象
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

# 方式 1:字符串(最简单)
agent = create_agent(
    model=model,
    system_prompt="你是一个学习顾问,回答要简洁专业。",
)

# 方式 2:SystemMessage 对象(可复用)
system_msg = SystemMessage(
    content="你是一个学习顾问,回答要简洁专业。"
)
agent = create_agent(model=model, system_prompt=system_msg)
response_format参数 结构化输出
有时候,我们希望 Agent 输出的不是简单的文本,而是结构化数据。这样可以方便我们快速的进行数据处理和分析。
方式1:使用 Pydantic 模型
response_format 参数支持接收 Pydantic 模型作为参数。此时模型的输出会被自动转换为该模型的实例。
示例
from typing import List

from langchain.agents.structured_output import ToolStrategy
from pydantic import BaseModel, Field
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage

# 定义期望的输出结构
class UserInfo(BaseModel):
    name: str = Field(description="名字")
    age: int = Field(description="年龄")
    country:str = Field(description="国籍")
    number:int = Field(description="球衣号码")
    desc:str = Field(description="简短介绍")

class UserList(BaseModel):
    user_list: List[UserInfo]

# 初始化模型对象
model = init_chat_model(
    api_key="sk-xxx",  # 阿里云大模型的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 阿里云大模型的API地址
    model="deepseek:deepseek-v4-flash",  # 模型
)
# 绑定工具
agent = create_agent(
    model=model,
    response_format=UserList,  # 传入 Pydantic 模型
    system_prompt="你是AI助手",
)

inputs = {"messages": [HumanMessage(content="我最近看2022年世界杯,帮我介绍一下这次世界杯上排名前五的5个球星。")]}

# 用户输入一段非结构化的描述
response = agent.invoke(inputs)

print(f"响应数据 response: {response}")

# 如果有结构化结果数据
if "structured_response" in response :
    # 获取结构化数据
    info = response["structured_response"]
    print(f"结构化数据: {info}")
    # 判断是否是 UserList 类型
    if isinstance(info, UserList):
        for user in info.user_list:
            print(f"名字: {user.name}")
            print(f"年龄: {user.age}")
            print(f"国家: {user.country}")
            print(f"球衣号码: {user.number}")
            print(f"简短介绍: {user.desc}")
            print("-----------------")
structured_response 获取结构化输出结果
当create_agent() 方法中使用 response_format 参数时,Agent 会将结构化输出存储在 structured_response 字段中。
# 绑定工具到模型
agent = create_agent(
    model=model,
    response_format=UserInfo,  # 传入 Pydantic 模型
    system_prompt="你是AI助手",
)
# 调用 Agent 运行任务
response = agent.invoke(xxx)
# 如果有结构化结果数据
if "structured_response" in response :
    # 获取结构化数据
    print(f"结果化输出结果: {response["structured_response"]}")
流式输出(stream 方法)
流式输出让 AI 的回复像打字一样逐字显示,极大地提升了用户体验。LangChain 的 Agent 内置了完善的流式输出支持。
为什么需要流式输出?
- 如果使用 invoke(),用户需要等待 Agent 完成所有步骤(多次模型调用 + 工具执行)才能看到结果。对于复杂任务,这可能耗时十几秒甚至更长。
- 提升用户体验:用户可以实时看到模型的思考过程,增加互动性。
- 适合长文本生成:如翻译、摘要、代码生成等,流式输出可以避免一次生成所有内容,提高效率。
- 适合实时应用:如聊天机器人、游戏、教育等等,需要实时反馈。
流式输出的种类
- stream_mode="messages"——逐 Token 流式输出,每个 Token 都会立即显示在用户界面。
- stream_mode="updates"——逐步查看 Agent 执行过程,包括模型调用、工具调用、中间结果等。
stream_mode="messages" 逐 Token 流式输出
stream_mode="messages" 逐 Token 流式输出的效果就是模型的回复会逐字显示在用户界面。
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage

# 创建 Agent 并绑定模型
model = init_chat_model(
    api_key="sk-xxx",  # 阿里云大模型的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 阿里云大模型的API地址
    model="openai:qwen3.7-plus",  # 模型
)
agent = create_agent(
    model=model,
    system_prompt="你是AI助手。",
)

# 创建 HumanMessage
human_msg = HumanMessage(content="详细介绍你自己")

# stream_mode="messages" 逐 Token 流式输出
print("实时流式输出:")
for msg_chunk, metadata in agent.stream({"messages": [human_msg]},stream_mode="messages"):
    # msg_chunk 是 AIMessageChunk
    # 每个 chunk 只包含一小段内容
    if msg_chunk.content:
        print(msg_chunk.content, end="", flush=True)
metadata 是一个字典,包含了当前 chunk 的元信息,包含了当前 chunk 的模型调用 ID、工具调用 ID 等。
stream_mode="updates"
stream_mode="updates" 逐步查看 Agent 执行过程,包括模型调用、工具调用、中间结果等。
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage

# 创建 Agent 并绑定模型
model = init_chat_model(
    api_key="sk-xxx",  # 阿里云大模型的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 阿里云大模型的API地址
    model="openai:qwen3.7-plus",  # 模型
)
agent = create_agent(
    model=model,
    system_prompt="你是AI助手。",
)

# 创建 HumanMessage
human_msg = HumanMessage(content="详细介绍你自己")

# 使用 stream_mode="updates" 模式查看每一步
print("=== Agent 执行过程 ===\n")
for chunk in agent.stream({"messages": [human_msg]},stream_mode="updates"):
    for node_name, update in chunk.items():
        print(f"[{node_name}]", end=" ")
        if "messages" in update:
            for msg in update["messages"]:
                if msg.type == "ai":
                    if hasattr(msg, 'tool_calls') and msg.tool_calls:
                        calls = [tc['name'] for tc in msg.tool_calls]
                        print(f"请求调用: {calls}")
                    elif msg.content:
                        print(f"回复: {msg.content[:80]}")
                elif msg.type == "tool":
                    print(f"工具返回 [{msg.name}]: {msg.content}")
中间件
Middleware(中间件)是 LangChain 最强大的特性。它让你在 Agent 执行的各个环节插入自定义逻辑,实现重试、降级、缓存、内容过滤、日志记录等功能——而不需要修改 Agent 本身的代码。
中间件的作用
Middleware 是 Agent 执行流程中的钩子(Hook)。每个钩子让你在特定的时间点执行自定义代码:
# Middleware 的直观理解:
# 假设 Agent 的执行流程是这样的:

# 1. 用户输入 → 2. 模型思考 → 3. 可能调用工具 → 4. 模型再思考 → 5. 输出结果

# Middleware中间件 让你可以在这 5 个环节之间插入自定义逻辑:
# 1. 用户输入
#    ↓ [before_agent 钩子:日志记录、权限检查]
# 2. 模型思考
#    ↓ [before_model 钩子:消息预处理]
#    ↓ [wrap_model_call 钩子:重试、降级、缓存]
#    ↓ [after_model 钩子:内容审核]
# 3. 工具执行
#    ↓ [wrap_tool_call 钩子:工具调用重试]
# 4. 回到模型思考(循环直到完成)
#    ↓ [after_agent 钩子:结果格式化、统计分析]
# 5. 输出结果
如图所示是 Agent 执行过程中,中间件的执行顺序。 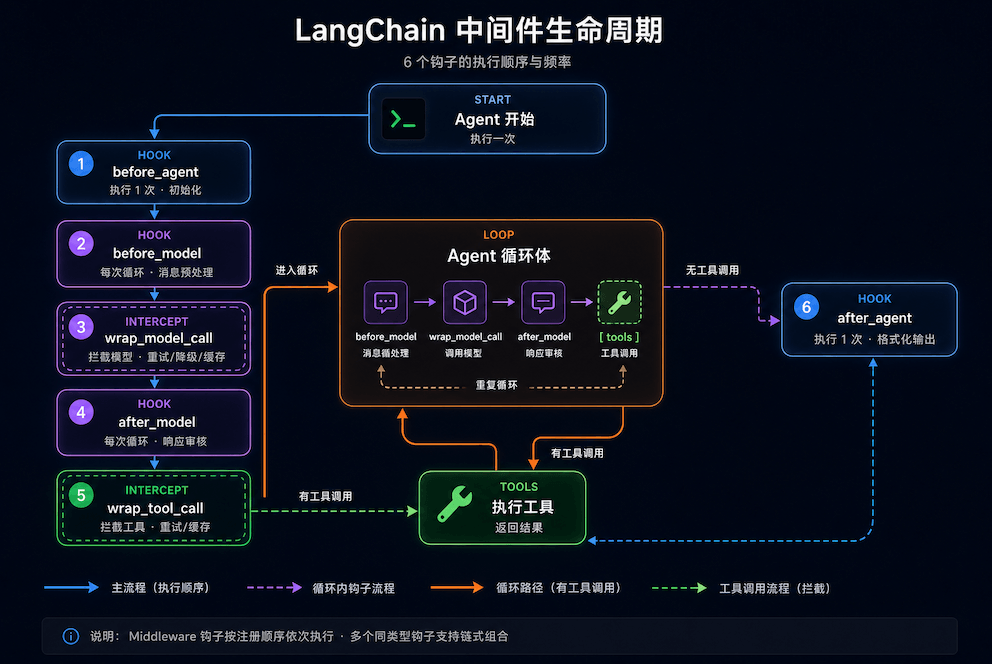
Middleware 提供了 6 个钩子,按执行时机分为两类:
| 钩子 | 执行频率 | 执行位置 | 主要用途 |
|---|---|---|---|
| before_agent | 一次 | Agent 开始前 | 初始化、权限检查、输入预处理 |
| before_model | 每次循环 | 模型调用前 | 消息预处理、动态上下文注入 |
| wrap_model_call | 每次循环 | 包裹模型调用 | 重试、降级、缓存、请求改写 |
| after_model | 每次循环 | 模型调用后 | 内容审核、响应过滤、日志 |
| wrap_tool_call | 每次工具调用 | 包裹工具执行 | 工具重试、结果缓存、参数改写 |
| after_agent | 一次 | Agent 结束后 | 格式化输出、统计、清理资源 |
创建中间件
通过装饰器方式创建中间件,或者通过类方式创建中间件。
装饰器方式,适合简单逻辑,推荐
from langchain.agents.middleware import before_model, after_model

# 装饰器方式:简单、直观
@before_model
def log_before(state, runtime):
    """在每次模型调用前记录日志"""
    msg_count = len(state.get("messages", []))
    print(f"[before_model] 当前消息数: {msg_count}")
    return None

@after_model
def log_after(state, runtime):
    """在每次模型调用后记录日志"""
    last_msg = state["messages"][-1] if state.get("messages") else None
    if last_msg and hasattr(last_msg, 'tool_calls') and last_msg.tool_calls:
        print(f"[after_model] 模型请求了工具调用")
    return None
类方式,适合复杂业务逻辑
from langchain.agents.middleware import BaseMiddleware

"""自定义日志中间件"""
class LoggingMiddleware(AgentMiddleware):
    @property
    def name(self) -> str:
        # 自定义中间件名称(默认是类名)
        return "logging"

    def before_agent(self, state, runtime):
        """Agent 开始前的逻辑"""
        print("[Logging] Agent 开始执行")
        return None

    def before_model(self, state, runtime):
        """模型调用前的逻辑"""
        msg_count = len(state.get("messages", []))
        print(f"[Logging] 准备调用模型,当前 {msg_count} 条消息")
        return None

    def after_model(self, state, runtime):
        """模型调用后的逻辑"""
        print("[Logging] 模型调用完成")
        return None

    def after_agent(self, state, runtime):
        """Agent 结束后的逻辑"""
        print("[Logging] Agent 执行结束")
        return None
使用中间件
from langchain.agents import create_agent
from langchain.agents.middleware import before_agent, before_model, after_agent
from langchain.chat_models import init_chat_model
from langchain_core.messages import HumanMessage


@before_agent
def start_log(state, runtime):
    """Agent 开始前"""
    print(">>> [before_agent] Agent 开始 <<<")
    return None

@after_agent
def end_log(state, runtime):
    """Agent 结束后"""
    print(f"<<< [after_agent] Agent 结束<<<")
    return None


# 初始化模型对象
model = init_chat_model(
    api_key="sk-xxx",  # 阿里云大模型的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 阿里云大模型的API地址
    model="openai:qwen3.7-plus",  # 模型
)
# 绑定工具
agent = create_agent(
    model=model,
    system_prompt="你是AI助手",
    middleware=[start_log, end_log],
)
# 初始化消息历史
message_history = {"messages": [HumanMessage(content="请介绍你自己")]}

# 测试一下
response = agent.invoke(message_history)
print(response)
@before_model 与 @after_model 中间件钩子
before_model 和 after_model 是最常用的两个 中间件(Middleware) 钩子。它们在每次模型调用前后执行,适合做内容过滤、消息预处理、响应审核等。
@before_agent 与 @after_agent 中间件钩子
before_agent 和 after_agent 是 Agent 级别的钩子,分别在 Agent 执行之前和完成之后各执行一次。适合做初始化、预处理、后处理和统计分析。
多 Agent 智能体
当一个任务太复杂,单个 Agent 难以胜任时,你可以创建多个各司其职的 Agent,让它们像团队一样协作。
为什么需要多个 Agent 智能体?
- 如果一个复杂的任务,全部由一个 Agent 来完成,可能会因为任务复杂度高而失败。
- 复杂任务分解:将一个复杂任务分解成多个子任务,每个子任务由一个 Agent 来负责。
- 任务分配:根据任务的性质和复杂度,将任务分配给不同的 Agent,以提高效率。
- 协作:多个 Agent 可以通过协作来完成任务,例如通过分享信息、协调决策等。
多 Agent 智能体的架构方式
| 模式 | 结构 | 适用场景 |
|---|---|---|
| 协调者模式 | 一个父 Agent → 多个子 Agent 工具 | 任务类型明确可分类 |
| 接力模式 | Agent A 的输出 → Agent B 的输入 | 流水线式处理(生成→审核→润色) |
| 辩论模式 | 多个 Agent 并行输出 → 汇总决策 | 需要多角度分析的问题 |
方式1:创建父子 Agent,然后通过协作完成任务。
from langchain.tools import tool
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage

model = init_chat_model(
    api_key="sk-XXX",  # 阿里云大模型的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 阿里云大模型的API地址
    model="openai:qwen3.7-plus" # 模型
)


@tool
def weather_tool(city: str) -> str:
    """查询天气工具"""
    data = {"杭州": "晴,25°C", "北京": "多云,18°C","武汉": "暴雨,18°C"}
    return data.get(city, f"{city}: 数据暂缺")

# 子 Agent 1:天气专家
weather_agent = create_agent(
    model=model,
    tools=[weather_tool],
    name="weather_expert",  # 名字用于标识和日志
    system_prompt="你是天气专家,专门回答天气相关问题。回答要简洁。",
)


@tool
def calculate_tool(expression: str) -> str:
    """计算数学表达式"""
    result = eval(expression, {"__builtins__": {}}, {})
    return f"{expression} = {result}"

# 子 Agent 2:计算专家
math_agent = create_agent(
    model=model,
    tools=[calculate_tool],
    name="math_expert",
    system_prompt="你是数学专家,专门进行数学计算。回答要简洁。",
)


@tool
def ask_weather_expert(question: str) -> str:
    """向天气专家咨询天气相关问题。
    Args:
        question: 关于天气的问题
    """
    result = weather_agent.invoke(
        {"messages": [HumanMessage(content=question)]}
    )
    return result["messages"][-1].content


@tool
def ask_math_expert(question: str) -> str:
    """向数学专家咨询数学计算问题。
    Args:
        question: 数学计算问题
    """
    result = math_agent.invoke(
        {"messages": [HumanMessage(content=question)]}
    )
    return result["messages"][-1].content

# 父 Agent:协调者
coordinator = create_agent(
    model=model,
    tools=[ask_weather_expert, ask_math_expert],
    system_prompt="""你是协调助手。根据用户问题选择合适的专家:
                    - 天气相关问题 → 使用 ask_weather_expert
                    - 数学计算问题 → 使用 ask_math_expert
                    - 如果同时涉及多个领域,依次咨询各个专家
                   """,
)

# 测试复合问题
result = coordinator.invoke({
    "messages": [HumanMessage(
        content="武汉今天天气怎么样?换算成华氏度是多少?"
        "(公式:华氏度 = 摄氏度 × 9/5 + 32)"
    )]
})
print(result["messages"][-1].content)
对话记忆 Checkpointer
默认情况下,每次 agent.invoke() 都是独立的——Agent 不记得之前聊过什么。
# ......省略部分代码

# 第一轮
result1 = agent.invoke({"messages": [HumanMessage(content="我叫小明")]})
print(f"第一轮: {result1['messages'][-1].content}")

# 第二轮——Agent 不记得第一轮的内容!
result2 = agent.invoke({"messages": [HumanMessage(content="我叫什么名字?")]})
print(f"第二轮: {result2['messages'][-1].content}")

# 运行结果
# 第一轮: 你好小明!很高兴认识你。
# 第二轮: 抱歉,我没有你的信息,不知道你叫什么名字。
但是我们可以使用 Checkpointer 来实现对话记忆。Checkpointer(检查点保存器)可以让 Agent 能够记住对话历史,实现真正的多轮对话。
Agent 搭配 Checkpointer
注意:checkpoint 是 langgraph包中,是langgraph 提供的一种机制,用于在不同对话之间共享数据。
from langgraph.checkpoint.memory import InMemorySaver
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage

# 创建一个内存保存器,通过内存快速存储数据
inmemory_saver = InMemorySaver()

# 初始化模型
model = init_chat_model(
    api_key="sk-XXX",  # 阿里云大模型的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 阿里云大模型的API地址
    model="deepseek:deepseek-v4-flash",  # 模型
)
# 初始化 Agent
agent = create_agent(
    model=model,
    checkpointer=inmemory_saver,  # Checkpointer参数,传入内存保存器。表示Agent的Checkpointer会使用内存保存器来进行存储数据。
    system_prompt="你是AI助手。",
)

# 创建 config配置,使用 thread_id 来标识  用户user-001的对话线程
user_001_config = {"configurable": {"thread_id": "user-001"}}

# 第一轮对话,传入config配置
result1 = agent.invoke(
    {"messages": [HumanMessage(content="我叫小明,我在学 Python")]},
    config=user_001_config,
)
print(f"第一轮: {result1['messages'][-1].content}")

# 第二轮对话,传入相同的config配置,Agent会记住相同config配置的对话线程
result2 = agent.invoke(
    {"messages": [HumanMessage(content="我叫什么名字?我在学什么?")]},
    config=user_001_config,
)
print(f"第二轮: {result2['messages'][-1].content}")

# 运行结果
# 第一轮: 你好,小明!很高兴认识你~🎉 学习 Python 是一条超棒的路,它简单易上手,又能做出很酷的东西。😊
# 第二轮: 你叫小明,正在学 Python!😄
代码中的thread_id 是关键。同一个 thread_id 下的对话是连续的,不同 thread_id 之间的对话完全隔离。通过这种方式从而让Agent 记住用户之前聊过什么,实现真正的多轮对话。
checkpointer 的工作流程
在上面代码中,主要是四个步骤:
- 创建一个内存保存器,用于存储对话记忆数据。
- 初始化 Agent,设置Checkpointer参数,并且参数值是内存保存器。表示 Agent 的 Checkpointer 会使用内存保存器来进行存储数据。
- 创建 config 配置,使用 thread_id 来标识 用户user-001的对话线程。
- 第一轮对话,Agent调用时传入 config 配置,Agent 会记住相同 config 配置的对话线程。
- 第二轮对话,传入相同的 config 配置,Agent 会记住相同 config 配置的对话线程。
其中最重要的是第 2 步骤。因为Agent 使用了Checkpointer,所以每次 Agent 执行后自动保存数据到 Checkpointer 指向的数据存储中。下一次使用相同 thread_id 调用时,会自动从数据存储中获取之前的历史数据,从而实现对话记忆。
Checkpointer 的类型
Checkpointer 有多种类型,包括:
- 内存保存器(InMemorySaver):将对话记忆数据存储在内存中,适用于小规模对话。无法持久化存储。适用于开发调试、测试场景。
- 数据库保存器(SqliteSaver):将对话记忆数据存储在 SQLite 数据库中,支持持久化存储。适用于单机部署、小规模应用。
- 数据库保存器(PostgresSaver):将对话记忆数据存储在 PostgreSQL 数据库中,支持持久化存储。适用于生产环境、多实例共享场景。
示例代码
from langgraph.checkpoint.sqlite import SqliteSaver

# SQLite 持久化——重启后数据不丢失。 数据库文件会自动创建。
sqlite_saver = SqliteSaver.from_conn_string("conversations.db")

# 初始化 Agent,设置Checkpointer参数,并且参数值是数据库保存器。表示 Agent 的 Checkpointer 会使用数据库保存器来进行存储数据。
agent = create_agent(
    model="deepseek:deepseek-v4-flash",
    checkpointer=sqlite_saver,
)

# 用法和 InMemorySaver 完全相同
config = {"configurable": {"thread_id": "user-001"}}
result = agent.invoke(
    {"messages": [{"role": "user", "content": "你好"}]},
    config=config,
)

# 重启程序后,相同 thread_id 的对话依然存在
跨对话记忆 Store
Checkpointer 解决了"单个对话内记忆"的问题。但如果你需要在不同对话之间共享数据——比如用户偏好、学习进度——就需要用到 Store。
store 也是 langgraph 提供的一种机制,用于在不同对话之间共享数据。
Checkpointer 和 Store 的区别?
| 维度 | Checkpointer | Store |
|---|---|---|
| 作用 | 单个对话线程(thread_id) | 跨所有对话线程 |
| 数据类型 | Agent 状态快照(自动管理) | 任意键值数据(手动管理) |
| 典型用途 | 多轮对话记忆 | 用户偏好、知识库、配置 |
| 数据组织 | thread_id → checkpoint | (namespace, key) → value |
注意:Store 使用 命名空间 + 键 的层级结构来组织数据。命名空间用于分组数据,键名用于唯一标识数据项。
Store 的基本操作
Store 创建和写入数据
通过put方法写入数据,需要传入命名空间、键名和值。如果键名已存在,会覆盖旧值。如果键名不存在,会创建新项。
from langgraph.store.memory import InMemoryStore
# 初始化内存存储Store
store = InMemoryStore()

# 写入数据方法: put(namespace, key, value)
# namespace 是元组,key 是字符串,value 是字典
store.put(
    ("users", "user_001"),            # 第一个参数是命名空间,元组类型
    "preferences",                    # 第二个参数是键名,字符串类型
    {                                 # 第三个参数是值,字典类型
        "theme": "dark",
        "language": "zh-CN",
        "level": "入门",
    }
)
# 写入数据方法: put(namespace, key, value)
store.put(
    ("users", "user_001"),            # 第一个参数是命名空间,元组类型
    "progress",                       # 第二个参数是键名,字符串类型
    {                                 # 第三个参数是值,字典类型
        "completed_courses": ["HTML 基础", "Python 基础"],
        "total_hours": 35,
    }
)
Store 的读取操作
通过get方法读取数据,需要传入命名空间和键名,返回对应的值。如果键名不存在,返回None。
from langgraph.store.memory import InMemoryStore
store = InMemoryStore()
# 读取数据:get(namespace, key)  传入命名空间和键名,获取对应的值
prefs = store.get(("users", "user_001"), "preferences")
print(f"偏好设置: {prefs.value}")

progress = store.get(("users", "user_001"), "progress")
print(f"学习进度: {progress.value}")
Store 的搜索操作
search方法搜索数据,需要传入命名空间,返回该命名空间下的所有键值对。
# 搜索数据:search(namespace)
all_user_data = store.search(("users", "user_001"))
print(f"\n用户的所有数据 ({len(all_user_data)} 项):")
for item in all_user_data:
    print(f"  {item.key}: {item.value}")
Store 的删除操作
delete方法删除数据,需要传入命名空间和键名。如果键名不存在,不会报错。如果键名存在,会删除对应的项。
# 删除数据:delete(namespace, key)
store.delete(("users", "user_001"), "preferences")
Agent 搭配 Store
from typing import Annotated
from langgraph.store.base import BaseStore
from langgraph.store.memory import InMemoryStore
from langchain.tools import tool, InjectedStore
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage

# 创建 Store 并预置数据
store = InMemoryStore()
# 存储会员信息
store.put(("AAA", "users"), "user_vip_001", {
    "name": "小明",
    "membership": "VIP",
    "joined": "2024-01-15",
})


@tool
def get_user_membership(user_id: str,store: Annotated[BaseStore, InjectedStore()]) -> str:
    """查询用户会员信息。
    Args:
        user_id: 用户 ID
    """
    item = store.get(("AAA", "users"), user_id)
    if item is None:
        return f"未找到用户 {user_id}"

    user = item.value
    return (
        f"用户 {user['name']},{user['membership']} 会员,"
        f"注册日期 {user['joined']}"
    )

# 创建 Agent
agent = create_agent(
    model= init_chat_model("XXX", temperature=0),
    tools=[get_user_membership],
    store=store,
    system_prompt="你是AI助手。",
)

# 查询用户信息(数据来自 Store)
result = agent.invoke({
    "messages": [HumanMessage(content="帮我查一下用户 user_vip_001 的信息")]
})
print(f"查询用户: {result['messages'][-1].content}")

# 运行结果
# 查询用户: 用户小明是 VIP 会员,注册日期为 2024年1月15日。
上面代码中,将create_agent()方法使用store参数后,Agent 中的所有工具都能通过 InjectedStore 访问它store参数指向的数据存储。
只需要在工具参数中添加store参数,即可访问store参数指向的数据存储。
# 工具形参中添加一个store参数,即可访问store参数指向的数据存储
@tool
def test(user_id: str,store: Annotated[BaseStore, InjectedStore()])
Store的类型
InMemoryStore 的数据在程序重启后丢失。生产环境可以使用 PostgresStore 等持久化方案:
- InMemoryStore:内存存储器,用于在内存中存储数据。
- RedisStore:Redis 存储器,用于将 Redis 作为存储介质。
- PostgresStore:Postgres 存储器,用于将 Postgres 作为存储介质。支持持久化存储。
示例代码
from langgraph.store.postgres import PostgresStore
store = PostgresStore(
    conn_string="postgresql://user:password@localhost:5432/langgraph",
    table_name="langgraph",
    schema="public",
)
人工介入(HITL,Human-in-the-Loop)
在生产环境中,有些操作需要人工确认。比如发送邮件、执行删除、处理支付。人工介入可以让 Agent 在关键时刻暂停,等待人工审批后继续。
interrupt() 函数
interrupt() 函数可以让工具执行到一半时暂停,等待外部输入后再继续。
注意:Agent必须使用 checkpointer 才能支持 interrupt() 函数。否则,中断点将无法持久化存储。
示例代码
from langgraph.types import interrupt, Command
from langgraph.checkpoint.memory import InMemorySaver
from langchain.tools import tool
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage

@tool
def delete_course(course_name: str) -> str:
    """删除课程(需要审批)。
    Args:
        course_name: 要删除的课程名称
    """
    # 暂停并等待审批
    approval = interrupt({
        "action": "delete_course",
        "course": course_name,
        "message": f"确认删除课程《{course_name}》?此操作不可撤销。"
    })

    if approval.get("confirmed"):
        return f"课程《{course_name}》已删除"
    else:
        return f"删除操作已取消"

# 初始化 Agent
agent = create_agent(
    model=init_chat_model(
        api_key="sk-XXX",  # 阿里云大模型的API key
        base_url="XXX",  # 阿里云大模型的API地址
        model="deepseek:deepseek-v4-flash",  # 模型
    ),
    tools=[delete_course],
    checkpointer=InMemorySaver(),  # checkpoint用内存进行存储
    system_prompt="你是AI助手。",
)

# 会话配置
config = {"configurable": {"thread_id": "admin-001"}}

# 第一步:发起删除请求(会触发中断)
print("=== 开始执行 ===")
result = agent.invoke(
    {"messages": [HumanMessage(content="请删除 hBASE 课程")]},
    config=config,
)

# 检查 Agent 是否暂停了
state = agent.get_state(config)
print(f"状态: {state.next}")  # ('tools',) 表示在 tools 节点暂停
print(f"中断信息: {state.tasks[0].interrupts}")

# 第二步:人工审批(模拟用户点击"确认")
print("\n=== 人工审批 ===")
resume_value = {"confirmed": True, "operator": "管理员张三"}
result = agent.invoke(
    Command(resume=resume_value),
    config=config,
)
print(f"最终回复: {result['messages'][-1].content}")
interrupt() 的工作流程:
- 工具调用 interrupt() → Agent 暂停执行
- 获取中断信息,包括中断类型、中断参数等
- 用户做出决定后,再次调用Agent 通过 Command(resume=...)参数 将用户审批的值
confirmed传递给 interrupt() 函数 - interrupt() 函数根据用户传递的审批值
confirmed,来判断是否继续执行
interrupt_before / interrupt_after 参数
create_agent 方法的 interrupt_before / interrupt_after 参数,可以在工具执行前或执行后,插入全局中断点。
示例代码
from langgraph.checkpoint.memory import InMemorySaver

agent = create_agent(
    model="deepseek:deepseek-v4-flash",
    tools=[some_tool],
    checkpointer=InMemorySaver(),

    # 在工具节点之前暂停(每次调用工具前都需要审批)
    interrupt_before=["tools"],

    # 在模型节点之后暂停(每次模型回复后都可以检查)
    # interrupt_after=["model"],
)
参数说明
| 参数 | 暂停时机 | 适用场景 |
|---|---|---|
| interrupt_before=["tools"] | 每次执行工具前 | 所有工具调用都需要审批 |
| interrupt_before=["model"] | 每次模型调用前 | 在模型处理前人工审查消息 |
| interrupt_after=["model"] | 每次模型回复后 | 审查模型输出后再决定是否继续 |
| interrupt_after=["tools"] | 每次工具执行后 | 检查工具结果后再决定下一步 |
RAG
RAG(Retrieval-Augmented Generation,检索增强生成)让 AI 能够基于你的私有文档回答问题,不需要微调模型,只需将文档向量化存储,Agent 就能检索相关内容来回答。
RAG 是什么?
普通的大模型只能回答训练数据中有的内容。如果你的文档是私有的(公司内部文档、个人笔记),模型就"不知道"。但是通过 RAG 技术,先将文档数据进行向量化存储,然后在用户提问时,模型可以根据用户的问题,从向量数据库中检索最相似的内容,从而回答用户的问题。
RAG 工程流程
如图所示是 RAG 工程流程: 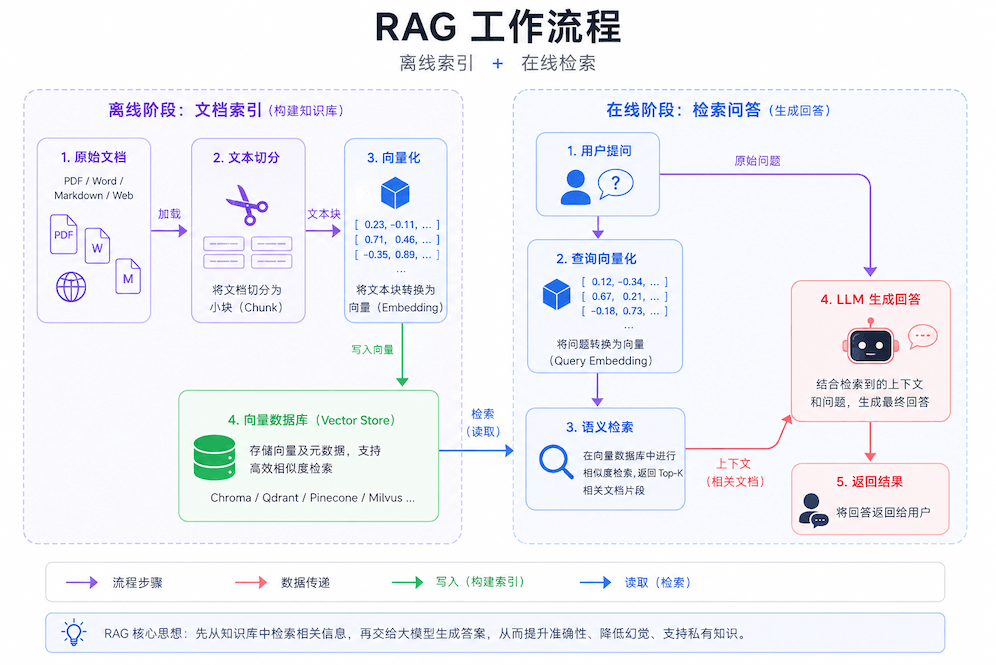
RAG 工程流程分为以下几个阶段:
- 离线阶段(构建向量数据库):先将文档切分成小块数据 → 用 Embedding 模型将文档数据转换为向量 → 存入向量数据库
- 在线阶段(检索问答):用户提问 → 将问题转为向量 → 在向量数据库中搜索最相似的内容 → 将检索到的内容作为上下文发给模型 → 模型基于检索内容回答
示例demo
构建向量数据库的大致流程如下:
- 先使用embedding嵌入模型将文档数据转换为向量数据。
- 然后将向量数据存储到向量数据库中。
以下示例代码中使用的embedding模型是OpenAI 推出的轻量级文本嵌入模型text-embedding-3-small。使用的向量数据库是轻量级的 AI 原生向量数据库 Chroma。
from langchain_openai import OpenAIEmbeddings
from langchain_chroma import Chroma

# 初始化 Embedding 嵌入模型 text-embedding-3-small
embeddings = OpenAIEmbeddings(model="text-embedding-3-small", api_key="xxx",base_url="xxx")

# 创建 Chroma 向量存储库(数据保存在本地目录)
vector_store = Chroma(
    collection_name="xxx_database",    # 向量数据库名称
    embedding_function=embeddings,      # 绑定嵌入模型
    persist_directory="./chroma_db",  # 持久化到本地目录
)

# 添加文档(最简单的形式:文本列表)
texts = [
    "Java 教程一共有 20 章,包含基础语法、面向对象、集合框架等内容。",
    "Python3 基础教程共 30 章,适合零基础入门,包含环境搭建、语法基础、面向对象等内容。",
    "HTML 基础教程共 25 章,覆盖 HTML 标签、表单、多媒体等基础知识。",
]

# add_texts方法会自动将文本转为向量并存储
vector_store.add_texts(texts)

print(f"=========================")

# 语义搜索
results = vector_store.similarity_search(
    "我想学 Python,有什么教程推荐?",
    k=2,  # 返回最相似的 2 个结果
)

print("搜索结果:",enumerate(results))
文档处理
文档加载
LangChain 提供了数十种文档加载器,覆盖常见文件格式:
- TextLoader 加载文本文件(.txt)
- PyPDFLoader 加载PDF 文件(.pdf)
- WebBaseLoader 加载网页内容(.html)
- CSVLoader 加载CSV 文件(.csv)
- UnstructuredMarkdownLoader 加载Markdown 文件(.md)
# 加载文本文件
from langchain_community.document_loaders import TextLoader

loader = TextLoader("AAA笔记.txt", encoding="utf-8")
docs = loader.load()

print(f"加载了 {len(docs)} 个文档")
print(f"内容预览: {docs[0].page_content[:150]}...")

# 加载网页文件
from langchain_community.document_loaders import WebBaseLoader

loader = WebBaseLoader("https://www.runoob.com/python/python-tutorial.html")
docs = loader.load()
print(f"\n网页内容: {docs[0].page_content[:150]}...")
文档切分处理
文档通常太长,需要切分成小块(chunk)才能有效检索。
切分策略
不同的切分策略直接影响检索的效果:
- 文档切分过小,会导致检索效率低。
- 文档切分过大,会导致检索结果不准确。
示例代码
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 创建切分器
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,         # 每块最多 500 个字符
    chunk_overlap=50,       # 块之间重叠 50 个字符
    separators=["\n\n", "\n", "。", "!", "?", ";", ",", " ", ""],
    # 优先按段落分割,然后是句子,最后是字符
)

# 示例文档
long_text = """AAA 是一个免费的编程学习平台。

平台提供了丰富的编程语言教程,包括但不限于:
- Python 教程:从基础语法到数据分析
- Java 教程:面向对象编程到 Spring 框架
- 前端教程:HTML、CSS、JavaScript 及其框架

所有教程都配有详细的代码示例和在线运行环境。
学习者可以通过边学边练的方式快速掌握编程技能。"""

# 切分文档
chunks = text_splitter.split_text(long_text)

print(f"原文长度: {len(long_text)} 字")
print(f"切分后: {len(chunks)} 块\n")

# 打印切分后的块
for i, chunk in enumerate(chunks):
    print(f"--- 块 {i+1} ({len(chunk)} 字) ---")
    print(chunk)
    print()
向量化处理
当把文档进行加载,切分后,需要将切分后的块进行向量化处理,然后将向量数据存储到向量数据库中。
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings
from langchain_chroma import Chroma

# 初始化embedding嵌入模型
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

# 初始化向量数据库
vector_store = Chroma.from_documents(
    documents=chunks,    # 文档块
    embedding=embeddings,    # 向量化模型
    persist_directory="./AAA_db",    # 向量数据库存储路径
)

print(f"已建立索引:{len(chunks)} 个文档块")

# 检索
results = vector_store.similarity_search("Python 教程有多少章?", k=2)
print(f"检索结果: {results}")
RAG Agent
RAG Agent 就是集成向量数据库和大模型的智能体,能够根据用户的问题,从文档中检索相关信息,并生成符合要求的回答。
构建RAG Agent的步骤如下:
- 加载文档并切分。
- 向量化文档块并存储到向量数据库中。
- 初始化大模型。
- 构建RAG Agent。
- 测试RAG Agent。
from langchain_openai import OpenAIEmbeddings
from langchain_chroma import Chroma
from langchain.tools import tool
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage

# 假设已经加载了文档并切分,向量化了文档块并存储到向量数据库中

# 初始化检索器
retriever = vector_store.as_retriever(
    search_type="similarity",
    search_kwargs={"k": 2},
    chunk_overlap=20,
    chunk_size=100,
    chunk_size=100,
)

@tool
def search_knowledge_base(query: str) -> str:
    """检索工具
    Args:
        query: 搜索关键词或问题
    """
    # 执行检索
    docs = retriever.invoke(query)
    if not docs:
        return "知识库中未找到相关信息。"

    results = []
    for i, doc in enumerate(docs, 1):
        results.append(f"[{i}] {doc.page_content}")

    return "\n\n".join(results)


# 创建模型
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0,base_url="xxx",api_key="xxx")
# 创建Agent
modelagent = create_agent(
    model=model,
    tools=[search_knowledge_base], #绑定检索工具
    system_prompt="""你是智能客服助手""",
)

# 测试Agent
questions = [
    "你是什么时候创立的?",
    "Python3 基础教程有多少章?",
]

for q in questions:
    # 执行Agent
    result = modelagent.invoke({"messages": [HumanMessage(content=q)]})
    print(f"问题: {q}")
    print(f"回答: {result['messages'][-1].content}")
    print("-----------------\n")
生态工具链
LangSmith
当 Agent 在后台运行时,你看不到它内部发生了什么——调用了哪些模型、执行了哪些工具、每一步消耗了多少 Token。LangSmith 解决了这个"黑盒"问题。
LangSmith是LangChain的一个子产品,是一个大模型应用开发平台。它提供了从原型到生产的全流程工具和服务,帮助开发者构建、测试、评估和监控基于LangChain的应用程序。
其主要作用包括:
- 执行追踪:记录 Agent 每一步的执行轨迹。
- 性能监控:监控 Agent 执行的性能指标,如响应时间、吞吐量等。
- 调试回放:回放 Agent 执行的每一步,帮助开发者发现和调试错误。