[toc]
LangGraph笔记
LangGraph 官网 https://www.langchain.com/langgraph/
LangGraph 中文文档 https://docs.langchain.org.cn/oss/python/langgraph/overview/
LangGraph 是由 LangChain 团队开发的一个低层的 Agent 编排框架,专为构建有状态(Stateful)、长时运行的 AI 工作流而设计。
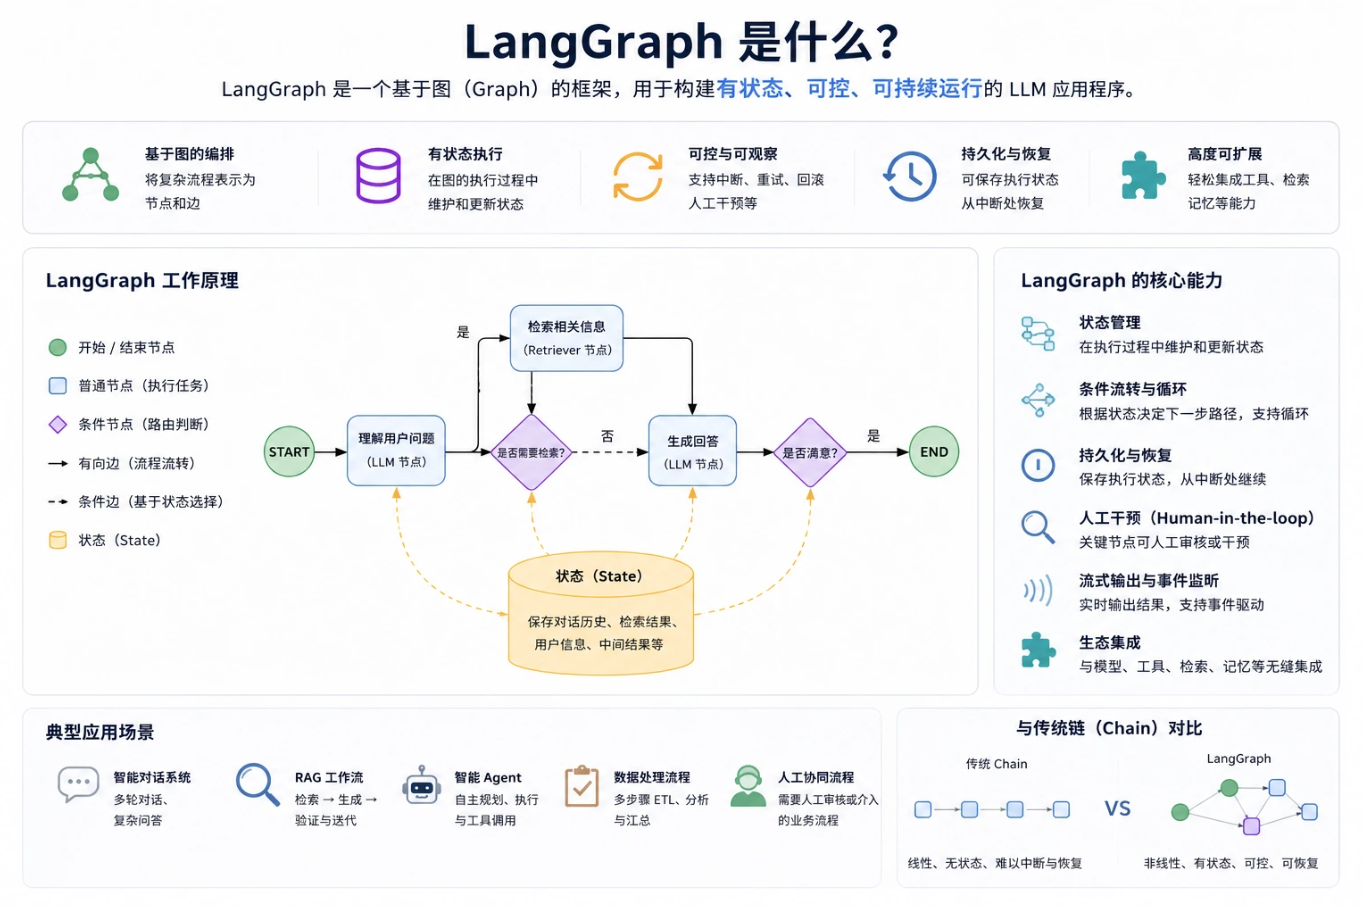
LangGraph 核心特点
LangChain 与 LangGraph 的关系
| 特性 | LangChain | LangGraph |
|---|---|---|
| 定位 | 高层 Agent 框架,开箱即用 | 底层工作流引擎,精细控制 |
| 上手难度 | 低,10 行代码创建 Agent | 中高,需理解图(Graph)概念 |
| 工作流结构 | 线性,单向执行 | 图结构,支持循环 |
| 状态管理 | 需手动管理 | 内置状态持久化 |
| 条件路由 | 实现复杂 | 原生支持 |
| 人机协作 | 需要额外开发 | 内置支持 interrupt |
| 多 Agent 协调 | 实现复杂 | 原生支持 |
| 适用场景 | 标准 Agent 应用、快速原型 | 复杂多步骤工作流、多 Agent 协作 |
例如:LangChain 的 create_agent() 底层构建在 LangGraph 之上。
LangGraph 的应用场景
- 对话机器人:需要记忆多轮对话上下文
- 自主 Agent:能够规划、使用工具、迭代思考
- 多 Agent 系统:多个 AI 协同完成复杂任务
- 审批工作流:需要人工审核的自动化流程
- 研究助手:需要多步骤推理和信息检索
LangGraph 核心概念
与传统的线性 LLM 调用链不同,LangGraph 将工作流建模为有向图(Directed Graph)。为了将工作流表示为图,因此LangGraph 有三个核心概念
- 节点(Node):执行具体操作的函数(如调用 LLM、执行工具、处理数据)
- 边(Edge):定义节点之间的流转路径,支持条件分支
- 状态(State):在整个工作流中共享并传递的数据
如图所示 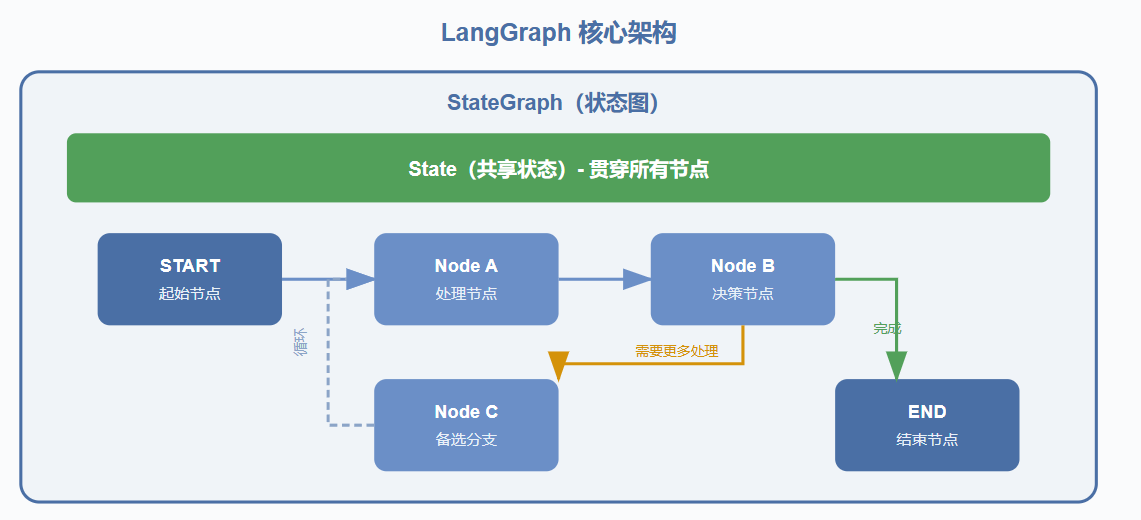
Graph(图)
Graph 图是整个工作流的蓝图,定义了 Agent 的完整逻辑结构。它由节点(Nodes)和边(Edges)组成。
你可以将一个工作流表示为一个有向图,其中每个节点是一个任务或操作,每个边是一个条件或依赖关系。
StateGraph
   |-- Nodes(节点)
   |     |-- node_a
   |     |-- node_b
   |     +-- node_c
   +-- Edges(边)
         |-- START -> node_a
         |-- node_a -> node_b(条件边)
         |-- node_a -> node_c(条件边)
         +-- node_b -> END
State(状态)
State 状态是贯穿整个图的共享数据结构。每个节点可以读取和更新 State,更新后的 State 会传递给下一个节点。
State 状态类似全局共享数据。这使得节点之间可以进行通信和协作。
from typing import TypedDict, Annotated
from langgraph.graph import add_messages

# 定义一个状态类
class MyState(TypedDict):
    messages: Annotated[list, add_messages]   # 消息列表(自动追加)
    name: str                            # 用户名称(普通字段,数据会被直接覆盖)
    age: int                                  # 用户年龄(普通字段,数据会被直接覆盖)
注意:
- name: str 为普通字段类型,若有后续节点更新该字段,则字段值会被直接覆盖。
- Annotated[list, add_messages] 为Annotated类型,若有后续节点更新该字段,则字段值会被追加到列表中而不是覆盖。这是 LangGraph 状态管理的核心机制。
如图是State 状态在整个工作流(图)中传递的过程的示例 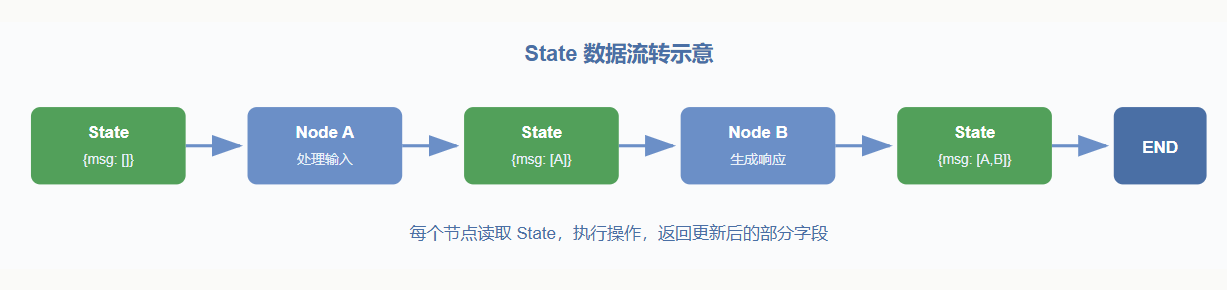
Node(节点)
节点就是普通的 Python 函数,接收当前 State,返回更新后的 State(部分字段)。
注意:节点返回的字段(如 messages)会追加到当前 State的 messages 字段列表中。而不是直接覆盖。
def my_node(state: MyState) -> dict:
    # 读取状态
    messages = state["messages"]

    # 执行操作...
    result = "处理结果"

    # 返回更新的字段(不需要返回所有字段)
    return {"messages": [{"role": "ai", "content": result}]}
Edge(边)
边用来定义节点之间的流转方式。边有如下几种类型:
- 普通边:固定路径,直接从一个节点到另一个节点,没有条件。例如 node_a -> node_b
- 条件边:根据 State 中的条件,从一个节点到另一个节点。例如 node_a -> node_b 或 node_c
- 起始边:即START节点到第一个节点的边。例如 START节点 -> 第一个节点
- 结束边:即某一个节点到END节点的边。例如 最后一个节点 -> END节点
安装
pip install langgraph第一个 LangGraph 程序
从最简单的例子开始。一个只有两个节点的线性工作流。
工作流是:start -> node1 -> node2 -> end
from langgraph.graph import StateGraph, START, END, add_messages
from typing import TypedDict, Annotated
# Step 1: 定义 State
class SimpleState(TypedDict):
    last_node: str                                  # 最近节点,普通类型,后续节点更新的值会直接覆盖
    message_history: Annotated[str, add_messages]   # 消息历史,Annotated列表类型,内部是str类型,后续节点更新的值会追加到列表中

# Step 2: 定义节点1
def node1(state: SimpleState) -> dict:
    """输出state中的数据"""
    print(f"[node1] 收到消息。")
    print(f"最近节点 {state['last_node']}")
    print(f"当前消息历史:")
    for msg in state['message_history']:
        print(msg.content)

    # 更新state中的数据
    state["last_node"] = "node1"
    state["message_history"] = "你好,我是node1节点"

    print("======================")
    return state

# Step 2: 定义节点2
def node2(state: SimpleState) -> dict:
    """输出state中的数据"""
    print(f"[node2] 收到消息。")
    print(f"最近节点 {state['last_node']}")
    print(f"当前消息历史:")
    for msg in state['message_history']:
        print(msg.content)

    # 更新state中的数据
    state["last_node"] = "node2"
    state["message_history"] = "你好,我是node2节点"

    print("======================")
    return state

# Step 3: 构建工作流
workflow = StateGraph(SimpleState)

# 添加节点
workflow.add_node("node1", node1)
workflow.add_node("node2", node2)

# 添加边 start -> node1 -> node2 -> end
workflow.add_edge(START, "node1")
workflow.add_edge("node1", "node2")
workflow.add_edge("node2", END)

# Step 4: 编译工作流,将工作流转换为可执行的图对象
graph = workflow.compile()

# Step 5: 运行图
result = graph.invoke({
    "last_node":"start",
    "message_history": "你好,我是start节点",
})

print(f"\n最终结果: {result}")


# 运行结果
# [node1] 收到消息。
# 最近节点 start
# 当前消息历史:

# 你好,我是start节点
# ======================
# [node2] 收到消息。
# 最近节点 node1
# 当前消息历史:

# 你好,我是start节点
# 你好,我是node1节点
# ======================

# 最终结果: xxx
由上面代码的运行结果可以看出。当工作流从start节点开始时,会先执行node1节点,再执行node2节点,最后返回最终结果。并且在每个节点中,对state中的数据进行了更新并返回。后续节点可以读取到上一个节点更新后的数据。
而state中的Annotated类型字段会在每次更新时,追加到列表中,而不是直接覆盖。这样可以模拟消息历史的累积。
state 状态管理
状态设计要点
- 保持 State 精简,只包含必要字段
- 为复杂字段定义明确的 reducer(如 add_messages)
- 避免在 State 中存储过大的对象,考虑使用外部存储
MessagesState(内置消息状态)
LangGraph 提供了内置的 MessagesState,专为对话消息的场景设计:
from langgraph.graph import MessagesState

# 直接使用,无需自定义
builder = StateGraph(MessagesState)

# MessagesState 等价于:
# class MessagesState(TypedDict):
#     messages: Annotated[list[AnyMessage], add_messages]
从代码中可以看到MessagesState中只有一个字段messages,这是一个Annotated列表类型,内部是AnyMessage类型。
而AnyMessage类型就是langchain中的各个消息的合集。即HumanMessage、AIMessage、SystemMessage等。
Node 节点
节点设计要点
- 每个节点职责单一,便于测试和复用
- 节点函数应该是幂等的(相同输入产生相同输出)
- 避免在节点中直接修改传入的 state,而是返回新值
- 合理使用异步节点处理 I/O 密集型操作
节点中调用模型
在节点函数中调用模型,获取模型结果,并将结果更新到state中。
from langchain_openai import ChatOpenAI
from langchain_core.messages import SystemMessage

# 初始化模型
model = ChatOpenAI(xxx)

def use_model(state: SimpleState) -> dict:
    """调用 LLM 的节点"""

    # 定义系统提示词
    system_prompt = SystemMessage(content="你是一个有帮助的助手。")

    # 将系统提示与state中的对话历史合并
    messages = [system_prompt] + state["messages"]

    # 调用模型获取响应结果
    response = model.invoke(messages)

    # 更新state中的对话历史
    state["messages"] = messages + [response]

    # 返回更新后的state
    return state
类节点
节点除了可以是普通函数,还可以是类。类节点可以在节点函数中定义自己的属性和方法。
示例代码
from langchain_core.messages import AnyMessage
from langgraph.graph import StateGraph, START, END, add_messages
from typing import TypedDict, Annotated

# Step 1: 定义 State
class SimpleState(TypedDict):
    last_node: str                                  # 最近节点,普通类型,后续节点更新的值会直接覆盖
    message_history: Annotated[str, add_messages]   # 消息历史,Annotated列表类型,内部是str类型,后续节点更新的值会追加到列表中

# Step 2: 定义类节点1
class Node1:
    def __init__(self):
        self.last_node = "node1"
        self.message_history = "你好,我是node1节点"

    def __call__(self, state: SimpleState) -> dict:
        """类实例可以作为节点使用"""
        print(f"[node1] 收到消息。")
        print(f"最近节点 {state['last_node']}")
        print(f"当前消息历史:")
        for msg in state['message_history']:
            print(msg.content)

        # 更新state中的数据
        state["last_node"] = self.last_node
        state["message_history"] = self.message_history

        print("======================")
        return state


# Step 2: 定义类节点2
class Node2:
    def __init__(self):
        self.last_node = "node2"
        self.message_history = "你好,我是node2节点"

    def __call__(self, state: SimpleState) -> dict:
        """类实例可以作为节点使用"""
        print(f"[node2] 收到消息。")
        print(f"最近节点 {state['last_node']}")
        print(f"当前消息历史:")
        for msg in state['message_history']:
            print(msg.content)

        # 更新state中的数据
        state["last_node"] = self.last_node
        state["message_history"] = self.message_history

        print("======================")
        return state

# Step 3: 构建工作流
workflow = StateGraph(SimpleState)

# 初始化类节点对象
node1 = Node1()
node2 = Node2()

# 添加类节点
workflow.add_node("node1", node1)
workflow.add_node("node2", node2)

# 添加边 start -> node1 -> node2 -> end
workflow.add_edge(START, "node1")
workflow.add_edge("node1", "node2")
workflow.add_edge("node2", END)

# Step 4: 编译工作流,将工作流转换为可执行的图对象
graph = workflow.compile()

# Step 5: 运行图
result = graph.invoke({
    "last_node":"start",
    "message_history": "你好,我是start节点",
})

print(f"\n最终结果: {result}")
Edge 边
普通边
普通边就是一条路径,即从一个节点到另一个节点的路径。
通过add_edge方法可以给两个节点之间添加一条边。
示例代码
# 将start节点连接到node1节点
workflow.add_edge(START, "node1")
# 将node1节点连接到node2节点
workflow.add_edge("node1", "node2")
# 将node2节点连接到end节点
workflow.add_edge("node2", END)
条件边
条件边是 LangGraph 的核心功能,根据当前 State 动态决定下一步。
条件边就是有条件判断的边。通过add_conditional_edges方法可以添加条件边。
add_conditional_edges 方法
add_conditional_edges(源节点,条件函数,条件映射)
- 源节点:条件边的起点节点。
- 条件函数:用于判断是否执行条件边的函数。
- 条件映射:一个字典,键是条件函数的返回值,值是目标节点。

因此这个条件边的执行路径是:源节点 -> 条件函数 -> 条件映射 -> 目标节点。

根据条件函数的返回值,对应条件映射的值来选择不同的目标节点。
示例代码
import random
from langchain_core.messages import AnyMessage
from langgraph.graph import StateGraph, START, END, add_messages
from typing import TypedDict, Annotated

# Step 1: 定义 State
class SimpleState(TypedDict):
    last_node: str                                  # 最近节点,普通类型,后续节点更新的值会直接覆盖
    message_history: Annotated[str, add_messages]   # 消息历史,Annotated列表类型,内部是str类型,后续节点更新的值会追加到列表中

# Step 2: 定义节点1
class Node1:
    def __init__(self):
        self.last_node = "node1"
        self.message_history = "你好,我是node1节点"

    def __call__(self, state: SimpleState) -> dict:
        """类实例可以作为节点使用"""
        print(f"[node1] 收到消息。")
        print(f"最近节点 {state['last_node']}")
        print(f"当前消息历史:")
        for msg in state['message_history']:
            print(msg.content)

        # 更新state中的数据
        state["last_node"] = self.last_node
        state["message_history"] = self.message_history

        print("======================")
        return state


# Step 2: 定义节点2
class Node2:
    def __init__(self):
        self.last_node = "node2"
        self.message_history = "你好,我是node2节点"

    def __call__(self, state: SimpleState) -> dict:
        """类实例可以作为节点使用"""
        print(f"[node2] 收到消息。")
        print(f"最近节点 {state['last_node']}")
        print(f"当前消息历史:")
        for msg in state['message_history']:
            print(msg.content)

        # 更新state中的数据
        state["last_node"] = self.last_node
        state["message_history"] = self.message_history

        print("======================")
        return state

# 定义路由函数
def is_radom(state: SimpleState) -> bool:
    """随机返回True或False"""
    a = random.choice([True, False])
    print(f"is_random 函数随机结果 {a}")
    print("======================")
    return a

# Step 3: 构建工作流
workflow = StateGraph(SimpleState)

# 初始化节点对象
node1 = Node1()
node2 = Node2()

# 添加节点
workflow.add_node("node1", node1)
workflow.add_node("node2", node2)

# 添加边 start -> node1
workflow.add_edge(START, "node1")
# 添加条件边,如果is_radom函数返回True,则node1->node2,否则node1->END
workflow.add_conditional_edges("node1", is_radom, {True: "node2", False: END})
# 添加边 node2 -> end
workflow.add_edge("node2", END)

# Step 4: 编译工作流,将工作流转换为可执行的图对象
graph = workflow.compile()

# Step 5: 运行图
result = graph.invoke({
    "last_node":"start",
    "message_history": "你好,我是start节点",
})

print(f"\n最终结果: {result}")

# 运行结果1  ,当is_radom返回True时
# [node1] 收到消息。
# 最近节点 start
# 当前消息历史:

# 你好,我是start节点
# ======================
# is_random 函数随机结果 True
# ======================
# [node2] 收到消息。
# 最近节点 node1
# 当前消息历史:

# 你好,我是start节点
# 你好,我是node1节点
# ======================

# 运行结果2  ,当is_radom返回False时
# [node1] 收到消息。
# 最近节点 start
# 当前消息历史:

# 你好,我是start节点
# ======================
# is_random 函数随机结果 False
# ======================
上面示例代码中,添加条件边,如果is_radom函数返回True,则node1->node2,否则node1->END
workflow.add_conditional_edges("node1", is_radom, {True: "node2", False: END})并行边,汇聚边
并行边的意思就是,从一个源节点出发,并行分叉到多个目标节点。以及从多个目标节点出发,再并行汇聚到一个目标节点。
# 从一个节点并行分叉到多个节点
builder.add_edge("start_node", "branch_a")
builder.add_edge("start_node", "branch_b")
builder.add_edge("start_node", "branch_c")

# 多个节点汇聚到一个节点
builder.add_edge("branch_a", "merge_node")
builder.add_edge("branch_b", "merge_node")
builder.add_edge("branch_c", "merge_node")
对话机器人Demo
现在用所学知识构建一个支持多轮对话的机器人。这个机器人能够记住对话上下文,实现连续的交互体验。
代码逻辑如下:
- 上下文也就是历史对话列表,是通过MessagesState进行存储的。主要用来存储用户的输入和机器人的回复。
- 工作流的图是:START -> chatbot -> END。通过不断的循环来调用工作流。
- 工作流中,每次用户输入的对话,就会被加入到对话历史列表中。机器人根据对话历史列表,进行回复。
- 机器人每次回复完成后,也将回复也加入到对话历史列表中。
示例代码
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START, END
from langchain_core.messages import SystemMessage, HumanMessage

# 初始化模型
model = init_chat_model(
    api_key="sk-bd30de7694584c1ea4097b8be2aae92d",  # 阿里云大模型的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 阿里云大模型的API地址
    model="deepseek:deepseek-v4-flash",  # 模型
)

# 构建chatbot_node节点
def chatbot_node(state: MessagesState) -> dict:
    """核心对话节点"""
    system = SystemMessage(content="你是一个友善、专业的 AI 助手。你的回答应该:简洁清晰,使用中文回复,在不确定时主动询问用户。")
    # 构建消息列表,包括系统提示和用户输入
    messages = [system] + state["messages"]
    response = model.invoke(messages)
    return {"messages": [response]}


# 构建图
# 图中的边 START -> chatbot -> END
builder = StateGraph(MessagesState)
builder.add_node("chatbot", chatbot_node)
builder.add_edge(START, "chatbot")
builder.add_edge("chatbot", END)
graph = builder.compile()


# 对话历史列表
conversation_history = []
# 循环处理用户输入
while True:
    # 用户输入的对话
    user_input = input("用户: ")
    # 如果用户输入 退出,exit quit 等字符,则退出程序
    if user_input.lower() in ["退出", "exit", "quit"]:
        print("再见!")
        break

    """处理单轮对话,返回 AI 响应和更新后的历史"""

    # 将用户输入的对话,转化为HumanMessage对象,加入到对话历史列表中
    conversation_history.append(HumanMessage(content=user_input))

    print(f"当前对话历史:")
    for index, message in enumerate(conversation_history):
        print(f"对话{index+1}: ===== {message.content}")
    print("\n")

    # 调用模型,传入对话历史列表,获取模型回复
    response = graph.invoke({"messages": conversation_history})
    # 获取模型回复的messages字段,包含所有的对话历史。直接赋值给对话历史列表中
    conversation_history = response["messages"]
    # 获取模型最新回复的内容,所以是-1
    ai_response = conversation_history[-1].content
    print(f"助手: {ai_response}\n")
运行结果
用户: 你是谁?
当前对话历史:
对话1: ===== 你是谁?

助手: 我是一个友善、专业的AI助手,可以帮你解答问题、提供建议或处理任务。如果有任何需要,请随时告诉我!

用户: 1+1=?
当前对话历史:
对话1: ===== 你是谁?
对话2: ===== 我是一个友善、专业的AI助手,可以帮你解答问题、提供建议或处理任务。如果有任何需要,请随时告诉我!
对话3: ===== 1+1=?

助手: 1+1=2。

用户: 18*18=?
当前对话历史:
对话1: ===== 你是谁?
对话2: ===== 我是一个友善、专业的AI助手,可以帮你解答问题、提供建议或处理任务。如果有任何需要,请随时告诉我!
对话3: ===== 1+1=?
对话4: ===== 1+1=2。
对话5: ===== 18*18=?

助手: 18×18=324。

用户: 中国的首都是哪里?
当前对话历史:
对话1: ===== 你是谁?
对话2: ===== 我是一个友善、专业的AI助手,可以帮你解答问题、提供建议或处理任务。如果有任何需要,请随时告诉我!
对话3: ===== 1+1=?
对话4: ===== 1+1=2。
对话5: ===== 18*18=?
对话6: ===== 18×18=324。
对话7: ===== 中国的首都是哪里?

助手: 中国的首都是北京。

用户: exit
再见!
对话记忆 Checkpointer
langgraph 也可以通过 Checkpointer(检查点保存器)来实现对话记忆。
示例代码
from langgraph.checkpoint.memory import MemorySaver

# 创建内存存储器,用于记忆数据
checkpointer = MemorySaver()

# 初始化图,设置Checkpointer参数,表示该图使用内存保存器来存储数据。
graph = builder.compile(checkpointer=checkpointer)

# 使用 thread_id 区分不同会话
config_user_a = {"configurable": {"thread_id": "user-alice"}}
config_user_b = {"configurable": {"thread_id": "user-bob"}}

# Alice 的对话
graph.invoke({"messages": [HumanMessage(content="我叫 Alice")]}, config=config_user_a)
graph.invoke({"messages": [HumanMessage(content="我叫什么名字?")]}, config=config_user_a)
# Agent 能记住:你叫 Alice

# Bob 的对话完全独立
graph.invoke({"messages": [HumanMessage(content="我叫什么名字?")]}, config=config_user_b)
# Agent 不知道 Bob 的名字(不同 thread_id)


# 获取某个 thread 的完整状态历史
history = list(graph.get_state_history(config))
for snapshot in history:
    print(f"时间: {snapshot.created_at}")
    print(f"消息数: {len(snapshot.values['messages'])}")
    print("---")

# 获取当前状态
current_state = graph.get_state(config)
print(f"当前消息数: {len(current_state.values['messages'])}")
代码中的 thread_id 是会话的唯一标识符,用于隔离不同用户或不同对话的状态。同一个 thread_id 的所有调用会共享对话历史,不同 thread_id 之间完全独立。在多用户场景中,通常使用用户 ID 或会话 ID 作为 thread_id。
多 Agent 智能体
LangGraph 擅长协调多个专门化的 Agent 协同工作。通过将复杂任务分解给不同的专家 Agent,可以实现更强大的问题解决能力。
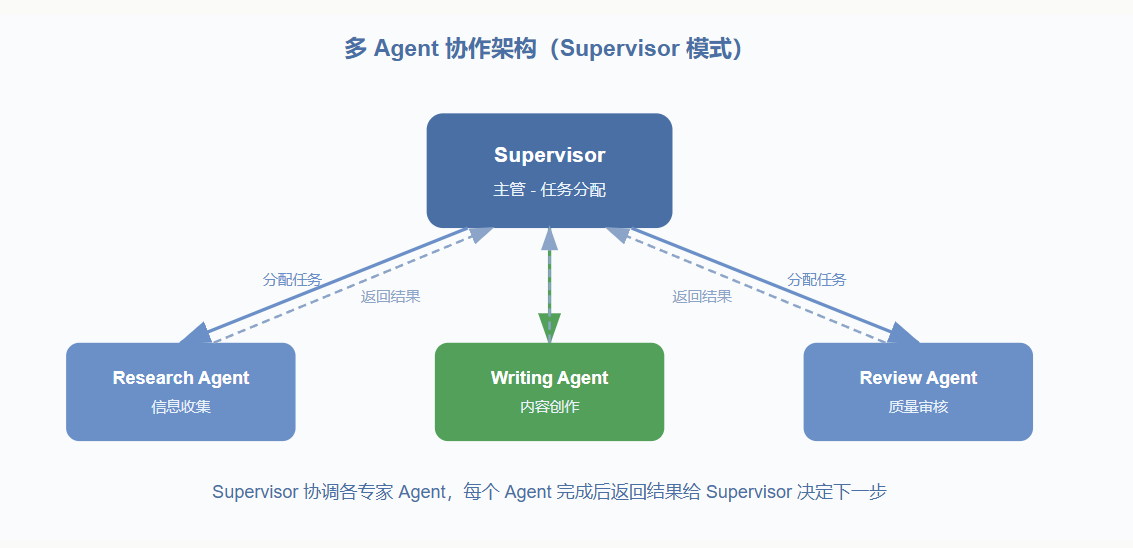
参考上面图中的流程,示例代码如下。
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START, END
from langchain_core.messages import SystemMessage, HumanMessage

# 初始化 LLM
llm = init_chat_model(
    api_key="sk-xxxx",  # 阿里云大模型的API key
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",  # 阿里云大模型的API地址
    model="deepseek:deepseek-v4-flash",  # 模型
)


# 定义研究 Agent ,负责信息收集
def research_agent(state: MessagesState) -> dict:
    """研究 Agent:负责信息收集"""
    system = SystemMessage(content="你是一个专业的研究员,负责收集和整理信息。请简洁地总结关键信息。")
    response = llm.invoke([system] + state["messages"])
    return {"messages": [response]}

# 定义写作 Agent
def writing_agent(state: MessagesState) -> dict:
    """写作 Agent:负责内容创作"""
    system = SystemMessage(content="你是一个专业的写作者,负责根据已有信息撰写内容。请保持内容清晰流畅。")
    response = llm.invoke([system] + state["messages"])
    return {"messages": [response]}

# 定义审校 Agent
def review_agent(state: MessagesState) -> dict:
    """审校 Agent:负责质量控制"""
    system = SystemMessage(content="你是一个专业的编辑,负责审核和改进内容质量。请指出问题并给出改进建议。")
    response = llm.invoke([system] + state["messages"])
    return {"messages": [response]}


# 定义主管 Agent ,负责协调各 Agent 的工作
def supervisor_node(state: MessagesState) -> dict:
    """主管:协调各 Agent 的工作"""
    system = SystemMessage(content="""你是一个工作流主管。
                            根据任务进度决定下一步应该由哪个 Agent 处理。
                            分析对话历史,只返回以下之一:RESEARCH、WRITING、REVIEW、FINISH
                            - RESEARCH:需要收集更多信息
                            - WRITING:信息充足,可以开始写作
                            - REVIEW:写作完成,需要审核
                            - FINISH:任务已完成
                                            """)
    response = llm.invoke([system] + state["messages"])
    return {"messages": [response]}

# 定义路由函数,根据主管的决策,将任务分配给不同的 Agent
def route_by_supervisor(state: MessagesState) -> str:
    """根据主管决策路由"""
    last_msg = state["messages"][-1].content.strip().upper()

    if "RESEARCH" in last_msg:
        return "research"
    elif "WRITING" in last_msg:
        return "writing"
    elif "REVIEW" in last_msg:
        return "review"
    else:
        return END


# 构建多 Agent 图
graph = StateGraph(MessagesState)
# 添加节点
graph.add_node("supervisor", supervisor_node)
graph.add_node("research", research_agent)
graph.add_node("writing", writing_agent)
graph.add_node("review", review_agent)


# 注意下面构造的是这种循环结构
"""
# ════════════════════════════════════════════════════════════════
#        ┌─────────────┐
#        │    START    │
#        └──────┬──────┘
#               │
#               ▼
#        ┌─────────────┐
#        │ supervisor  │◄──────────────────────——————————┐
#        │  (主管决策)  │                                 │
#        └──────┬──────┘                                │
#               │ (条件边 route_by_supervisor,模型分配)   │
#    ┌──────────┼──────────┐                            │
#    ▼          ▼          ▼                            │
# ┌───────┐ ┌───────┐ ┌───────┐                         │
# │research│ │writing│ │ review│                        │
# │ (调研) │ │ (写作) │ │ (审核) │                        │
# └───┬───┘ └───┬───┘ └───┬───┘                         │
#     │          │          │                           │
#     └──────────┴──────────┘                           │
#                │                                      │
#                └───────────────►──────────────————————┘
#                              (循环回到主管节点继续决策)
# ════════════════════════════════════════════════════════════════
"""

# 添加边
graph.add_edge(START, "supervisor")
# 添加条件边
graph.add_conditional_edges("supervisor", route_by_supervisor)
# 添加边
graph.add_edge("research", "supervisor")
# 添加边
graph.add_edge("writing", "supervisor")
# 添加边
graph.add_edge("review", "supervisor")

# 编译图,生成工作流对象
workflow = graph.compile()

# 测试多 Agent 协作
result = workflow.invoke({
    "messages": [HumanMessage(content="请帮我写一篇关于 Python 装饰器的简短介绍文章")]
})

print("=== 多 Agent 协作完成 ===")
for i, msg in enumerate(result["messages"]):
    print(f"\n[{i + 1}] {msg.type}: {msg.content[:150]}...")