[toc]
系统分析师笔记19_大数据处理系统分析与设计
该笔记内容来自《系统分析师教程》第2版。
大数据处理系统概述
大数据处理系统是一种高效、综合的数据处理平台,旨在处理和分析海量数据。
系统采用分布式存储技术,能够从多个数据源自动收集数据,提供数据预处理、清洗、去重、转换和压缩等一系列功能,提高数据质量和准确性。通过可视化技术,将数据呈现给用户,帮助用户更好地理解和发现规律和趋势。
此外,系统还提供数据检索和查询功能,方便用户快速获取所需数据。最重要的是,系统采用数据挖掘和分析技术,对数据进行深入挖掘和分析,为用户提供决策支持和依据。
大数据处理系统能够实现对海量数据的全面处理和分析,为各行各业的用户提供有力的数据支持和决策依据。
大数据处理系统在许多领域都有广泛的应用,包括商业智能、金融风险分析、市场营销、医疗保健、社交媒体分析等。这些系统帮助组织和企业从海量数据中提取有用的信息,支持数据驱动的决策和业务创新。
大数据处理系统架构
大数据具有数据量大(Volume)、数据类型多样(Variety)、产生与处理速度快(Velocity)、价值高(Value)的“4V”特性,构建和设计大数据处理系统架构时应考虑大数据本身的特性。
以下为通用设计原则。
可扩展
大数据处理系统架构的可扩展原则是指系统在设计时应考虑如何轻松容纳不断增长的数据量和处理能力需求。
实现可扩展原则有两个关键要点:
- 分布式环境
- 模块化设计
可管理
大数据处理系统架构的可管理原则是指通过设计和实现一组有效的管理策略和方法,以便在大数据环境下实现数据处理系统的高效管理和监控。
数据安全
在大数据处理系统架构中,数据安全原则是至关重要的,因为处理的数据量巨大,数据的安全性和隐私保护需要得到高度的重视。
实现数据安全原则,可以从以下5个方面入手。
- 数据加密
- 访问控制
- 数据备份和恢复
- 审计日志
- 持续监控
高性能
大数据处理系统架构的高性能原则是指通过有效的架构设计和实现,提高系统的性能和吞吐量,从而能够快速高效地处理大量数据。实现高性能的方式包括数据分区、分布式计算、并行处理、内存计算。
高可用
大数据处理系统架构的高可用原则是指通过一系列有效的技术和策略,保证系统在面对各种故障和异常情况时能够继续保持可用状态。这些原则包括数据冗余、自动故障转移、负载均衡等。
稳定性
数据处理系统架构的稳定性原则是指通过监控和预警、性能调优、故障排除和升级等一系列有效的技术和策略,保证系统能够在长时间运行和高负载情况下保持稳定和可靠。
大数据处理系统架构类型
根据数据处理方式分为不同的类别。
批处理架构
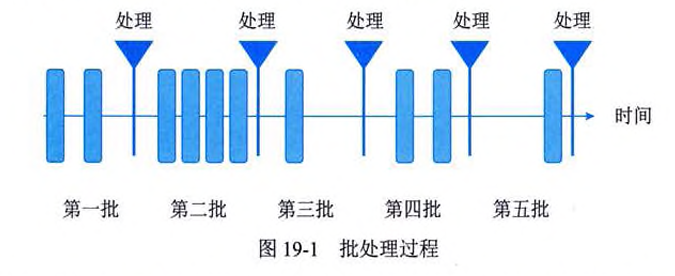
批处理架构是一种数据处理系统架构类型,它主要用于处理大规模数据的批量处理任务,该任务通常在离线模式下执行,具有较高的吞吐量和较低的实时性。
批处理架构通常包括数据采集、数据存储、数据处理和数据输出等四个核心模块。
在批处理架构中,大数据集被划分为多个数据组,整个组在未来的时间进行处理。何时处 理每个组可以用多种方式来确定。
流处理架构
流处理架构是指数据以连续的、无限制的方式流式处理,即每条新数据都会在到达时进行处理,而不是像批处理架构一样按照固定的时间间隔来处理。
流处理过程如图19-2所示。 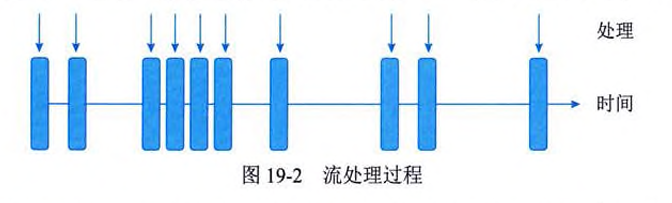
混合架构
混合系统架构是指同时使用批处理和流处理的架构。混合系统结合了批处理和流处理架构的优点,可以在需要时处理历史数据,同时也可以处理实时数据。
混合系统架构的优点在于能够兼顾批处理和流处理架构的优点,可以处理历史数据和实时数据,并且能够快速响应用户请求。但是,混合系统架构需要在架构和数据处理上进行权衡,并且需要付出更多的管理和维护成本。
大数据处理系统架构模式
大数据处理系统开发
大数据处理系统开发指的是通过大数据技术构建一个大数据处理系统的过程。
数据存储
大数据处理系统以数据的分析处理作为核心功能,其首先必须具备强大的数据存储能力。
数据存储的流程一般分为4个部分进行描述,分别是数据采集、数据清洗、数据转换和数据存储。当数据途经以上4个步骤之后,其规范性、完整性以及合理性会得到进一步的保证,后续大数据处理系统的数据分析功能才能够更好地完成。
数据采集
在大数据处理系统中,数据采集都是一个非常重要的部分:主要负责数据的输入。
常用的大数据处理系统的数据采集主要分为以下三种采集模式:
- 离线采集
- 实时采集
- 互联网采集(如网络爬虫采集)
数据清洗
数据清洗,是整个数据分析过程中不可缺少的一个环节,其结果质量直接关系到模型效果和最终结论。
在实际操作中,数据清洗通常会占据分析过程的50%~80%的时间。
数据清洗的基本流程一共分为5个步骤,分别是数据分析、定义数据清洗的策略和规则、搜寻并确定错误实例、纠正发现的错误以及干净数据回流。
数据转换
将抽取出来的数据进行处理,并且将数据映射到仓库模型的维度(如时间、地点、产品等)和度量(如销售额、利润等)上。在这个过程中,需要进行数据清洗,如去除重复数据、数据类型转换等,以及数据规范化、合并、拆分等操作。
数据转换的主要目的是将数据转换为可用格式,数据转换其实就是ETL过程的一部分。ETL从多个源中提取和转换数据是一个数据转换过程,并将其加载到数据仓库或其他目标系统中。
在大数据处理系统中将数据转换的行为描述为6个步骤,分别是数据发现、数据映射、数据提取、代码生成、代码执行、数据审查。
数据发现
在数据转换的第一步中,使用数据分析工具或手动分析脚本来分析数据。这有助于更好地理解数据的特征和结构,从而决定如何转换数据。
数据映射
数据映射涉及定义如何映射、连接、聚合、修改或过滤每个字段以生成最终输出。它通常是在数据映射软件的帮助下进行的。数据映射通常是数据转换过程中最耗时、最昂贵的步骤。
数据提取
在这一步中,数据是从原始来源中提取的。如上所述,来源可能有很大的差异,也可能包括结构化来源。
代码生成
这一步涉及以Python、R 或S Q L 等待语言生成可执行代码。可执行代码将根据定义的数据映射规则转换数据。
代码执行
在此步骤中,生成的代码在数据上执行,以将其转换为所需格式。
数据审查
在数据转换的最后一步中,检查输出数据是否符合转换要求。此步骤通常由数据的最终用户或业务用户执行。此步骤中发现的异常或错误将传达给数据分析师或开发人员。
数据存储
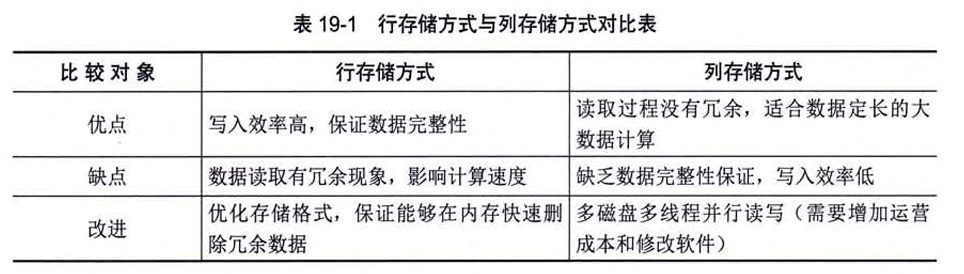
数据存储是大数据处理系统的核心功能,只有提供安全稳定的数据存储能力,数据分析的结果才能得到有效的存储和收集。目前,大数据存储有两种方案可供选择:行存储和列存储。
数据管理
数据管理是系统中必不可少的非功能模块之一,主要负责系统数据整体的稳定性和安全性,同时提供一些系统的监控指标作为系统的功能情况进行反映。
在大数据处理系统中,数据管理通常分为以下4部分,分别是元数据管理、数据关系图谱、数据安全和资源监控。
数据处理
从数据类型角度,将大数据处理中的数据类型分为以下3种:
- 结构化数据一般指关系数据库的数据,具有固定的数据模式。
- 半结构化数据指具有一定的数据结构但数据模式不固定,如JSON、XML、HTML、日志文件;
- 非结构化数据指图片、视频、文本、语音等。
从大数据处理系统的数据处理方式来看,将大数据处理中的处理方式分为两种类型,即离线数据处理和实时数据处理。
- 离线数据处理是利用离线同步工具通过定时任务将数据从数据源按照全量和增量形式同步到离线存储平台Hive中。
- 实时数据处理一般是埋点、日志数据、binlog以及nsq消息等通过实时同步工具同步到Kafka平台中。
数据分析
目前,大数据处理系统的数据分析给各行各业都提供了强大的信息支持,帮助很多行业实现了数字化和智能化的转型,加快了企业的发展,帮助企业更好地进行分析决策和解决问题。
机器学习
搜索推荐
数据可视化
系统部署
大数据处理系统的部署是个复杂的过程,涉及内容众多,但无论如何都是以需求为导向的。
所以,首先需要从需求中抽取出影响点,如实际运行时大概的数据量,实时性要求,高可用方 面的要求,等等。
大数据处理系统测试
通过对大数据处理系统进行全面的测试,可以验证其功能、性能、可靠性和安全性,以确保系统能够有效地处理和分析海量数据,并提供准确和有价值的结果。
测试可以帮助发现潜在的问题和缺陷,并为系统的优化和改进提供反馈和指导。
根据测试内容的不同,大数据处理系统测试主要包括功能测试、性能测试、可靠性和容错性测试、安全性测试、兼容性测试等内容。